什麼是合併標準差?
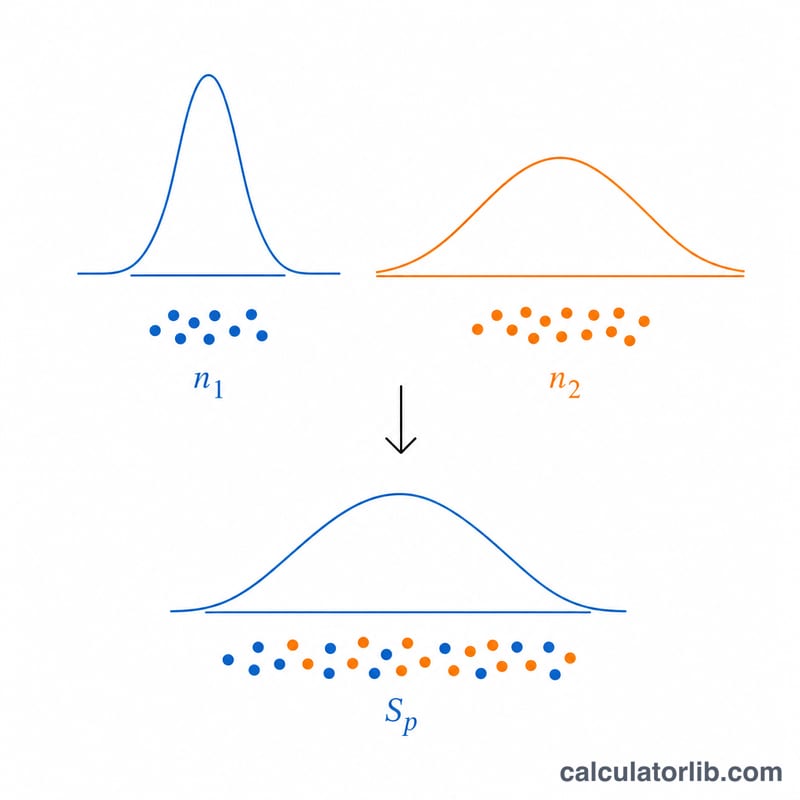
合併標準差(Pooled Standard Deviation,Sp)是把兩組樣本的標準差做加權平均,整合成單一的估計值,用來推估兩個母體共同的標準差。當你假設兩組獨立樣本來自「變異數相同」的母體時,就會用到它。合併估計值在雙樣本 t 檢定、Cohen's d 效果量,以及兩平均數差的信賴區間中,都扮演關鍵角色。
如何使用這個計算器
請輸入每組樣本的樣本數(\(n_1\) 與 \(n_2\))以及各自的標準差(\(s_1\) 與 \(s_2\))。計算器會回傳合併標準差、合併變異數(\(S_p^2\))以及自由度(\(n_1 + n_2 - 2\))。每組樣本至少要有兩筆觀測值,自由度才會維持為正數。
公式解析
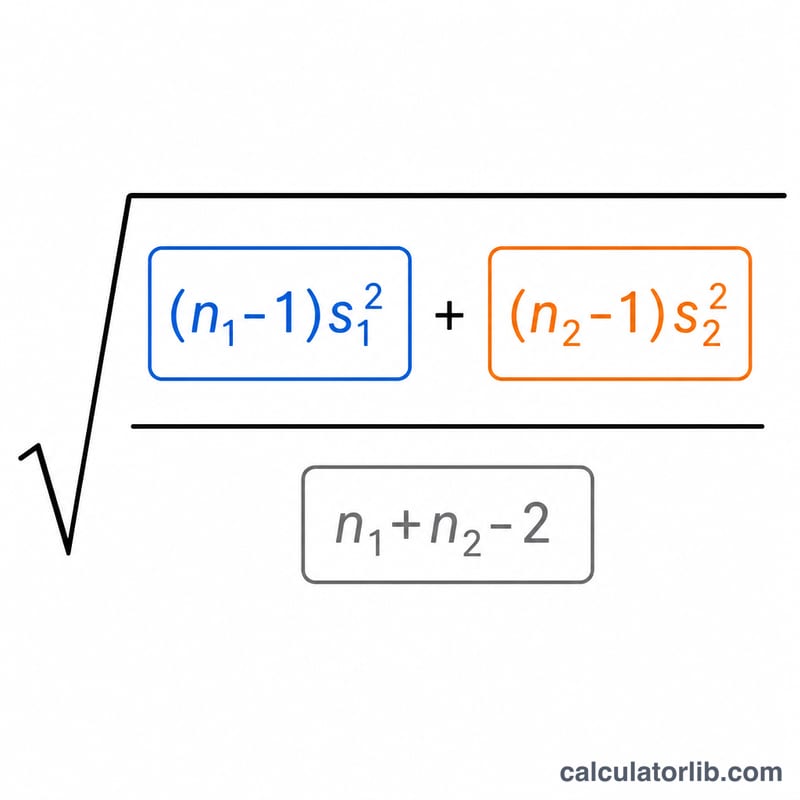
合併變異數會依各組的自由度(\(n - 1\))對其變異數加權:
$$S_p^2 = \frac{(n_1 - 1)\,s_1^{2} + (n_2 - 1)\,s_2^{2}}{n_1 + n_2 - 2}$$
再開平方根,就得到合併標準差 \(S_p\)。樣本數較大的一組會對合併估計值貢獻較多,這也是為什麼要「加權」而非單純平均兩個變異數的原因。
範例試算
假設樣本 1 的 \(n_1 = 10\)、\(s_1 = 5\),樣本 2 的 \(n_2 = 12\)、\(s_2 = 6\)。則 \((10-1)\cdot 25 = 225\),\((12-1)\cdot 36 = 396\),兩者相加為 \(621\)。自由度為 \(10 + 12 - 2 = 20\),因此 \(S_p^2 = 621 / 20 = 31.05\),$$S_p = \sqrt{31.05} \approx 5.5722$$
合併標準差在各情境中的變化
合併變異數是兩個樣本變異數的加權平均,權重等於各樣本的自由度:\(S_p^2 = \dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}\)。表格將此公式應用於四種情境。
| 情境 | n₁ | s₁ | n₂ | s₂ | 合併變異數 | Sp | 自由度 |
|---|---|---|---|---|---|---|---|
| A. 樣本數相等,標準差不同 | 20 | 4 | 20 | 8 | (19·16 + 19·64)/38 = 40 | 6.3246 | 38 |
| B. 樣本數不等,較大樣本佔主導 | 10 | 5 | 40 | 10 | (9·25 + 39·100)/48 = 85.9375 | 9.2702 | 48 |
| C. 標準差相同 | 12 | 6 | 30 | 6 | (11·36 + 29·36)/40 = 36 | 6 | 40 |
| D. 小樣本但標準差較大 | 8 | 12 | 50 | 4 | (7·144 + 49·16)/56 = 32 | 5.6569 | 56 |
- 情境 A:樣本數相等時,Sp 為兩個標準差的均方根:\(\sqrt{(4^2+8^2)/2} = \sqrt{40} \approx 6.3246\)。這大於 6 的簡單平均值。
- 情境 B:第二個樣本的觀測值數量是第一個的四倍,因此 Sp(9.27)遠比 s₁ = 5 更接近 s₂ = 10。
- 情境 C:當 s₁ = s₂ 時,權重不影響結果,Sp 等於該共同標準差,與樣本數無關。
- 情境 D:50 個觀測值的樣本標準差較小,因此 Sp(5.66)被拉向 4,儘管小樣本的標準差大得多,為 12。
解讀合併標準差
- 總是介於 s₁ 與 s₂ 之間:由於 Sp² 是 s₁² 與 s₂² 的加權平均(權重為正),\(\min(s_1, s_2) \le S_p \le \max(s_1, s_2)\)。只有當 s₁ = s₂ 時,兩者才會相等。
- 共同標準差的估計值:假設兩個母體具有相同變異數 σ²,則 Sp² 是 σ² 的合併估計值。它利用了兩個樣本的資訊,因此比單獨任一 s 更穩定。
- 平均數差的標準誤:$$SE = S_p\sqrt{\frac{1}{n_1}+\frac{1}{n_2}}$$ 在情境 A 中,\(SE = \sqrt{40}\cdot\sqrt{0.1} = \sqrt{4} = 2\)。
- Cohen's d:$$d = \frac{\bar{x}_1 - \bar{x}_2}{S_p}$$ 在情境 A 中,平均數差為 5 時,\(d = 5/6.3246 \approx 0.79\)。
- 自由度:\(df = n_1 + n_2 - 2\) 是合併(學生)雙樣本 t 檢定中 t 分配的自由度。情境 A 的 df = 38,情境 B 的 df = 48。
- 檢查等變異數假設:一般經驗法則是,若較大的標準差超過較小標準差的約 2 倍(變異數比超過約 4),合併便值得商榷。當樣本數不同時尤其如此。此時通常改用不合併變異數的韋爾奇 t 檢定(Welch's t-test)。情境 A 的標準差比恰為 2,情境 D 的比為 3。
計算慣例與邊界情況
以下每個情況都在本計算機上實際執行過,結果欄就是它真正回傳的值。
| 情況 | 輸入 | 結果 |
|---|---|---|
| 10 人和 12 人兩組(標準差 5 和 6) | 10, 5, 12, 6 | 5.5723 |
| 每組一個數值 | 1, 5, 1, 6 | 合併標準差要求每組至少有 2 個數值。 |
核對於 2026-11-08
常見問題
什麼時候該合併標準差?當你假設兩組的母體變異數相等時,就適合做合併。若兩組變異數差異很大,建議改用 Welch's t 檢定。
為什麼用 \(n - 1\) 而不是 \(n\)?使用 \(n - 1\)(即貝索校正,Bessel's correction)可以由樣本得到不偏的變異數估計值。
樣本的先後順序會影響結果嗎?不會。把兩組樣本互換,算出來的合併標準差完全相同。