什麼是相對標準差?
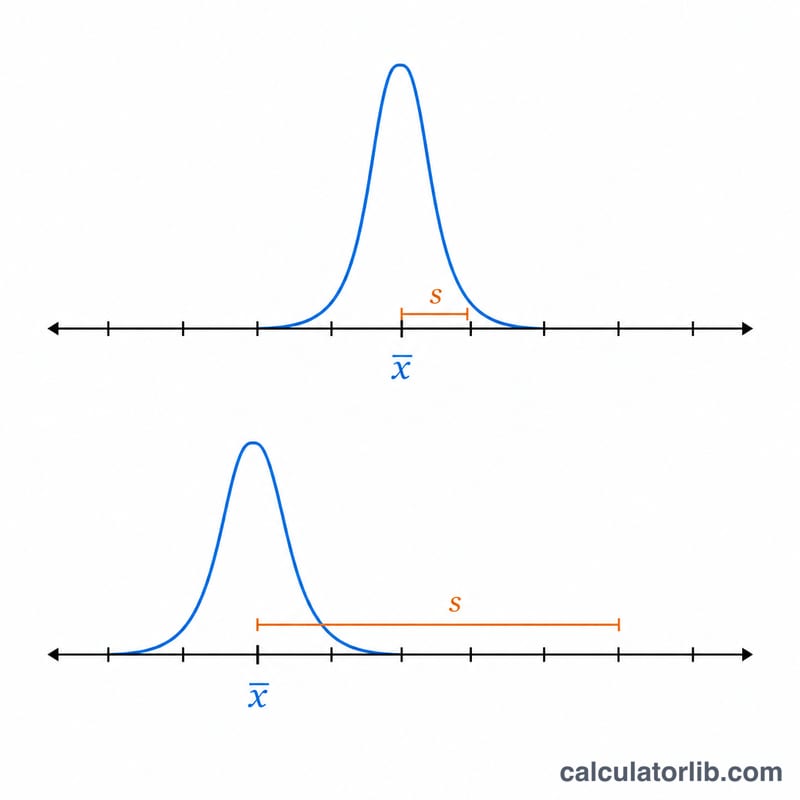
相對標準差(RSD),又稱為變異係數(%CV),用來衡量一組數值相對於其平均值的離散程度。由於它是把標準差除以平均值再乘以 100,因此結果是不帶單位的百分比。正因如此,RSD 特別適合用來比較單位不同、或數量級差異很大的量測精密度——這是單純的標準差所做不到的。
如何使用本計算器
請以逗號或空格分隔輸入您的資料數值。接著選擇要使用樣本標準差(採用 \(n-1\),當您的資料只是更大群體中的一部分時,這是常見選擇),或是母體標準差(採用 \(n\),當您的資料代表整個群體時使用)。計算器會以百分比形式回傳 RSD,並一併列出平均值、標準差以及資料點的數量。
公式解析
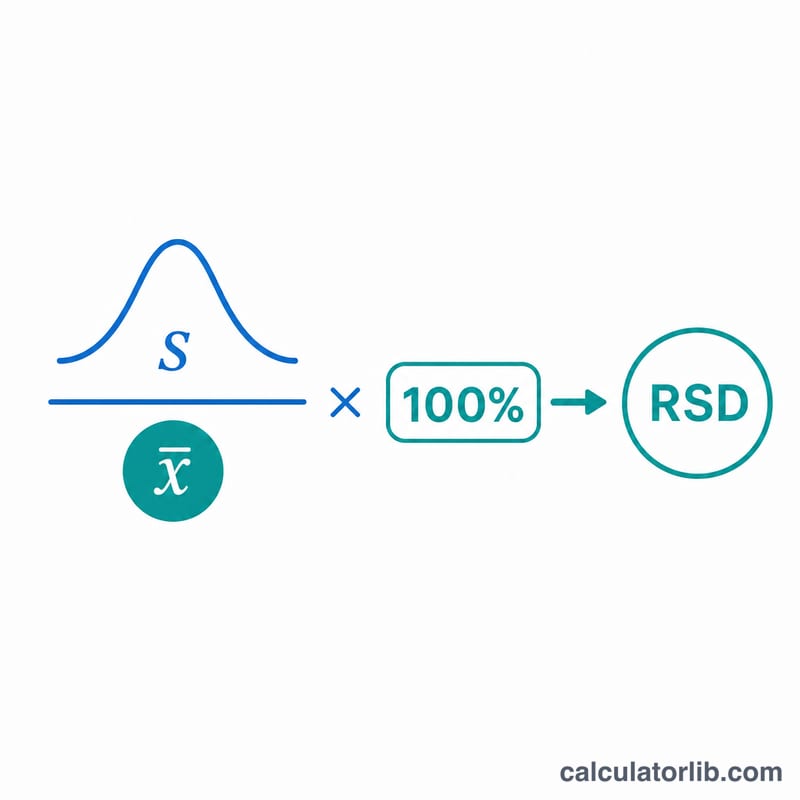
首先計算平均值(\(\bar{x}\));接著由各數值對平均值的離差平方求得標準差(\(s\));最後 RSD =(\(s \div \bar{x}\))× 100%。
$$\text{RSD} = \frac{s}{\bar{x}} \times 100\% \qquad s = \sqrt{\frac{\sum_{i=1}^{n}(x_i - \bar{x})^2}{n-1}}$$RSD 越小(約低於 10%)代表資料聚集緊密、精密度高;RSD 越大則表示變異程度高。
實例演算
以資料組 10、12、14、16、18 為例:平均值為 14。樣本變異數為
$$\frac{(-4)^2+(-2)^2+0^2+2^2+4^2}{4} = \frac{40}{4} = 10$$所以 \(s = \sqrt{10} \approx 3.1623\)。
$$\text{RSD} = \frac{3.1623}{14} \times 100 \approx 22.59\%$$跨示例資料集的相對標準差
下面的每一行都使用樣本標準差(\(n-1\)分母),與計算示例相同的慣例,因此可以在計算器中選擇樣本選項,直接重現這些數字。比較的要點是相對標準差是一個比率:相同的散佈根據平均值的位置可能是優異的精度或糟糕的精度。
| 資料值 | n | 平均值 \(\bar{x}\) | 樣本標準差 \(s\) | 相對標準差 (%CV) |
|---|---|---|---|---|
| 8, 10, 12 | 3 | 10 | 2.0000 | 20.00% |
| 98, 100, 102 | 3 | 100 | 2.0000 | 2.00% |
| 10.02, 9.98, 10.01 | 3 | 10.0033 | 0.0208 | 0.21% |
| 5, 15, 25, 35 | 4 | 20 | 12.9099 | 64.55% |
| 20, 21, 22, 23, 24 | 5 | 22 | 1.5811 | 7.19% |
| 20, 21, 22, 23, 60(最後一個值是離群值) | 5 | 29.2 | 17.2540 | 59.09% |
第一行的計算方式
對集合8, 10, 12的完整代入計算:
$$\bar{x} = \frac{8 + 10 + 12}{3} = \frac{30}{3} = 10$$$$s = \sqrt{\frac{(8-10)^2 + (10-10)^2 + (12-10)^2}{3-1}} = \sqrt{\frac{4 + 0 + 4}{2}} = \sqrt{4} = 2$$$$\text{相對標準差} = \frac{2}{10} \times 100\% = 20\%$$各行的含義
- 標準差相同,相對標準差相差十倍(第1和2行)。兩個集合都是三個點,間距兩個單位,所以都得到\(s = 2\)。因為平均值分別為10和100,相對標準差分別為20%和2%。單獨的標準差無法判斷測量是否精確;它必須根據所測量值的大小來解讀。
- 高度聚集的複製測定集合(第3行)。三個接近10單位的複製測定值相差最多0.04,得到相對標準差約0.21% — 這是在運行良好的色譜系統中複製注射的預期可重複性。
- 真正可變的集合(第4行)。值從5到35,平均值約為20,相對標準差約65%表示散佈的數量級與平均值本身相當。對於分析複製集合,這表示方法失敗;對於個體間生物學資料,這可能是完全正常的。
- 一個離群值的膨脹效應(第5和6行)。將單個值24替換為60,保持五個觀察值中的四個不變,但平均值從22上升到29.2,標準差上升了十倍多,相對標準差從約7%跳升到約59%。因為平方偏差被相加,一個極端點主導了結果 — 這就是為什麼相對標準差意外較大時,應該在得出過程不精確的結論前檢查原始值。
從表中可以得出兩個實用的警告。首先,僅由三個點計算的相對標準差本身就是一個不精確的估計,因此這些值之間的小差異不應被過度解釋。其次,如果您將計算器切換為母體標準差(除以\(n\)而不是\(n-1\)),上述所有相對標準差都會變小 — 對於\(n = 3\),因子為\(\sqrt{2/3} \approx 0.816\) — 因此在將報告的%CV與接受準則進行比較之前,始終說明所使用的是哪種慣例。
計算慣例與邊界情況
以下每個情況都在本計算機上實際執行過,結果欄就是它真正回傳的值。
| 情況 | 輸入 | 結果 |
|---|---|---|
| 小數 0.1、0.2、0.3 | 0.1, 0.2, 0.3 | 50% |
| 偶數個數值 (1, 2, 3, 4) | 1, 2, 3, 4 | 51.64% |
| 負值 (−3, −1, 4) | -3, -1, 4 | 平均數為 0 時,相對標準差沒有定義。 |
| 清單中有 0 (0, 4, 9) | 0, 4, 9 | 104.06% |
| 樣本還是母體 (2, 4, 4, 4, 5, 5, 7, 9) | 2, 4, 4, 4, 5, 5, 7, 9 | 42.76% |
| 只有一個數值 | 7 | 樣本標準差至少需要 2 個數值。 |
核對於 2026-11-08
常見問題
RSD 和 %CV 是同一回事嗎?是的——相對標準差與百分比變異係數指的是同一個計算。
我該用樣本還是母體?當您的數值只是從更大母體中抽出的樣本時,請使用樣本(\(n-1\)),這涵蓋了大多數實驗室與問卷調查的情境。只有在您已量測群體中的每一個成員時,才使用母體(\(n\))。
多少 RSD 才算好?這要視領域而定。在分析化學中,RSD 低於 2% 通常被視為極佳的精密度;而在其他情境下,15–20% 以內可能就已足夠可接受。