상대표준편차란?
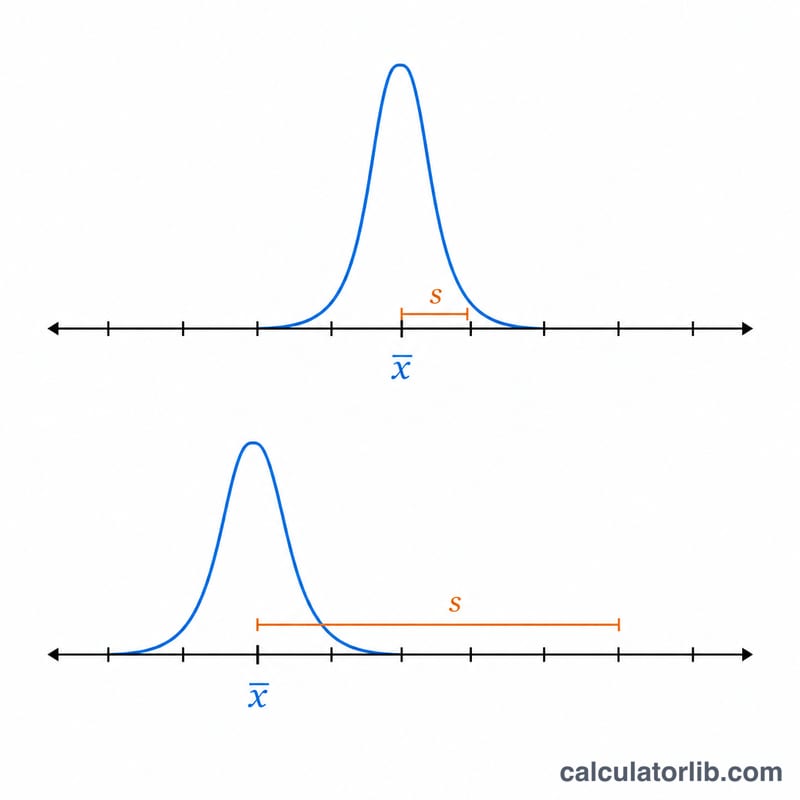
상대표준편차(RSD)는 변동계수(%CV)라고도 불리며, 데이터 값들이 평균을 기준으로 얼마나 퍼져 있는지를 나타내는 지표입니다. 표준편차를 평균으로 나눈 뒤 100을 곱해 구하기 때문에 단위가 없는 백분율(%)로 표현됩니다. 덕분에 단위가 서로 다르거나 크기 차이가 큰 측정값들의 정밀도를 비교할 때 매우 유용합니다. 이는 단위에 의존하는 일반 표준편차만으로는 할 수 없는 일입니다.
계산기 사용 방법
데이터 값을 쉼표 또는 공백으로 구분해 입력하세요. 그런 다음 표본 표준편차(n−1 사용, 데이터가 더 큰 집단의 일부일 때 흔히 선택)와 모집단 표준편차(n 사용, 데이터가 전체 집단을 나타낼 때) 중 하나를 선택합니다. 계산기는 RSD를 백분율로 보여주며, 평균, 표준편차, 데이터 개수까지 함께 제공합니다.
공식 풀이
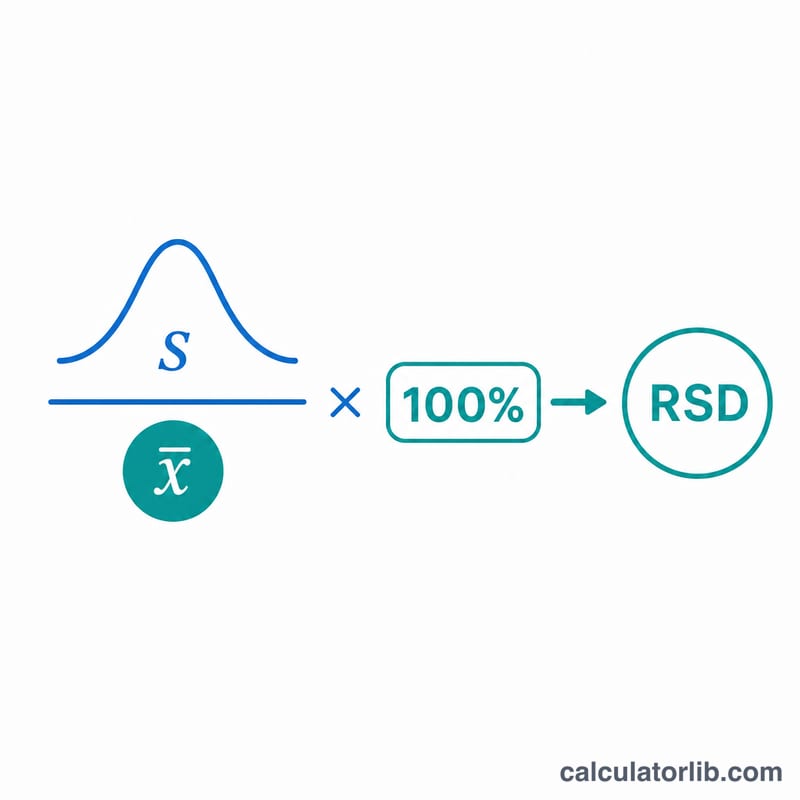
먼저 평균(\(\bar{x}\))을 구합니다. 이어서 평균에 대한 편차의 제곱을 이용해 표준편차(\(s\))를 계산합니다. 마지막으로 다음과 같이 구합니다.
$$\text{RSD} = \frac{s}{\bar{x}} \times 100\%$$RSD가 작으면(약 10% 미만) 데이터가 촘촘하게 모여 있어 정밀하다는 의미이고, RSD가 크면 값들의 변동성이 크다는 뜻입니다.
계산 예시
데이터 10, 12, 14, 16, 18을 예로 들어 보겠습니다. 평균은 14입니다. 표본분산은 $$\frac{(-4)^2+(-2)^2+0^2+2^2+4^2}{4} = \frac{40}{4} = 10$$ 이므로, \(s = \sqrt{10} \approx 3.1623\) 입니다. 따라서 $$\text{RSD} = \frac{3.1623}{14} \times 100 \approx 22.59\%$$ 가 됩니다.
예제 데이터 세트에 걸친 상대 표준편차(RSD)
아래의 모든 행은 표본 표준편차(분모 n−1)를 사용하며, 이는 계산 예제에서와 동일한 관례이므로 계산기에서 표본 옵션을 선택하여 숫자를 직접 재현할 수 있습니다. 비교의 요점은 RSD가 비율이라는 것입니다: 동일한 산포도가 평균의 위치에 따라 우수한 정밀도 또는 형편없는 정밀도가 될 수 있습니다.
| 데이터 값 | n | 평균 \(\bar{x}\) | 표본 표준편차 \(s\) | 상대 표준편차(RSD) (%CV) |
|---|---|---|---|---|
| 8, 10, 12 | 3 | 10 | 2.0000 | 20.00% |
| 98, 100, 102 | 3 | 100 | 2.0000 | 2.00% |
| 10.02, 9.98, 10.01 | 3 | 10.0033 | 0.0208 | 0.21% |
| 5, 15, 25, 35 | 4 | 20 | 12.9099 | 64.55% |
| 20, 21, 22, 23, 24 | 5 | 22 | 1.5811 | 7.19% |
| 20, 21, 22, 23, 60 (마지막 값은 이상치) | 5 | 29.2 | 17.2540 | 59.09% |
첫 번째 행을 얻는 방법
데이터 집합 8, 10, 12에 대한 완전한 대입:
$$\bar{x} = \frac{8 + 10 + 12}{3} = \frac{30}{3} = 10$$$$s = \sqrt{\frac{(8-10)^2 + (10-10)^2 + (12-10)^2}{3-1}} = \sqrt{\frac{4 + 0 + 4}{2}} = \sqrt{4} = 2$$$$\text{상대 표준편차} = \frac{2}{10} \times 100\% = 20\%$$행이 보여주는 것
- 동일한 표준편차, 상대 표준편차의 10배 차이 (행 1과 2). 두 집합 모두 2 단위로 떨어진 3개의 점이므로 둘 다 \(s = 2\)를 정확히 줍니다. 평균이 각각 10과 100이므로 상대 표준편차는 20% 대 2%입니다. 표준편차 하나만으로는 측정의 정밀도 여부를 알 수 없습니다; 측정 대상의 크기에 대한 비율로 봐야 합니다.
- 밀접하게 집단화된 반복 측정 세트 (행 3). 10 단위 근처의 3개 반복 측정이 최대 0.04만큼 차이나므로 약 0.21%의 상대 표준편차를 줍니다 — 잘 작동하는 크로마토그래피 시스템에서의 반복 주입으로부터 예상되는 재현성의 종류입니다.
- 진정으로 변동이 큰 세트 (행 4). 평균 20 주변의 5에서 35까지의 값을 가지므로 약 65%의 상대 표준편차는 산포가 평균 자체와 대략 같은 크기임을 의미합니다. 분석 반복 세트의 경우 이는 실패한 방법을 나타내지만; 개인 간 생물학적 데이터의 경우 완전히 정상일 수 있습니다.
- 하나의 이상치의 증폭 효과 (행 5 및 6). 단일 값 24를 60으로 바꾸면 5개 관측값 중 4개는 건드리지 않은 채로 남지만 평균은 22에서 29.2로 올라가고, 표준편차는 10배 이상 올라가며, 상대 표준편차는 약 7%에서 약 59%로 급증합니다. 제곱 편차가 합산되기 때문에 하나의 극단값이 결과를 지배합니다 — 이것이 예상 외로 큰 상대 표준편차가 나왔을 때 프로세스가 부정확하다고 결론짓기 전에 원시 값을 검사하도록 해야 하는 이유입니다.
표에서 두 가지 실질적 주의사항이 뒤따릅니다. 첫째, 단 3개의 포인트에서만 계산된 상대 표준편차는 그 자체로 부정확한 추정이므로 이러한 값들 간의 작은 차이는 과도하게 해석되어서는 안 됩니다. 둘째, 계산기를 모집단 표준편차(n−1 대신 n으로 나누기)로 전환하면 위의 모든 상대 표준편차는 더 작아집니다 — n = 3의 경우 \(\sqrt{2/3} \approx 0.816\)의 배수로 — 따라서 보고된 %CV를 허용 기준과 비교하기 전에 항상 사용된 관례를 명시해야 합니다.
계산 규칙과 경계 사례
아래 사례는 모두 이 계산기로 실제 계산한 것이며, 결과 열은 계산기가 실제로 돌려준 값입니다.
| 사례 | 입력 | 결과 |
|---|---|---|
| 소수 0.1, 0.2, 0.3 | 0.1, 0.2, 0.3 | 50% |
| 값의 개수가 짝수 (1, 2, 3, 4) | 1, 2, 3, 4 | 51.64% |
| 음수 값 (−3, −1, 4) | -3, -1, 4 | 평균이 0이면 상대표준편차는 정의되지 않습니다. |
| 목록에 0 포함 (0, 4, 9) | 0, 4, 9 | 104.06% |
| 표본 또는 모집단 (2, 4, 4, 4, 5, 5, 7, 9) | 2, 4, 4, 4, 5, 5, 7, 9 | 42.76% |
| 값이 하나뿐 | 7 | 표본표준편차를 구하려면 값이 2개 이상 필요합니다. |
2026-11-08 확인
자주 묻는 질문
RSD와 %CV는 같은 건가요? 네, 맞습니다. 상대표준편차(RSD)와 백분율 변동계수(%CV)는 동일한 계산을 가리키는 다른 이름입니다.
표본과 모집단 중 무엇을 선택해야 하나요? 값들이 더 큰 모집단에서 추출한 표본이라면 표본(n−1)을 사용하세요. 대부분의 실험실 측정이나 설문 조사가 여기에 해당합니다. 집단의 모든 구성원을 빠짐없이 측정한 경우에만 모집단(n)을 사용합니다.
적정한 RSD 값은 얼마인가요? 분야에 따라 다릅니다. 분석화학에서는 RSD가 2% 미만이면 매우 우수한 정밀도로 보는 경우가 많지만, 다른 분야에서는 15~20%까지도 허용되기도 합니다.