Bağıl Standart Sapma Nedir?
Varyasyon katsayısı (%CV) olarak da bilinen bağıl standart sapma (RSD), bir değerler kümesinin ortalamasına göre ne kadar dağıldığını ölçer. Standart sapmayı ortalamaya bölüp 100 ile çarptığı için sonuç birimsiz bir yüzde olarak çıkar. İşte bu nedenle RSD, farklı birimlere ya da çok farklı büyüklük mertebelerine sahip ölçümlerin hassasiyetini karşılaştırmak için ideal bir araçtır; ham standart sapmanın tek başına yapamadığı tam olarak budur.
Bu Hesaplama Aracını Nasıl Kullanırsınız?
Veri değerlerinizi virgülle ya da boşlukla ayırarak girin. Ardından örneklem standart sapmasını mı (n−1 kullanır; verileriniz daha büyük bir kümenin bir alt kümesiyse yapılan olağan seçimdir) yoksa yığın standart sapmasını mı (n kullanır; verileriniz tüm kümeyi temsil ettiğinde) istediğinizi seçin. Hesaplama aracı; RSD değerini yüzde olarak, ortalamayı, standart sapmayı ve veri noktası sayısını birlikte verir.
Formülün Açıklaması
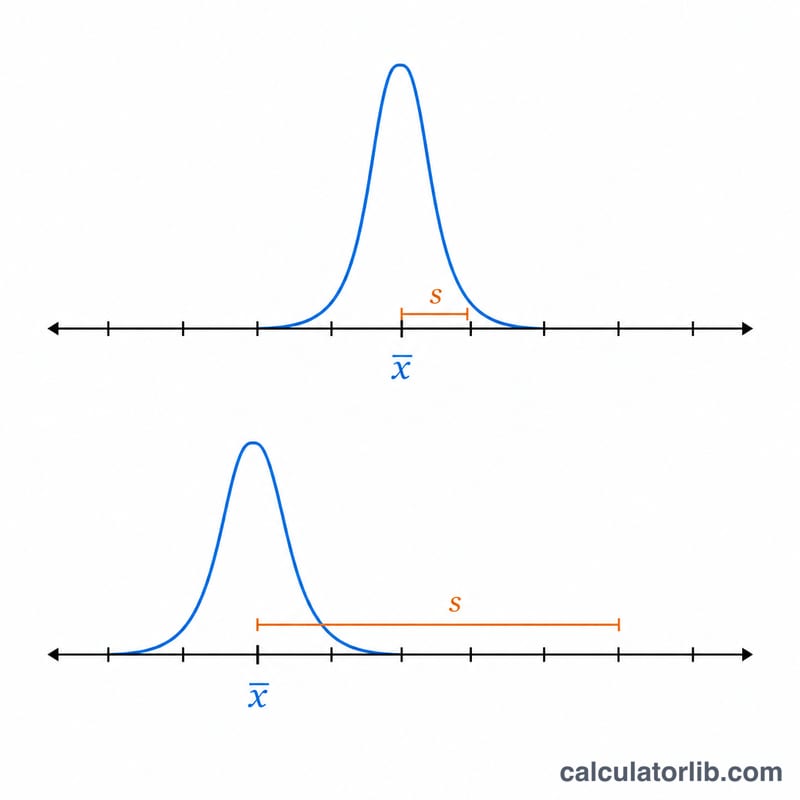
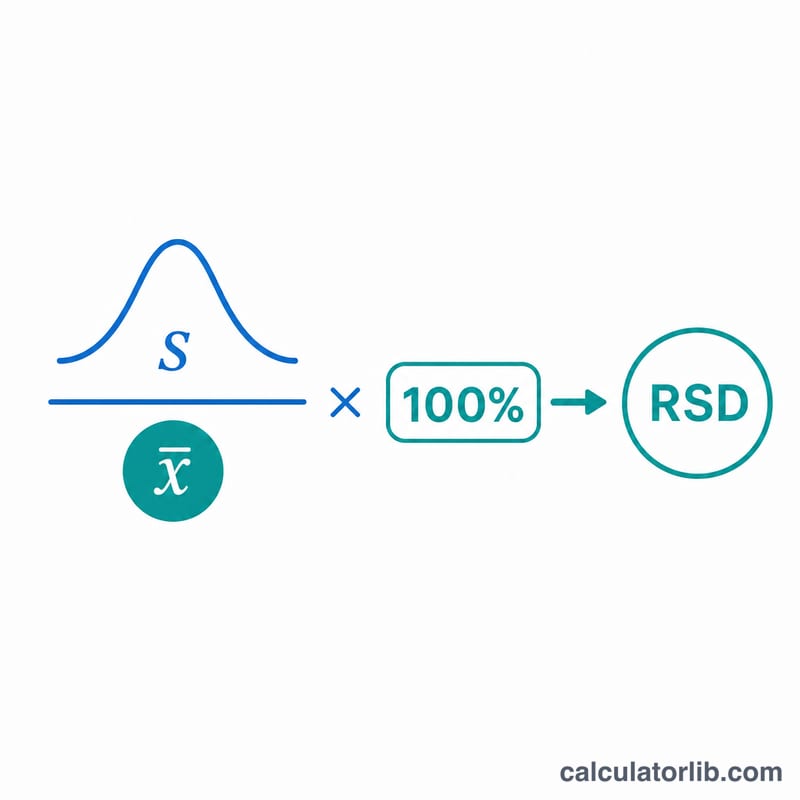
Önce ortalama (\(\bar{x}\)) hesaplanır. Ardından ortalamadan sapmaların karelerinden yola çıkılarak standart sapma (\(s\)) bulunur. Son olarak RSD aşağıdaki gibi elde edilir:
$$\text{RSD} = \frac{s}{\bar{x}} \times 100\%$$Küçük bir RSD (yaklaşık %10'un altı) verilerin sıkı şekilde kümelendiğini ve hassas olduğunu gösterir; büyük bir RSD ise yüksek değişkenliğe işaret eder.
Örnek Çözüm
10, 12, 14, 16, 18 veri kümesi için ortalama 14'tür. Örneklem varyansı \(\frac{(-4)^2+(-2)^2+0^2+2^2+4^2}{4} = \frac{40}{4} = 10\) olur, dolayısıyla \(s = \sqrt{10} \approx 3{,}1623\) çıkar. RSD aşağıdaki gibi hesaplanır:
$$\text{RSD} = \frac{3{,}1623}{14} \times 100 \approx \%22{,}59$$Örnek Veri Setlerinde RSD
Aşağıdaki her satır örnek standart sapmayı (\(n-1\) paydası) kullanır; bu, çalışılan örnek ile aynı kurallandırmadır, bu nedenle sayılar doğrudan hesaplayıcıda örnek seçeneği seçili olarak yeniden üretilebilir. Karşılaştırmanın amacı, RSD'nin bir oran olmasıdır: aynı yayılma, ortalamanın nerede olduğuna bağlı olarak mükemmel kesinlik veya kötü kesinlik olabilir.
| Veri değerleri | n | Ortalama \(\bar{x}\) | Örnek SD \(s\) | RSD (%CV) |
|---|---|---|---|---|
| 8, 10, 12 | 3 | 10 | 2.0000 | 20.00% |
| 98, 100, 102 | 3 | 100 | 2.0000 | 2.00% |
| 10.02, 9.98, 10.01 | 3 | 10.0033 | 0.0208 | 0.21% |
| 5, 15, 25, 35 | 4 | 20 | 12.9099 | 64.55% |
| 20, 21, 22, 23, 24 | 5 | 22 | 1.5811 | 7.19% |
| 20, 21, 22, 23, 60 (son değer aykırı değerdir) | 5 | 29.2 | 17.2540 | 59.09% |
İlk satırın nasıl elde edildiği
8, 10, 12 seti için tam ikame:
$$\bar{x} = \frac{8 + 10 + 12}{3} = \frac{30}{3} = 10$$$$s = \sqrt{\frac{(8-10)^2 + (10-10)^2 + (12-10)^2}{3-1}} = \sqrt{\frac{4 + 0 + 4}{2}} = \sqrt{4} = 2$$$$\text{RSD} = \frac{2}{10} \times 100\% = 20\%$$Satırların gösterdiği şey
- Aynı SD, RSD'de on kat fark (satırlar 1 ve 2). İki set de iki birim aralıklı üç noktadır, bu nedenle ikisi de tam olarak \(s = 2\) verir. Ortalamalar 10 ve 100 olduğundan, RSD %20'ye karşı %2'dir. Tek başına standart sapma, bir ölçümün kesin olup olmadığını söyleyemez; ölçülen şeyin büyüklüğüne karşı okunması gerekir.
- Sıkı kümelenmiş bir tekrar seti (satır 3). 10 birim yakınında üç tekrar belirleme en fazla 0,04 farklıdır, yaklaşık %0,21 RSD verir — iyi davranış gösteren bir kromatografik sistem üzerinde tekrar enjeksiyonlarından beklenen tekrarlanabilirlik türü.
- Gerçekten değişken bir set (satır 4). Ortalama 20'ye sahip 5 ile 35 arasında değerlerle, yaklaşık %65 RSD, yayılmanın ortalamanın aynı mertebesinde olduğunu gösterir. Analitik bir tekrar seti için bu başarısız bir yöntemi gösterir; bireyler arası biyolojik veriler için tamamen normal olabilir.
- Bir aykırı değerin şişirme etkisi (satırlar 5 ve 6). Tek değer 24'ü 60 ile değiştirmek beş gözlemden dördünü etkilemeden bırakır, ancak ortalama 22'den 29,2'ye yükselir, SD on kattan fazla artar ve RSD yaklaşık %7'den yaklaşık %59'a sıçrar. Karelenen sapmalar toplandığı için, bir uç nokta sonucu domine eder — bu nedenle beklenmedik şekilde büyük bir RSD, süreci kesin olmadığı sonucuna varmadan önce ham değerleri incelemeyi sizi teşvik etmelidir.
Tablodan iki pratik uyarı çıkar. Birincisi, yalnızca üç noktadan hesaplanan bir RSD, kendisi kesin olmayan bir tahmindir, bu nedenle bu tür değerler arasındaki küçük farklar aşırı yorumlanmamalıdır. İkincisi, hesaplayıcıyı nüfus standart sapmasına değiştirirseniz (\(n\) yerine \(n-1\) ile bölerken), yukarıdaki her RSD daha küçük hale gelir — \(n = 3\) için \(\sqrt{2/3} \approx 0.816\) faktörü ile — bu nedenle kabul kriteri ile karşılaştırmadan önce bildirilen %CV'nin hangi kurallandırmayı kullandığını her zaman belirtin.
Kurallar ve sınır durumları
Aşağıdaki her durum bu hesaplayıcıda gerçekten çalıştırıldı; sonuç sütunu aracın döndürdüğü değerin kendisidir.
| Durum | Girdi | Sonuç |
|---|---|---|
| Ondalıklar 0,1; 0,2; 0,3 | 0.1, 0.2, 0.3 | 50% |
| Çift sayıda değer (1, 2, 3, 4) | 1, 2, 3, 4 | 51,64% |
| Negatif değerler (−3, −1, 4) | -3, -1, 4 | Ortalama 0 olduğunda göreli standart sapma tanımsızdır. |
| Listede sıfır (0, 4, 9) | 0, 4, 9 | 104,06% |
| Örneklem mi anakütle mi (2, 4, 4, 4, 5, 5, 7, 9) | 2, 4, 4, 4, 5, 5, 7, 9 | 42,76% |
| Tek bir değer | 7 | Örneklem standart sapması için en az 2 değer gerekir. |
2026-11-08 tarihinde kontrol edildi
Sıkça Sorulan Sorular
RSD ile %CV aynı şey mi? Evet — bağıl standart sapma ve yüzde varyasyon katsayısı aynı hesaplamayı ifade eder.
Örneklem mi yoksa yığın mı kullanmalıyım? Değerleriniz daha büyük bir yığından alınmış bir örneklemse örneklem (n−1) seçeneğini kullanın; bu, laboratuvar ve anket senaryolarının çoğunu kapsar. Yığın (n) seçeneğini yalnızca kümenin her bir üyesini ölçtüğünüzde kullanın.
İyi bir RSD değeri nedir? Bu, alana göre değişir. Analitik kimyada %2'nin altındaki bir RSD genellikle mükemmel bir hassasiyet olarak kabul edilirken, başka bağlamlarda %15–20'ye kadar olan değerler de kabul edilebilir olabilir.