सापेक्ष मानक विचलन क्या है?
सापेक्ष मानक विचलन (RSD), जिसे विचरण गुणांक (%CV) भी कहा जाता है, यह बताता है कि किसी डेटा सेट के मान अपने औसत के मुकाबले कितने फैले हुए हैं। चूँकि इसमें मानक विचलन को माध्य से भाग देकर 100 से गुणा किया जाता है, इसलिए परिणाम एक इकाई-रहित प्रतिशत के रूप में मिलता है। यही वजह है कि RSD अलग-अलग इकाइयों या बहुत भिन्न परिमाण वाले मापों की परिशुद्धता की तुलना करने के लिए बेहद उपयोगी है — ऐसा काम जो साधारण मानक विचलन से नहीं हो सकता।
इस कैलकुलेटर का उपयोग कैसे करें
अपने डेटा मानों को कॉमा या स्पेस से अलग करके दर्ज करें। फिर तय करें कि आपको सैंपल मानक विचलन चाहिए (जिसमें \(n-1\) का प्रयोग होता है — यह वही सामान्य विकल्प है जब आपका डेटा किसी बड़े समूह का एक हिस्सा हो) या पॉपुलेशन मानक विचलन (जिसमें \(n\) का प्रयोग होता है — जब आपका डेटा पूरे समूह को दर्शाता हो)। कैलकुलेटर आपको RSD प्रतिशत के रूप में देता है, साथ ही माध्य, मानक विचलन और डेटा बिंदुओं की संख्या भी दिखाता है।
सूत्र की व्याख्या
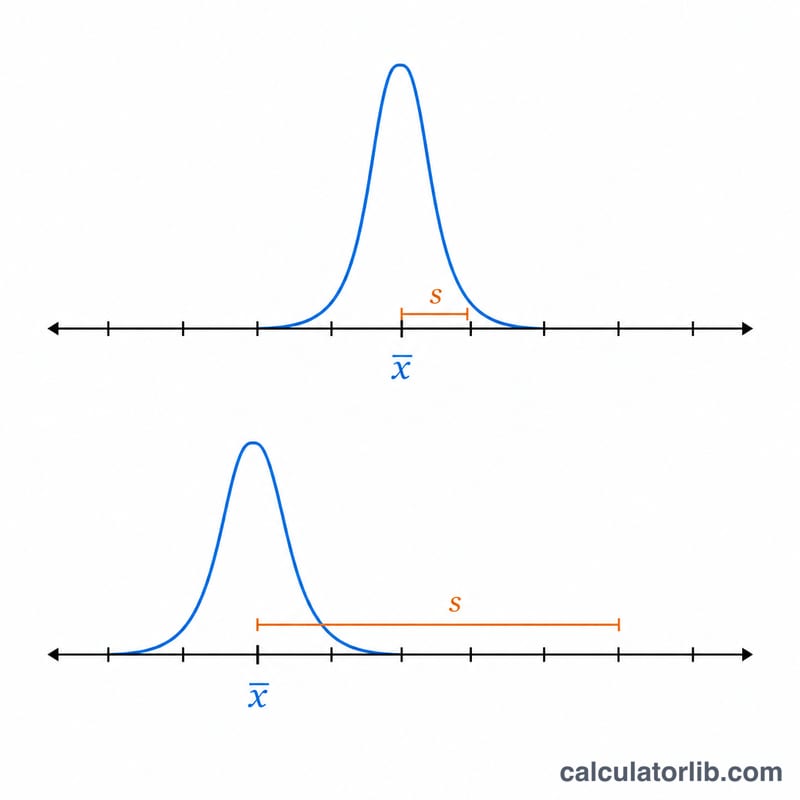
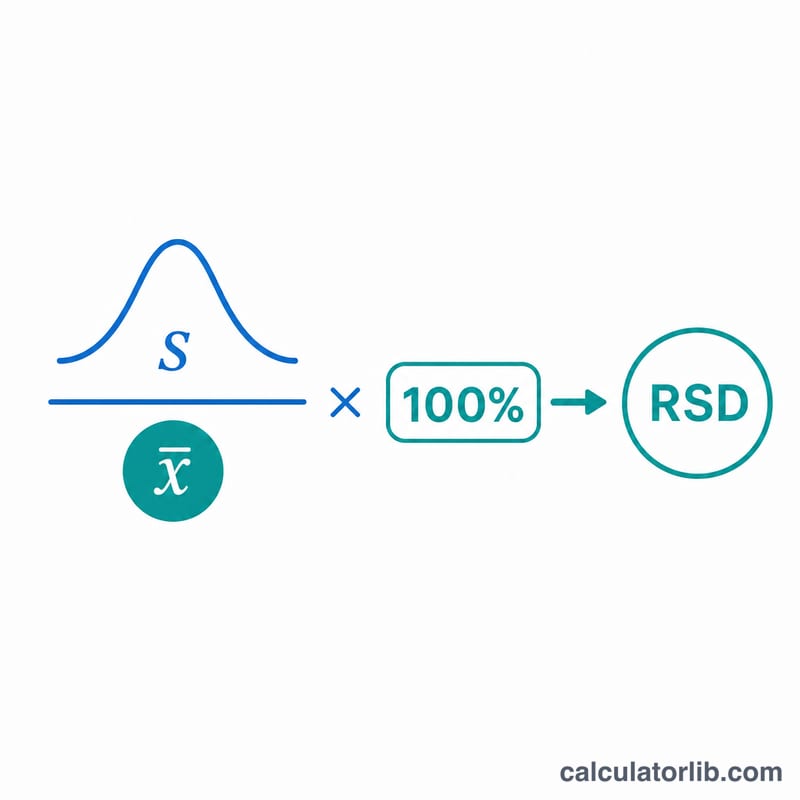
सबसे पहले माध्य (\(\bar{x}\)) निकाला जाता है। फिर माध्य के चारों ओर के वर्गित विचलनों से मानक विचलन (\(s\)) ज्ञात किया जाता है। अंत में:
$$\text{RSD} = \frac{s}{\bar{x}} \times 100\%$$छोटा RSD (लगभग 10% से कम) यह दर्शाता है कि डेटा कसकर एक जगह गुँथा हुआ और परिशुद्ध है; जबकि बड़ा RSD अधिक परिवर्तनशीलता का संकेत देता है।
हल किया हुआ उदाहरण
डेटा सेट 10, 12, 14, 16, 18 के लिए: माध्य 14 है। सैंपल प्रसरण \(\frac{(-4)^2+(-2)^2+0^2+2^2+4^2}{4} = \frac{40}{4} = 10\) है, इसलिए \(s = \sqrt{10} \approx 3.1623\)। अब:
$$\text{RSD} = \frac{3.1623}{14} \times 100 \approx 22.59\%$$उदाहरण डेटा सेट में RSD
नीचे की प्रत्येक पंक्ति नमूना मानक विचलन का उपयोग करती है (\(n-1\) हर), वही परिपाटी जैसे कि किए गए उदाहरण में है, इसलिए संख्याओं को नमूना विकल्प चुने हुए कैलकुलेटर में सीधे पुनः उत्पन्न किया जा सकता है। तुलना का बिंदु यह है कि RSD एक अनुपात है: समान फैलाव उत्कृष्ट सटीकता या भयानक सटीकता हो सकता है यह इस बात पर निर्भर करता है कि माध्य कहाँ स्थित है।
| डेटा मान | n | माध्य \(\bar{x}\) | नमूना SD \(s\) | RSD (%CV) |
|---|---|---|---|---|
| 8, 10, 12 | 3 | 10 | 2.0000 | 20.00% |
| 98, 100, 102 | 3 | 100 | 2.0000 | 2.00% |
| 10.02, 9.98, 10.01 | 3 | 10.0033 | 0.0208 | 0.21% |
| 5, 15, 25, 35 | 4 | 20 | 12.9099 | 64.55% |
| 20, 21, 22, 23, 24 | 5 | 22 | 1.5811 | 7.19% |
| 20, 21, 22, 23, 60 (अंतिम मान एक आउटलियर है) | 5 | 29.2 | 17.2540 | 59.09% |
पहली पंक्ति कैसे प्राप्त की जाती है
सेट 8, 10, 12 के लिए पूर्ण प्रतिस्थापन:
$$\bar{x} = \frac{8 + 10 + 12}{3} = \frac{30}{3} = 10$$$$s = \sqrt{\frac{(8-10)^2 + (10-10)^2 + (12-10)^2}{3-1}} = \sqrt{\frac{4 + 0 + 4}{2}} = \sqrt{4} = 2$$$$\text{RSD} = \frac{2}{10} \times 100\% = 20\%$$पंक्तियाँ क्या दिखाती हैं
- समान SD, RSD में दशगुणा अंतर (पंक्तियाँ 1 और 2)। दोनों सेट तीन बिंदु हैं जो दो इकाइयों से अलग हैं, इसलिए दोनों \(s = 2\) बिल्कुल देते हैं। क्योंकि माध्य 10 और 100 हैं, RSD 20% बनाम 2% है। अकेला मानक विचलन आपको यह नहीं बता सकता कि माप सटीक है या नहीं; इसे मापी गई चीज़ के परिमाण के विरुद्ध पढ़ा जाना चाहिए।
- एक कसकर समूहित प्रतिलिपि सेट (पंक्ति 3)। 10 इकाइयों के पास तीन प्रतिलिपि निर्धारण अधिकतम 0.04 से भिन्न होते हैं, जिससे लगभग 0.21% की RSD मिलती है — एक अच्छी तरह से व्यवहार करने वाली क्रोमैटोग्राफिक प्रणाली पर प्रतिलिपि इंजेक्शन से अपेक्षित दोहरापन की तरह।
- एक सच में परिवर्तनशील सेट (पंक्ति 4)। 20 के माध्य के चारों ओर 5 से 35 तक के मूल्यों के साथ, लगभग 65% की RSD कहती है कि फैलाव माध्य के समान क्रम का है। एक विश्लेषणात्मक प्रतिलिपि सेट के लिए यह एक विफल विधि का संकेत देता; व्यक्तियों के बीच जैविक डेटा के लिए यह पूरी तरह से सामान्य हो सकता है।
- एक आउटलियर का फुलाने वाला प्रभाव (पंक्तियाँ 5 और 6)। एकल मान 24 को 60 से बदलने से पाँच प्रेक्षणों में से चार अछूते रहते हैं, फिर भी माध्य 22 से 29.2 तक बढ़ता है, SD दशगुणा से अधिक बढ़ता है, और RSD लगभग 7% से लगभग 59% तक कूदता है। क्योंकि वर्गित विचलन को जोड़ा जाता है, एक चरम बिंदु परिणाम पर हावी होता है — यही कारण है कि एक अप्रत्याशित रूप से बड़ी RSD आपको प्रक्रिया को अशुद्ध बताने से पहले कच्चे मानों का निरीक्षण करने के लिए प्रेरित करना चाहिए।
तालिका से दो व्यावहारिक सावधानियाँ अनुसरण करती हैं। पहली, केवल तीन बिंदुओं से गणना की गई RSD स्वयं एक अशुद्ध अनुमान है, इसलिए ऐसे मानों के बीच छोटे अंतर को अधिक व्याख्या नहीं किया जाना चाहिए। दूसरी, यदि आप कैलकुलेटर को जनसंख्या मानक विचलन में स्विच करते हैं (द्वारा विभाजित करके \(n\) के बजाय \(n-1\)), ऊपर की प्रत्येक RSD छोटी हो जाती है — \(n = 3\) के लिए \(\sqrt{2/3} \approx 0.816\) के कारक द्वारा — इसलिए हमेशा बताएँ कि एक रिपोर्ट की गई %CV कौन सी परिपाटी का उपयोग करती है इससे पहले कि इसे स्वीकृति मानदंड से तुलना करें।
नियम और सीमांत स्थितियाँ
नीचे की हर स्थिति इसी कैलकुलेटर पर चलाकर देखी गई है; परिणाम वाला कॉलम वही है जो यह वास्तव में लौटाता है।
| स्थिति | इनपुट | परिणाम |
|---|---|---|
| दशमलव 0.1, 0.2, 0.3 | 0.1, 0.2, 0.3 | 50% |
| मानों की सम संख्या (1, 2, 3, 4) | 1, 2, 3, 4 | 51.64% |
| ऋणात्मक मान (−3, −1, 4) | -3, -1, 4 | माध्य 0 होने पर सापेक्ष मानक विचलन परिभाषित नहीं है। |
| सूची में शून्य (0, 4, 9) | 0, 4, 9 | 104.06% |
| नमूना या जनसंख्या (2, 4, 4, 4, 5, 5, 7, 9) | 2, 4, 4, 4, 5, 5, 7, 9 | 42.76% |
| केवल एक मान | 7 | नमूना मानक विचलन के लिए कम से कम 2 मान चाहिए। |
2026-11-08 को जाँचा गया
अक्सर पूछे जाने वाले प्रश्न
क्या RSD और %CV एक ही हैं? हाँ — सापेक्ष मानक विचलन और प्रतिशत विचरण गुणांक एक ही गणना को दर्शाते हैं।
मुझे सैंपल चुनना चाहिए या पॉपुलेशन? सैंपल (\(n-1\)) तब चुनें जब आपके मान किसी बड़ी पॉपुलेशन से लिया गया एक नमूना हों — अधिकांश प्रयोगशाला और सर्वेक्षण स्थितियों में यही लागू होता है। पॉपुलेशन (\(n\)) का उपयोग केवल तब करें जब आपने समूह के हर एक सदस्य को माप लिया हो।
अच्छा RSD कितना होता है? यह क्षेत्र पर निर्भर करता है। विश्लेषणात्मक रसायन विज्ञान में 2% से कम RSD को अक्सर उत्कृष्ट परिशुद्धता माना जाता है, जबकि अन्य संदर्भों में 15–20% तक भी स्वीकार्य हो सकता है।