पूल्ड स्टैंडर्ड डेविएशन क्या है?
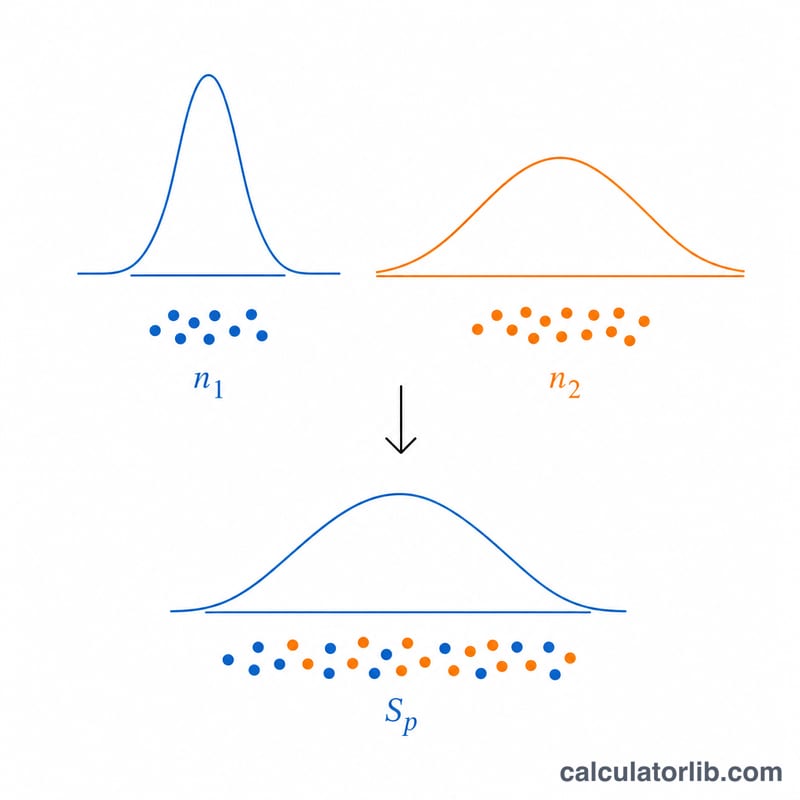
पूल्ड स्टैंडर्ड डेविएशन (Sp) दो सैंपल के स्टैंडर्ड डेविएशन का भारित औसत (weighted average) होता है, जिसे जोड़कर समान पॉपुलेशन स्टैंडर्ड डेविएशन का एक ही अनुमान निकाला जाता है। इसका इस्तेमाल तब होता है जब आप यह मानते हैं कि दो स्वतंत्र सैंपल ऐसी पॉपुलेशन से आए हैं जिनका वैरिएंस एक समान है। यह पूल्ड अनुमान टू-सैंपल t-टेस्ट, Cohen's d इफ़ेक्ट साइज़, और दो माध्यों के अंतर के कॉन्फिडेंस इंटरवल का आधार होता है।
इस कैलकुलेटर का इस्तेमाल कैसे करें
हर सैंपल का आकार (\(n_1\) और \(n_2\)) और हर सैंपल का स्टैंडर्ड डेविएशन (\(s_1\) और \(s_2\)) दर्ज करें। कैलकुलेटर आपको पूल्ड स्टैंडर्ड डेविएशन, पूल्ड वैरिएंस (\(Sp^2\)), और डिग्रीज़ ऑफ़ फ़्रीडम (\(n_1 + n_2 - 2\)) बताएगा। हर सैंपल में कम से कम दो ऑब्ज़र्वेशन होने ज़रूरी हैं ताकि डिग्रीज़ ऑफ़ फ़्रीडम पॉज़िटिव बनी रहे।
फ़ॉर्मूला समझें
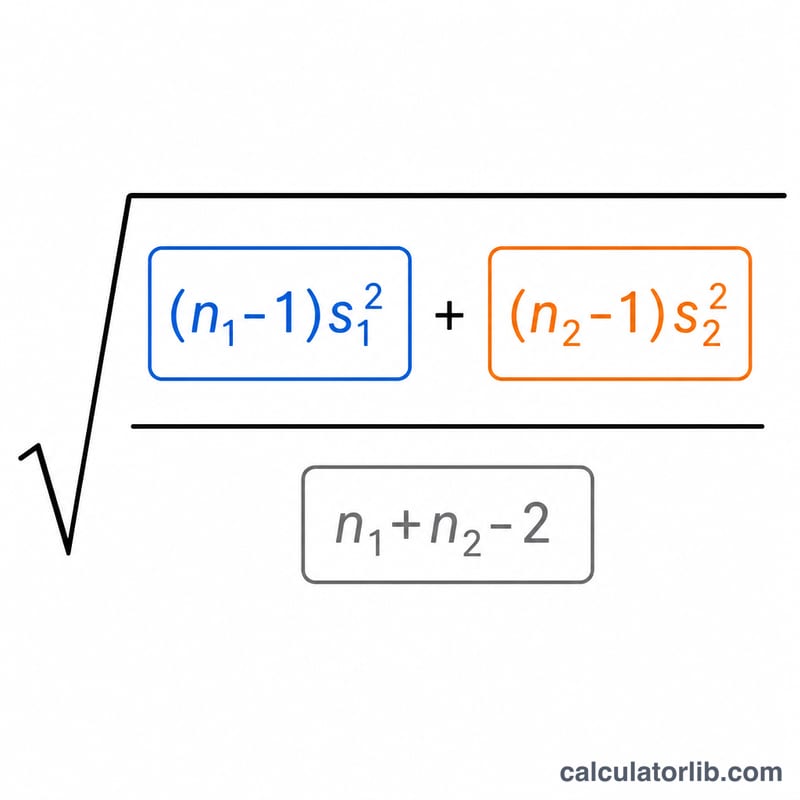
पूल्ड वैरिएंस हर सैंपल के वैरिएंस को उसकी डिग्रीज़ ऑफ़ फ़्रीडम (\(n - 1\)) के हिसाब से भार देता है:
$$Sp^2 = \frac{(n_1 - 1)\cdot s_1^{2} + (n_2 - 1)\cdot s_2^{2}}{n_1 + n_2 - 2}$$
इसका वर्गमूल लेने पर पूल्ड स्टैंडर्ड डेविएशन, \(Sp\) मिलता है। बड़े सैंपल पूल्ड अनुमान में ज़्यादा योगदान देते हैं, इसीलिए वैरिएंस को सीधे औसत करने के बजाय भारित किया जाता है।
हल किया हुआ उदाहरण
मान लीजिए सैंपल 1 में \(n_1 = 10\) और \(s_1 = 5\) है, तथा सैंपल 2 में \(n_2 = 12\) और \(s_2 = 6\) है। तब \((10-1)\cdot 25 = 225\) और \((12-1)\cdot 36 = 396\) होता है, जिनका जोड़ \(621\) है। डिग्रीज़ ऑफ़ फ़्रीडम \(10 + 12 - 2 = 20\) है, इसलिए $$Sp^2 = \frac{621}{20} = 31.05 \quad\text{और}\quad Sp = \sqrt{31.05} \approx 5.5722$$
विभिन्न परिदृश्यों में संयुक्त मानक विचलन कैसे बदलता है
संयुक्त प्रसरण (pooled variance) दोनों नमूना प्रसरणों का भारित औसत है, जिसमें भार प्रत्येक नमूने की स्वतंत्रता की कोटि (degrees of freedom) के बराबर होते हैं: \(S_p^2 = \dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}\)। तालिका इसे चार परिदृश्यों पर लागू करती है।
| परिदृश्य | n₁ | s₁ | n₂ | s₂ | संयुक्त प्रसरण | Sp | df |
|---|---|---|---|---|---|---|---|
| A. समान n, भिन्न मानक विचलन | 20 | 4 | 20 | 8 | (19·16 + 19·64)/38 = 40 | 6.3246 | 38 |
| B. असमान n, बड़ा नमूना प्रभावी | 10 | 5 | 40 | 10 | (9·25 + 39·100)/48 = 85.9375 | 9.2702 | 48 |
| C. समान मानक विचलन | 12 | 6 | 30 | 6 | (11·36 + 29·36)/40 = 36 | 6 | 40 |
| D. बड़े मानक विचलन वाला छोटा नमूना | 8 | 12 | 50 | 4 | (7·144 + 49·16)/56 = 32 | 5.6569 | 56 |
- परिदृश्य A: समान नमूना आकारों के साथ, Sp दोनों मानक विचलनों का वर्ग-माध्य-मूल (root-mean-square) है: \(\sqrt{(4^2+8^2)/2} = \sqrt{40} \approx 6.3246\)। यह सामान्य औसत 6 से बड़ा है।
- परिदृश्य B: दूसरे नमूने में चार गुना अधिक प्रेक्षण हैं, इसलिए Sp (9.27) s₁ = 5 की तुलना में s₂ = 10 के कहीं अधिक निकट है।
- परिदृश्य C: जब s₁ = s₂ होता है, तो भार महत्वपूर्ण नहीं रहते और Sp नमूना आकारों की परवाह किए बिना उसी उभयनिष्ठ मानक विचलन के बराबर होता है।
- परिदृश्य D: 50 प्रेक्षणों वाले नमूने का मानक विचलन छोटा है, इसलिए Sp (5.66) 4 की ओर खिंचा है, भले ही छोटे नमूने का मानक विचलन 12 के रूप में कहीं बड़ा है।
संयुक्त मानक विचलन की व्याख्या
- हमेशा s₁ और s₂ के बीच: क्योंकि Sp² धनात्मक भारों के साथ s₁² और s₂² का भारित औसत है, \(\min(s_1, s_2) \le S_p \le \max(s_1, s_2)\)। यह दोनों के बराबर केवल तभी होता है जब s₁ = s₂ हो।
- उभयनिष्ठ मानक विचलन का अनुमान: इस धारणा के तहत कि दोनों समष्टियों का प्रसरण समान σ² है, Sp² σ² का संयुक्त अनुमान है। यह दोनों नमूनों की जानकारी का उपयोग करता है, इसलिए यह किसी भी एक s से अधिक स्थिर है।
- माध्यों के अंतर की मानक त्रुटि: $$SE = S_p\sqrt{\frac{1}{n_1}+\frac{1}{n_2}}$$ परिदृश्य A में, \(SE = \sqrt{40}\cdot\sqrt{0.1} = \sqrt{4} = 2\)।
- कोहेन का d: $$d = \frac{\bar{x}_1 - \bar{x}_2}{S_p}$$ परिदृश्य A में, माध्य अंतर 5 से \(d = 5/6.3246 \approx 0.79\) प्राप्त होता है।
- स्वतंत्रता की कोटि: \(df = n_1 + n_2 - 2\) संयुक्त (छात्र के) दो-नमूना t-परीक्षण में t-वितरण की df है। परिदृश्य A में df = 38 और परिदृश्य B में df = 48 है।
- समान-प्रसरण धारणा की जाँच: एक सामान्य नियम यह है कि यदि बड़ा मानक विचलन छोटे मानक विचलन का लगभग 2 गुना से अधिक है (प्रसरण अनुपात लगभग 4 से अधिक), तो संयुक्तिकरण (pooling) संदिग्ध है। यह विशेष रूप से तब सच है जब नमूना आकार भिन्न हों। ऐसी स्थिति में आमतौर पर वेल्च का t-परीक्षण उपयोग किया जाता है, जो प्रसरणों को संयुक्त नहीं करता। परिदृश्य A का SD अनुपात ठीक 2 है, और परिदृश्य D का अनुपात 3 है।
नियम और सीमांत स्थितियाँ
नीचे की हर स्थिति इसी कैलकुलेटर पर चलाकर देखी गई है; परिणाम वाला कॉलम वही है जो यह वास्तव में लौटाता है।
| स्थिति | इनपुट | परिणाम |
|---|---|---|
| 10 और 12 के समूह (मानक विचलन 5 और 6) | 10, 5, 12, 6 | 5.5723 |
| हर समूह में एक मान | 1, 5, 1, 6 | संयुक्त मानक विचलन के लिए हर समूह में कम से कम 2 मान चाहिए। |
2026-11-08 को जाँचा गया
अक्सर पूछे जाने वाले सवाल
स्टैंडर्ड डेविएशन को कब पूल करना चाहिए? तब पूल करें जब यह माना जाए कि दोनों समूहों की पॉपुलेशन वैरिएंस बराबर है। अगर वैरिएंस में बहुत अंतर हो, तो इसके बजाय Welch's t-टेस्ट इस्तेमाल करें।
\(n\) की जगह \(n - 1\) क्यों इस्तेमाल करते हैं? \(n - 1\) (Bessel's correction) इस्तेमाल करने से सैंपल से वैरिएंस का निष्पक्ष (unbiased) अनुमान मिलता है।
क्या सैंपल का क्रम मायने रखता है? नहीं। दोनों सैंपल आपस में बदल देने पर भी पूल्ड स्टैंडर्ड डेविएशन वही रहता है।