합동 표준편차란?
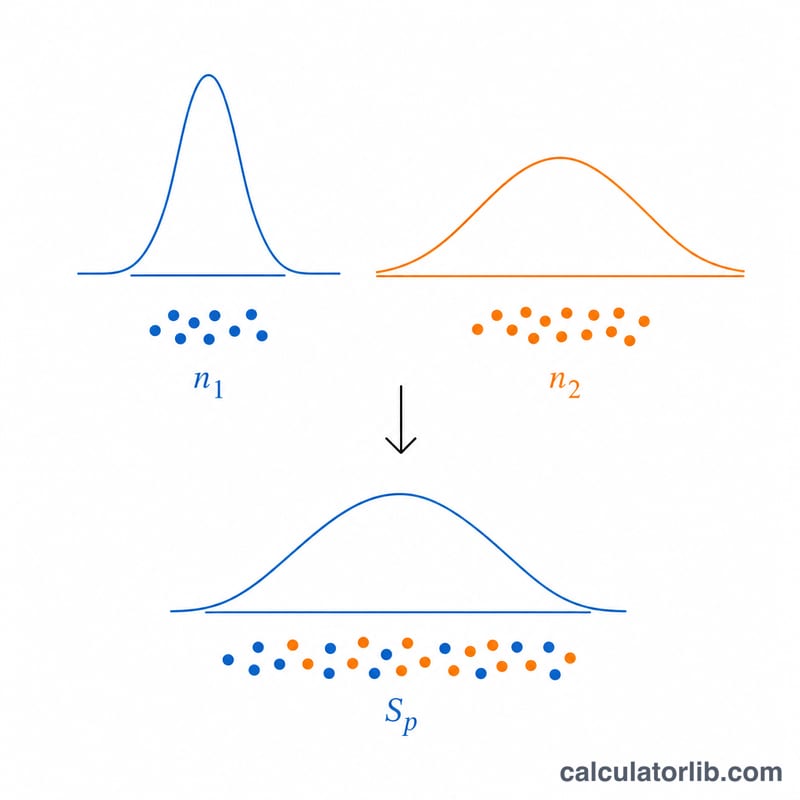
합동 표준편차(pooled standard deviation, Sp)는 두 표본의 표준편차를 가중평균하여 하나의 값으로 합친 것으로, 두 모집단이 공통으로 갖는 모표준편차를 추정하는 데 쓰입니다. 두 독립 표본이 분산이 같은 모집단에서 나왔다고 가정할 때 사용합니다. 이 합동 추정값은 두 표본 t-검정, 효과크기 Cohen's d, 그리고 두 평균의 차이에 대한 신뢰구간을 구할 때 핵심적으로 활용됩니다.
계산기 사용 방법
각 표본의 크기(\(n_1\), \(n_2\))와 표준편차(\(s_1\), \(s_2\))를 입력하세요. 계산기는 합동 표준편차, 합동 분산(\(S_p^2\)), 그리고 자유도(\(n_1 + n_2 - 2\))를 함께 보여줍니다. 자유도가 양수가 되려면 각 표본에 적어도 2개 이상의 관측값이 있어야 합니다.
공식 풀이
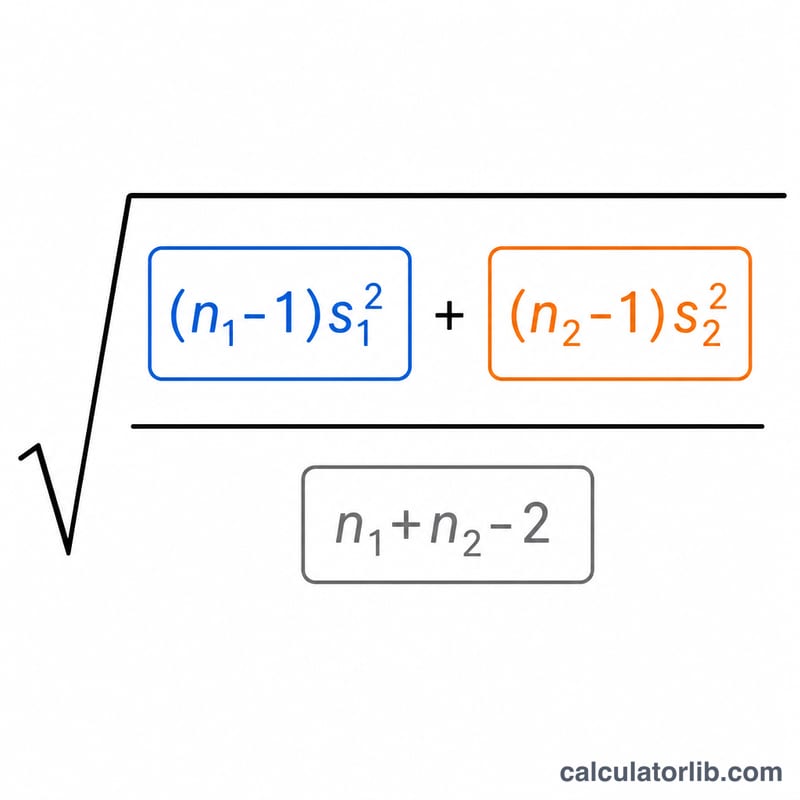
합동 분산은 각 표본의 분산을 자유도(\(n - 1\))로 가중하여 계산합니다.
$$S_p^2 = \frac{(n_1 - 1)\,s_1^{2} + (n_2 - 1)\,s_2^{2}}{n_1 + n_2 - 2}$$
여기에 제곱근을 취하면 합동 표준편차 \(S_p\)가 됩니다. 표본이 클수록 합동 추정값에 더 크게 기여하기 때문에, 단순 평균이 아니라 가중하여 분산을 계산합니다.
계산 예시
표본 1이 \(n_1 = 10\), \(s_1 = 5\)이고 표본 2가 \(n_2 = 12\), \(s_2 = 6\)이라고 합시다. 이때 \((10-1)\cdot 25 = 225\), \((12-1)\cdot 36 = 396\)이며, 둘을 더하면 \(621\)입니다. 자유도는 \(10 + 12 - 2 = 20\)이므로 $$S_p^2 = \frac{621}{20} = 31.05$$ 그리고 $$S_p = \sqrt{31.05} \approx 5.5722$$가 됩니다.
시나리오별 풀링된 표준편차의 변화
풀링된 분산은 두 표본 분산의 가중평균이며, 가중치는 각 표본의 자유도와 같습니다: \(S_p^2 = \dfrac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}\). 표는 이 식을 네 가지 시나리오에 적용한 것입니다.
| 시나리오 | n₁ | s₁ | n₂ | s₂ | 풀링된 분산 | Sp | df |
|---|---|---|---|---|---|---|---|
| A. 표본 크기 같음, 표준편차 다름 | 20 | 4 | 20 | 8 | (19·16 + 19·64)/38 = 40 | 6.3246 | 38 |
| B. 표본 크기 다름, 큰 표본이 지배 | 10 | 5 | 40 | 10 | (9·25 + 39·100)/48 = 85.9375 | 9.2702 | 48 |
| C. 표준편차 동일 | 12 | 6 | 30 | 6 | (11·36 + 29·36)/40 = 36 | 6 | 40 |
| D. 표준편차가 큰 소표본 | 8 | 12 | 50 | 4 | (7·144 + 49·16)/56 = 32 | 5.6569 | 56 |
- 시나리오 A: 표본 크기가 같으면 Sp는 두 표준편차의 제곱평균제곱근(RMS)입니다: \(\sqrt{(4^2+8^2)/2} = \sqrt{40} \approx 6.3246\). 이는 단순평균인 6보다 큽니다.
- 시나리오 B: 두 번째 표본의 관측값 수가 네 배이므로, Sp(9.27)는 s₁ = 5보다 s₂ = 10에 훨씬 가깝습니다.
- 시나리오 C: s₁ = s₂이면 가중치는 영향을 주지 않으며, 표본 크기와 관계없이 Sp는 공통 표준편차와 같습니다.
- 시나리오 D: 관측값이 50개인 표본의 표준편차가 더 작기 때문에, 소표본의 표준편차가 12로 훨씬 큼에도 Sp(5.66)는 4 쪽으로 끌려갑니다.
풀링된 표준편차 해석하기
- 항상 s₁과 s₂ 사이에 있음: Sp²는 양의 가중치를 가진 s₁²과 s₂²의 가중평균이므로, \(\min(s_1, s_2) \le S_p \le \max(s_1, s_2)\)가 성립합니다. 두 값이 같을 때에만 둘 중 하나와 일치합니다.
- 공통 표준편차의 추정치: 두 모집단의 분산이 같은 σ²라고 가정하면, Sp²는 σ²의 결합 추정치입니다. 두 표본의 정보를 모두 사용하므로 어느 한쪽 s보다 더 안정적입니다.
- 평균 차이의 표준오차: $$SE = S_p\sqrt{\frac{1}{n_1}+\frac{1}{n_2}}$$ 시나리오 A에서 \(SE = \sqrt{40}\cdot\sqrt{0.1} = \sqrt{4} = 2\)입니다.
- 코헨의 d: $$d = \frac{\bar{x}_1 - \bar{x}_2}{S_p}$$ 시나리오 A에서 평균 차이가 5이면 \(d = 5/6.3246 \approx 0.79\)입니다.
- 자유도: \(df = n_1 + n_2 - 2\)는 풀링된(스튜던트) 두 표본 t-검정에서 사용하는 t-분포의 자유도입니다. 시나리오 A의 df는 38이고, 시나리오 B의 df는 48입니다.
- 등분산 가정 확인: 일반적인 경험 법칙에 따르면, 더 큰 표준편차가 더 작은 표준편차의 약 2배를 넘으면(분산 비율이 약 4를 넘으면) 풀링은 의문의 여지가 있습니다. 표본 크기가 다를 때 특히 그렇습니다. 이런 경우에는 분산을 풀링하지 않는 웰치(Welch) t-검정을 보통 대신 사용합니다. 시나리오 A의 표준편차 비율은 정확히 2이고, 시나리오 D의 비율은 3입니다.
계산 규칙과 경계 사례
아래 사례는 모두 이 계산기로 실제 계산한 것이며, 결과 열은 계산기가 실제로 돌려준 값입니다.
| 사례 | 입력 | 결과 |
|---|---|---|
| 10명과 12명 집단 (표준편차 5와 6) | 10, 5, 12, 6 | 5.5723 |
| 집단마다 값 1개 | 1, 5, 1, 6 | 합동표준편차를 구하려면 각 집단에 값이 2개 이상 필요합니다. |
2026-11-08 확인
자주 묻는 질문
언제 표준편차를 합동해야 하나요? 두 집단의 모분산이 같다고 가정할 수 있을 때 합동합니다. 분산 차이가 크다면 대신 Welch's t-검정을 사용하세요.
왜 n이 아니라 n − 1을 쓰나요? \(n - 1\)(베셀 보정)을 사용하면 표본에서 모분산을 불편(unbiased) 추정할 수 있기 때문입니다.
표본의 순서가 결과에 영향을 주나요? 아닙니다. 두 표본의 순서를 바꿔도 합동 표준편차는 동일합니다.