这个计算器能做什么
平均值与标准差计算器可以读取一组数字,并返回平均值(均值)、方差和标准差。平均值反映了数据的中心位置,而标准差衡量的是各个数值围绕中心的分散程度。标准差越小,说明数值紧密地聚集在平均值附近;标准差越大,则说明数据分布得越分散。
如何使用
在输入框中输入或粘贴你的数字,数字之间用逗号或空格分隔。如果你的数据只是从更大群体中抽取的一部分,请选择样本;如果数据代表整个群体,请选择总体。随后,计算器会给出平均值、方差、标准差、数据个数和总和。
公式详解
首先计算平均值 \(\bar{x}\),其中 \(n\) 是数值的个数,\(x_i\) 表示每一个数值:
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$接着,计算每个数值与平均值的偏差,将其平方,再对这些平方值取平均。样本版本除以 \(n-1\),而总体版本除以 \(n\):
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2} \qquad \sigma = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \mu)^2}$$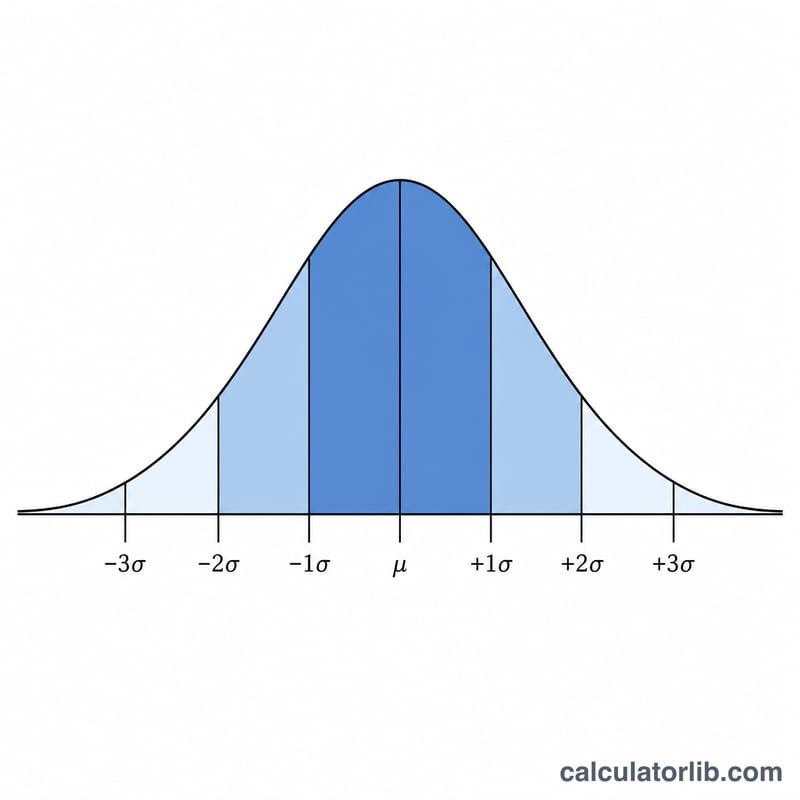
计算示例
以数据集 2, 4, 4, 4, 5, 5, 7, 9 为例。共有 \(n = 8\) 个数值,总和为 40,因此平均值为:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = 5$$各数值与 5 的偏差平方之和为 32。使用总体公式:
$$\sigma = \sqrt{\frac{32}{8}} = \sqrt{4} = 2$$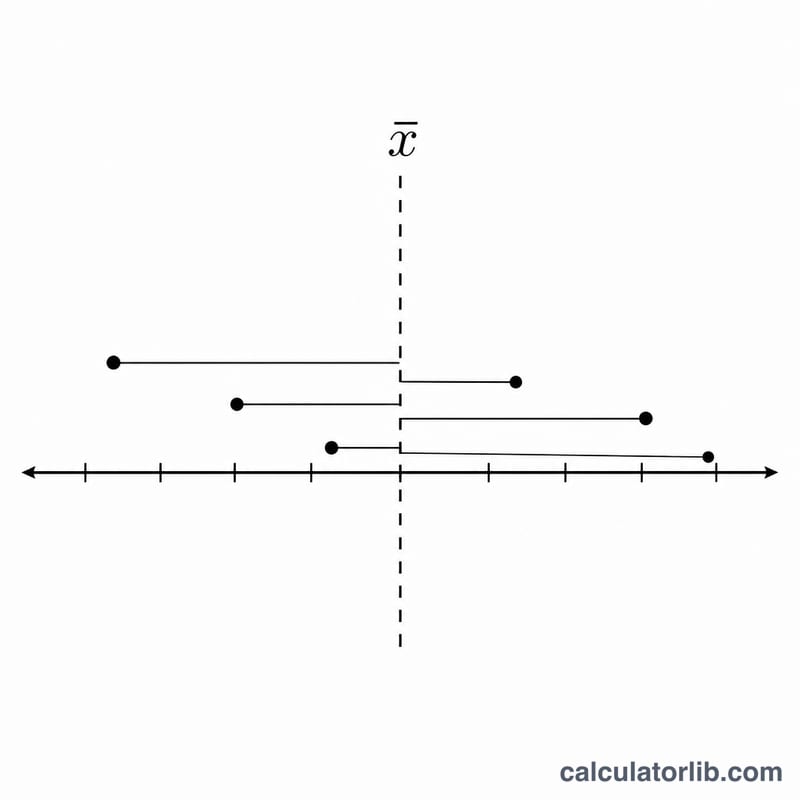
Más ejemplos resueltos
Estos ejemplos utilizan el mismo procedimiento cada vez: calcular la media \(\bar{x}\), restarla a cada valor para obtener las desviaciones, elevar al cuadrado esas desviaciones, sumarlas, dividir entre \(n-1\) para una muestra o entre \(n\) para una población, y por último tomar la raíz cuadrada. La única diferencia entre las dos versiones de la desviación estándar es entre qué se divide.
Ejemplo 1 — muestra frente a población con los mismos datos
Conjunto de datos (8 valores): 2, 4, 4, 4, 5, 5, 7, 9.
Paso 1 — media:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = \frac{40}{8} = 5$$Paso 2 — desviaciones al cuadrado:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
Paso 3 — suma de cuadrados:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+1+1+1+0+0+4+16 = 32$$Paso 4 — varianza y desviación estándar. Con \(n = 8\):
Muestra (dividir entre \(n-1 = 7\)):
$$s^2 = \frac{32}{7} \approx 4.5714 \qquad s = \sqrt{4.5714} \approx 2.1381$$Población (dividir entre \(n = 8\)):
$$\sigma^2 = \frac{32}{8} = 4 \qquad \sigma = \sqrt{4} = 2$$Así, los mismos datos dan una desviación estándar muestral de 2.1381 y una desviación estándar poblacional de 2. El valor muestral es ligeramente mayor porque dividir entre el número más pequeño \(n-1\) infla el resultado — esta es la corrección estándar que se utiliza cuando los datos son solo una muestra extraída de un grupo mayor.
Ejemplo 2 — valores decimales y negativos
Conjunto de datos (5 valores): -2, -1, 0, 3, 5.
Media:
$$\bar{x} = \frac{-2 + (-1) + 0 + 3 + 5}{5} = \frac{5}{5} = 1$$Desviaciones al cuadrado:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| -2 | -3 | 9 |
| -1 | -2 | 4 |
| 0 | -1 | 1 |
| 3 | 2 | 4 |
| 5 | 4 | 16 |
Suma de cuadrados:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+4+1+4+16 = 34$$Varianza y desviación estándar (con \(n = 5\)):
$$s^2 = \frac{34}{4} = 8.5 \qquad s = \sqrt{8.5} \approx 2.9155$$$$\sigma^2 = \frac{34}{5} = 6.8 \qquad \sigma = \sqrt{6.8} \approx 2.6077$$Los valores negativos se tratan exactamente igual que los positivos — elevar al cuadrado las desviaciones elimina el signo, de modo que un valor por debajo de la media aporta tanta dispersión como uno situado a la misma distancia por encima.
Ejemplo 3 — valores equiespaciados
Conjunto de datos (5 valores): 10, 20, 30, 40, 50.
Media:
$$\bar{x} = \frac{10+20+30+40+50}{5} = \frac{150}{5} = 30$$Desviaciones al cuadrado: las desviaciones son -20, -10, 0, 10, 20, por lo que los cuadrados son 400, 100, 0, 100, 400.
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 400+100+0+100+400 = 1000$$Varianza y desviación estándar (con \(n = 5\)):
$$s^2 = \frac{1000}{4} = 250 \qquad s = \sqrt{250} \approx 15.8114$$$$\sigma^2 = \frac{1000}{5} = 200 \qquad \sigma = \sqrt{200} \approx 14.1421$$Aunque los valores están perfectamente equiespaciados, la desviación estándar no es el propio espaciado (10) — es una medida cuadrática media de la distancia respecto a la media, que aquí resulta ser de aproximadamente 14.14 para toda la población.
Cómo interpretar tu resultado
La desviación estándar te indica la distancia típica entre un valor de los datos y la media, expresada en las mismas unidades que tus datos. Una desviación estándar pequeña significa que los valores se agrupan estrechamente alrededor de la media; una grande significa que están muy dispersos. Por sí sola, la cifra resulta más útil cuando se compara con la media y con la dispersión de otros conjuntos de datos medidos de la misma manera.
La regla empírica (68–95–99.7)
Cuando un conjunto de datos está aproximadamente distribuido normalmente (la conocida forma de campana simétrica), la desviación estándar \(\sigma\) delimita proporciones predecibles de los datos alrededor de la media \(\bar{x}\):
- Alrededor del 68% de los valores caen dentro de \(\pm 1\sigma\) de la media — el intervalo de \(\bar{x} - \sigma\) a \(\bar{x} + \sigma\).
- Alrededor del 95% caen dentro de \(\pm 2\sigma\).
- Alrededor del 99.7% caen dentro de \(\pm 3\sigma\).
Por ejemplo, si un conjunto de mediciones tiene \(\bar{x} = 100\) y \(\sigma = 15\), entonces aproximadamente el 68% de los datos se sitúa entre 85 y 115, alrededor del 95% entre 70 y 130, y casi todos entre 55 y 145. Esta regla es una aproximación que solo se cumple para datos con forma más o menos de campana — para distribuciones muy sesgadas o de colas pesadas los porcentajes reales pueden diferir sustancialmente.
Decidir si un valor es típico o atípico
Para juzgar un solo valor, mide a cuántas desviaciones estándar se encuentra de la media. Esta es la puntuación estandarizada, o puntuación z:
$$z = \frac{x - \bar{x}}{\sigma}$$Un valor con \(|z|\) menor que aproximadamente 1 es muy corriente; \(|z|\) cercano a 2 es algo inusual (solo alrededor del 5% de los datos normales se sitúa más allá de \(\pm 2\sigma\)); y \(|z|\) de 3 o más es raro (menos del 0.3% de los datos normales), por lo que \(\pm 2\sigma\) o \(\pm 3\sigma\) son umbrales informales comunes para señalar posibles valores atípicos. Estas son convenciones para inspeccionar datos, no una prueba definitiva — una puntuación z grande indica un punto que merece examinarse, no automáticamente un error.
Coeficiente de variación — dispersión relativa
Dado que la desviación estándar lleva unidades, comparar la dispersión entre conjuntos de datos con diferentes escalas o unidades puede resultar engañoso. El coeficiente de variación (CV) lo reescala como una fracción (o porcentaje) de la media:
$$\text{CV} = \frac{\sigma}{\bar{x}}$$Un conjunto de datos con \(\bar{x} = 30\) y \(\sigma \approx 15.81\) tiene \(\text{CV} \approx 15.81 / 30 \approx 0.527\), es decir, alrededor del 52.7% — una dispersión relativamente alta. Un CV del 5% indica valores muy agrupados cerca de la media, mientras que un 50% o más indica una alta variabilidad relativa. El CV solo tiene sentido para datos medidos en una escala de razón con media positiva; es indefinido o inestable cuando la media es cero o cercana a cero, y no debe usarse para datos que puedan ser negativos (como temperaturas en grados Celsius o cifras de pérdidas y ganancias).
常见问题
样本和总体有什么区别?当你的数据涵盖了群体中的每一个成员时,使用总体标准差。当你的数据只是一个样本时,使用样本标准差(除以 \(n-1\)),因为这样能对真实的离散程度给出偏差更小的估计。
为什么要对偏差取平方?取平方可以让所有偏差都变为正数,并让较大的误差获得更高的权重;最后再开平方根,则可以把结果还原到原始的单位。
方差能告诉我什么?方差是偏差平方的平均值,等于标准差的平方。它在许多统计公式中都很有用,但它的单位是原始单位的平方。