Công cụ này làm được gì
Máy Tính Trung Bình và Độ Lệch Chuẩn nhận vào một dãy số và trả về giá trị trung bình (số trung bình cộng), phương sai và độ lệch chuẩn. Trung bình cho biết tâm của dữ liệu, còn độ lệch chuẩn đo mức độ phân tán của các giá trị xung quanh tâm đó. Độ lệch chuẩn nhỏ nghĩa là các giá trị bám sát quanh trung bình; độ lệch chuẩn lớn nghĩa là chúng phân tán rộng.
Cách sử dụng
Nhập hoặc dán các con số vào ô nhập liệu, phân tách bằng dấu phẩy hoặc khoảng trắng. Chọn Mẫu nếu dữ liệu của bạn chỉ là một phần trích ra từ một nhóm lớn hơn, hoặc chọn Tổng thể nếu dữ liệu đại diện cho toàn bộ nhóm. Sau đó công cụ sẽ hiển thị giá trị trung bình, phương sai, độ lệch chuẩn, số lượng phần tử và tổng.
Giải thích các công thức
Trước tiên hãy tính giá trị trung bình \(\bar{x}\), trong đó \(n\) là số lượng giá trị và \(x_i\) là từng giá trị:
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$Tiếp theo, tính độ lệch của mỗi giá trị so với trung bình, bình phương nó lên rồi lấy trung bình các bình phương đó. Phiên bản mẫu chia cho \(n-1\); còn phiên bản tổng thể chia cho \(n\):
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2} \qquad \sigma = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i - \mu)^2}$$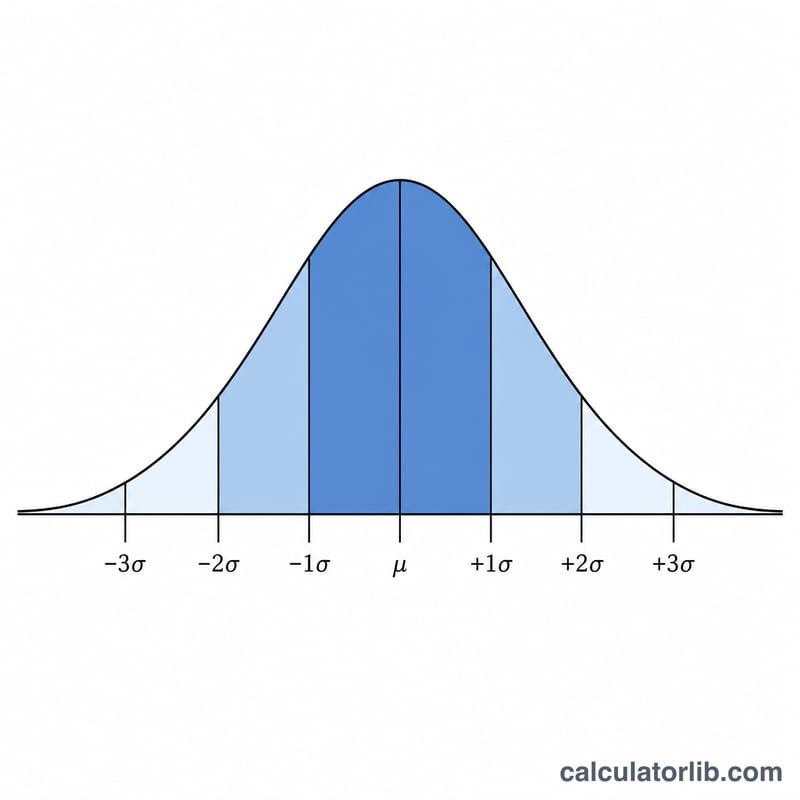
Ví dụ giải chi tiết
Xét tập dữ liệu 2, 4, 4, 4, 5, 5, 7, 9. Có \(n = 8\) giá trị với tổng bằng 40, nên giá trị trung bình là:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = 5$$Tổng các bình phương độ lệch so với 5 bằng 32. Áp dụng công thức tổng thể:
$$\sigma = \sqrt{\frac{32}{8}} = \sqrt{4} = 2$$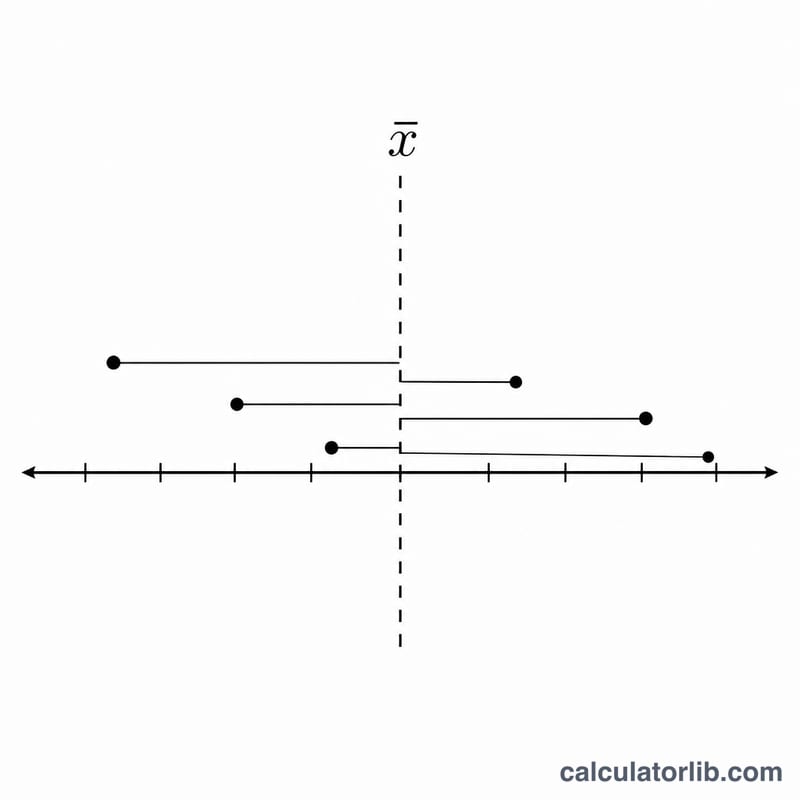
Thêm các ví dụ được giải chi tiết
Các ví dụ này đều dùng cùng một quy trình mỗi lần: tìm giá trị trung bình \(\bar{x}\), lấy từng giá trị trừ đi giá trị trung bình để có các độ lệch, bình phương các độ lệch đó, cộng chúng lại, chia cho \(n-1\) đối với mẫu hoặc chia cho \(n\) đối với tổng thể, và cuối cùng lấy căn bậc hai. Sự khác biệt duy nhất giữa hai phiên bản của độ lệch chuẩn là bạn chia cho số nào.
Ví dụ 1 — mẫu so với tổng thể trên cùng một dữ liệu
Tập dữ liệu (8 giá trị): 2, 4, 4, 4, 5, 5, 7, 9.
Bước 1 — giá trị trung bình:
$$\bar{x} = \frac{2+4+4+4+5+5+7+9}{8} = \frac{40}{8} = 5$$Bước 2 — các độ lệch bình phương:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
Bước 3 — tổng các bình phương:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+1+1+1+0+0+4+16 = 32$$Bước 4 — phương sai và độ lệch chuẩn. Với \(n = 8\):
Mẫu (chia cho \(n-1 = 7\)):
$$s^2 = \frac{32}{7} \approx 4.5714 \qquad s = \sqrt{4.5714} \approx 2.1381$$Tổng thể (chia cho \(n = 8\)):
$$\sigma^2 = \frac{32}{8} = 4 \qquad \sigma = \sqrt{4} = 2$$Vậy cùng một dữ liệu cho ra độ lệch chuẩn mẫu là 2.1381 và độ lệch chuẩn tổng thể là 2. Giá trị mẫu lớn hơn một chút vì chia cho số nhỏ hơn \(n-1\) làm tăng kết quả — đây là hiệu chỉnh chuẩn được dùng khi dữ liệu chỉ là một mẫu được lấy ra từ một nhóm lớn hơn.
Ví dụ 2 — giá trị thập phân và giá trị âm
Tập dữ liệu (5 giá trị): -2, -1, 0, 3, 5.
Giá trị trung bình:
$$\bar{x} = \frac{-2 + (-1) + 0 + 3 + 5}{5} = \frac{5}{5} = 1$$Các độ lệch bình phương:
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| -2 | -3 | 9 |
| -1 | -2 | 4 |
| 0 | -1 | 1 |
| 3 | 2 | 4 |
| 5 | 4 | 16 |
Tổng các bình phương:
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 9+4+1+4+16 = 34$$Phương sai và độ lệch chuẩn (với \(n = 5\)):
$$s^2 = \frac{34}{4} = 8.5 \qquad s = \sqrt{8.5} \approx 2.9155$$$$\sigma^2 = \frac{34}{5} = 6.8 \qquad \sigma = \sqrt{6.8} \approx 2.6077$$Các giá trị âm được xử lý hoàn toàn giống như các giá trị dương — việc bình phương các độ lệch loại bỏ dấu, nên một giá trị nằm dưới giá trị trung bình đóng góp vào độ phân tán đúng bằng một giá trị cách đều nó ở phía trên.
Ví dụ 3 — các giá trị cách đều nhau
Tập dữ liệu (5 giá trị): 10, 20, 30, 40, 50.
Giá trị trung bình:
$$\bar{x} = \frac{10+20+30+40+50}{5} = \frac{150}{5} = 30$$Các độ lệch bình phương: các độ lệch là -20, -10, 0, 10, 20, nên các bình phương là 400, 100, 0, 100, 400.
$$\sum_{i=1}^{n}(x_i - \bar{x})^2 = 400+100+0+100+400 = 1000$$Phương sai và độ lệch chuẩn (với \(n = 5\)):
$$s^2 = \frac{1000}{4} = 250 \qquad s = \sqrt{250} \approx 15.8114$$$$\sigma^2 = \frac{1000}{5} = 200 \qquad \sigma = \sqrt{200} \approx 14.1421$$Mặc dù các giá trị cách đều nhau một cách hoàn hảo, độ lệch chuẩn không phải là chính khoảng cách đó (10) — nó là thước đo trung bình bình phương gốc của khoảng cách so với giá trị trung bình, ở đây tính ra khoảng 14.14 cho toàn bộ tổng thể.
Diễn giải kết quả của bạn
Độ lệch chuẩn cho bạn biết khoảng cách điển hình giữa một giá trị dữ liệu và giá trị trung bình, được biểu thị bằng cùng đơn vị với dữ liệu của bạn. Độ lệch chuẩn nhỏ nghĩa là các giá trị co cụm chặt quanh giá trị trung bình; độ lệch chuẩn lớn nghĩa là chúng phân tán rộng. Bản thân con số này hữu ích nhất khi được so sánh với giá trị trung bình và với độ phân tán của các tập dữ liệu khác được đo theo cùng cách.
Quy tắc thực nghiệm (68–95–99.7)
Khi một tập dữ liệu xấp xỉ phân phối chuẩn (hình chuông đối xứng quen thuộc), độ lệch chuẩn \(\sigma\) vạch ra những tỷ lệ dữ liệu có thể dự đoán được quanh giá trị trung bình \(\bar{x}\):
- Khoảng 68% giá trị nằm trong phạm vi \(\pm 1\sigma\) quanh giá trị trung bình — khoảng từ \(\bar{x} - \sigma\) đến \(\bar{x} + \sigma\).
- Khoảng 95% nằm trong phạm vi \(\pm 2\sigma\).
- Khoảng 99.7% nằm trong phạm vi \(\pm 3\sigma\).
Ví dụ, nếu một tập các phép đo có \(\bar{x} = 100\) và \(\sigma = 15\), thì khoảng 68% dữ liệu nằm giữa 85 và 115, khoảng 95% nằm giữa 70 và 130, và gần như toàn bộ nằm giữa 55 và 145. Quy tắc này là một sự xấp xỉ chỉ đúng với dữ liệu có dạng chuông gần đúng — đối với các phân phối lệch mạnh hoặc có đuôi nặng thì tỷ lệ phần trăm thực tế có thể khác biệt đáng kể.
Quyết định xem một giá trị là điển hình hay là ngoại lệ
Để đánh giá một giá trị đơn lẻ, hãy đo xem nó nằm cách giá trị trung bình bao nhiêu độ lệch chuẩn. Đây là điểm số được chuẩn hóa, hay điểm z:
$$z = \frac{x - \bar{x}}{\sigma}$$Một giá trị với \(|z|\) nhỏ hơn khoảng 1 là rất bình thường; \(|z|\) gần 2 là hơi bất thường (chỉ khoảng 5% dữ liệu chuẩn nằm ngoài phạm vi \(\pm 2\sigma\)); và \(|z|\) từ 3 trở lên là hiếm (dưới 0.3% dữ liệu chuẩn), đó là lý do \(\pm 2\sigma\) hoặc \(\pm 3\sigma\) là các ngưỡng không chính thức thường dùng để đánh dấu các ngoại lệ có thể có. Đây là những quy ước để kiểm tra dữ liệu, không phải một phép kiểm định dứt khoát — một điểm z lớn báo hiệu một điểm đáng để xem xét, chứ không tự động là một lỗi.
Hệ số biến thiên — độ phân tán tương đối
Vì độ lệch chuẩn mang đơn vị, việc so sánh độ phân tán giữa các tập dữ liệu có thang đo hoặc đơn vị khác nhau có thể gây hiểu lầm. Hệ số biến thiên (CV) tái tỷ lệ nó thành một phân số (hoặc phần trăm) của giá trị trung bình:
$$\text{CV} = \frac{\sigma}{\bar{x}}$$Một tập dữ liệu với \(\bar{x} = 30\) và \(\sigma \approx 15.81\) có \(\text{CV} \approx 15.81 / 30 \approx 0.527\), hay khoảng 52.7% — một độ phân tán tương đối cao. CV bằng 5% cho thấy các giá trị tụ lại gần giá trị trung bình, trong khi 50% trở lên cho thấy độ biến thiên tương đối cao. CV chỉ có ý nghĩa đối với dữ liệu được đo trên thang tỷ lệ với giá trị trung bình dương; nó không xác định hoặc không ổn định khi giá trị trung bình bằng không hoặc gần bằng không, và không nên dùng cho dữ liệu có thể âm (chẳng hạn như nhiệt độ tính bằng độ Celsius hoặc các số liệu lãi và lỗ).
Câu hỏi thường gặp
Sự khác nhau giữa mẫu và tổng thể là gì? Hãy dùng độ lệch chuẩn tổng thể khi dữ liệu của bạn bao gồm mọi thành viên trong nhóm. Hãy dùng độ lệch chuẩn mẫu — công thức chia cho \(n-1\) — khi dữ liệu chỉ là một mẫu, vì cách này cho ước lượng ít thiên lệch hơn về mức phân tán thực sự.
Vì sao phải bình phương các độ lệch? Bình phương giúp mọi độ lệch đều dương và làm cho những sai lệch lớn có trọng số cao hơn; việc lấy căn bậc hai ở bước cuối đưa kết quả trở về đúng đơn vị ban đầu.
Phương sai cho tôi biết điều gì? Phương sai là trung bình của các bình phương độ lệch và bằng bình phương của độ lệch chuẩn. Nó hữu ích trong nhiều công thức thống kê nhưng được biểu diễn theo đơn vị bình phương.