这款方差计算器能做什么
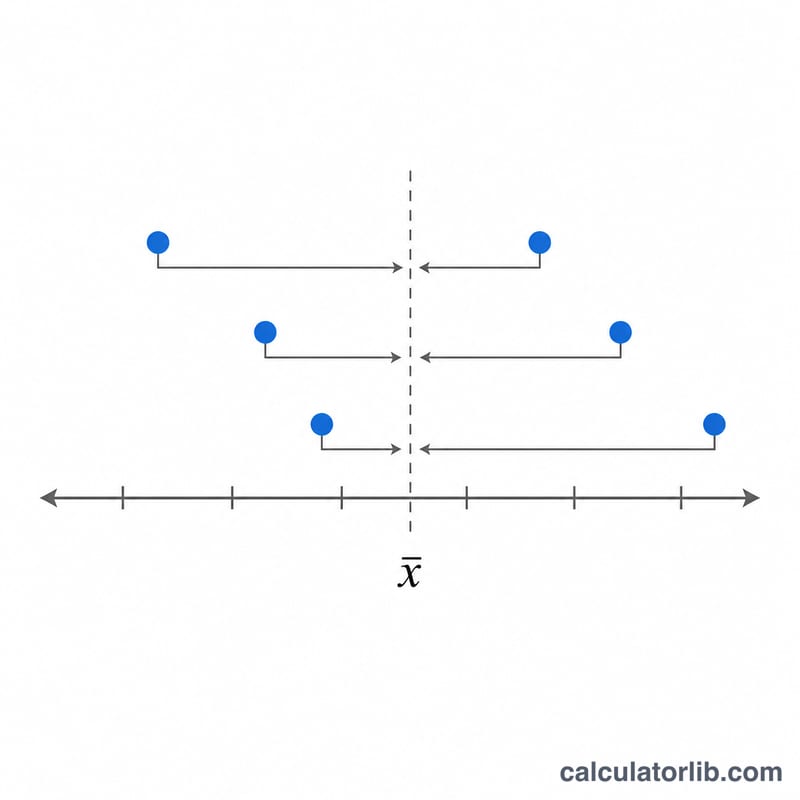
方差用来衡量一组数字围绕其平均值(均值)的离散程度。方差越小,说明各数值紧紧聚集在均值附近;方差越大,则说明数据分布得越分散。本计算器只需输入一串用逗号分隔的数字,就能一次性返回均值、方差和标准差,让你立刻判断数据的稳定性或波动性。
使用方法
这里只有一个输入框:输入数字(用逗号分隔)。你可以直接输入或粘贴数据,分隔符可以是逗号、分号、空格,甚至中文全角逗号,例如 4, 8, 15, 16, 23, 42。工具会自动拆分文本,将每一项转换为数字,并计算出:
- 均值——所有数值的算术平均数。
- 方差——各数值与均值之差的平方的平均值。
- 标准差——方差的平方根,与原始数据的单位相同。
背后的计算公式
本计算器采用 Apache Commons Math 的 StatUtils.variance 方法,计算的是样本方差(除以 n − 1,而非 n)。公式如下:
其中 \(x_i\) 表示每个数值,\(\bar{x}\) 表示均值,\(n\) 表示数值的个数。标准差则为 \(s = \sqrt{s^2}\)。采用 \(n - 1\)(即贝塞尔校正)可以在用样本估计总体方差时得到无偏估计量。
实例演算
假设你输入 2, 4, 6, 8:
- 均值 \(= (2 + 4 + 6 + 8) / 4 =\) 5
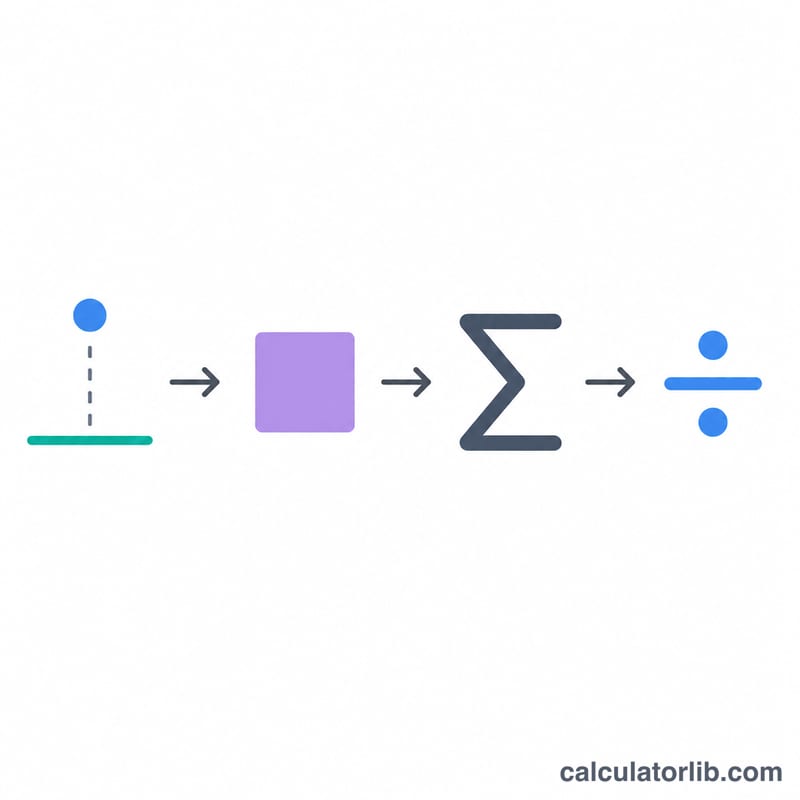
- 各项平方差:\((2-5)^2=9\)、\((4-5)^2=1\)、\((6-5)^2=1\)、\((8-5)^2=9\) → 合计 \(= 20\)
- 样本方差 \(= 20 / (4 - 1) =\) 6.667
- 标准差 \(= \sqrt{6.667} \approx\) 2.582
计算器会自动给出以上三个结果。
解释你的方差结果
方差衡量数据集中的数值相对于其均值的离散程度。因为每个偏差在求平均值之前都会被平方,所以结果的单位是平方的:如果你的数据是以厘米为单位的长度,方差的单位就是cm²;如果是测试分数,就是"分数的平方"。这就是为什么通常会一起引用标准差(SD)——方差的平方根——因为标准差返回数据的原始单位,可以直接与均值进行比较。
这里使用的公式是样本方差,它将平方偏差之和除以自由度(n-1):
$$s^2 = \frac{1}{n-1}\sum_{i=1}^{n}\left(x_i - \bar{x}\right)^2$$这个数字告诉你什么
- 方差永远不会是负数。平方偏差不能小于零,所以\(s^2 \ge 0\)总是成立。方差恰好为0只有一个意思:集合中的每个值都是相同的,标准差也是0。
- 更大意味着分布更广——但仅在相同单位内。方差400 cm²并不"大于"方差9 m²;首先转换为公共单位(9 m² = 90 000 cm²)。
- 方差不是无量纲的。均值大的数据自然会产生更大的绝对偏差。要比较不同均值或不同单位的数据集的分布,使用变异系数:
例如,集合{2, 4, 6, 8}有\(\bar{x} = 5\),\(s^2 = 6.667\),\(s = \sqrt{6.667} \approx 2.582\),给出\(\text{CV} = 2.582 / 5 \times 100\% \approx 51.6\%\)。变异系数仅对具有正均值的比率尺度数据有意义——对于以°C为单位的温度或靠近零的数据则不适用。
方差和数据的形状
如果数据大致呈正态分布(大致对称且钟形),经验法则——通常称为68–95–99.7法则——可以快速了解尺度:约68%的值落在\(\bar{x} \pm 1s\)范围内,约95%落在\(\bar{x} \pm 2s\)范围内,约99.7%落在\(\bar{x} \pm 3s\)范围内。这些百分比仅对接近正态的数据有效;对于偏态或多峰数据,它们可能会造成严重误导,而且仅通过方差无法揭示这一点——一定要查看原始数据值或绘图。
注意事项
- 异常值占主导。因为偏差是平方的,单个极端值会产生过大的影响。向{2, 4, 6}添加一个100会将样本方差从4推高到2300以上。如果结果看起来大得不切实际,在解释之前要检查是否有拼写错误、单位混淆或真正的极端观测。鲁棒替代方法(如四分位数间距或中位绝对偏差)受影响较小。
- 小样本给出不稳定的估计。当\(n = 4\)或\(n = 5\)时,即使底层过程不变,样本方差也可能在样本之间波动较大。将其视为粗略指示,而不是精确值。
- \(n = 1\)是未定义的。只有一个值时,分母\(n - 1\)为零,因此无法计算样本方差——单个观测无法提供关于分布的信息。
- 样本与总体。此计算器采用\(n-1\)除数,当你的数字是从更大群体中抽取的样本时,这是正确的选择。如果你的数字是整个总体,则总体方差改用\(n\),总是会小一些。
关键术语和符号
| 术语 | 符号 | 含义 |
|---|---|---|
| 均值(样本) | \(\bar{x}\) | 样本值的算术平均数,\(\bar{x} = \frac{1}{n}\sum x_i\)。读作"x-bar"。 |
| 均值(总体) | \(\mu\) | 总体中每个成员的平均值,\(\mu = \frac{1}{N}\sum x_i\)。读作"mu"。 |
| 样本大小/总体大小 | \(n\) / \(N\) | 使用的值的数量。按惯例,小写的\(n\)表示样本,大写的\(N\)表示整个总体。 |
| 偏差 | \(x_i - \bar{x}\) | 一个值离均值有多远。在均值上方为正,下方为负。偏差总和始终为零,这就是为什么在求平均值前要对其平方。 |
| 平方偏差 | \((x_i - \bar{x})^2\) | 偏差乘以自身——消除符号并放大大的间隙。 |
| 平方和 | SS | 所有平方偏差的总和,\(SS = \sum_{i=1}^{n}(x_i - \bar{x})^2\)。每个方差公式的分子。 |
| 样本方差 | \(s^2\) | \(s^2 = \dfrac{SS}{n-1}\)——样本对总体方差的无偏估计。这是此计算器返回的内容。 |
| 总体方差 | \(\sigma^2\) | \(\sigma^2 = \dfrac{1}{N}\sum (x_i - \mu)^2\)——当数据覆盖整个总体时使用。读作"西格玛平方"。 |
| 自由度 | \(df = n-1\) | 一旦固定均值,可以自由变化的偏差数量;知道均值和\(n-1\)个偏差就能确定最后一个。 |
| 贝塞尔修正 | 用\(n-1\)除 | 将\(n\)替换为\(n-1\)的调整。没有它,样本方差会系统性地低估总体方差,因为偏差是从样本自身的均值来衡量的。 |
| 标准差 | \(s\) / \(\sigma\) | 方差的平方根,用与数据相同的单位表示:\(s = \sqrt{s^2}\)。 |
| 变异系数 | CV | 相对分布,\(CV = s / \bar{x}\),通常以百分比形式显示。无量纲,因此可以比较具有不同单位或不同数量级的数据集。 |
| 范围 | — | 最大值减去最小值。一种粗略的分布度量,只使用两个值,忽略其间的所有内容。 |
| 异常值 | — | 与其余数据相差很大的值。因为偏差是平方的,异常值会不成比例地增加方差。 |
单位说明:方差总是用数据单位的平方来表示——秒数据给出s²,公斤给出kg²,货币金额给出"货币的平方",这在日常中没有意义。这就是为什么大多数报告引用标准差而不是方差本身的实际原因。
计算约定与边界情况
以下每个情况都在本计算器上实际运行过,结果一栏就是它真实返回的值。
| 情况 | 输入 | 结果 |
|---|---|---|
| 小数 0.1、0.2、0.3 | 0.1, 0.2, 0.3 | 0.01 |
| 偶数个数值 (1, 2, 3, 4) | 1, 2, 3, 4 | 1.6667 |
| 负值 (−3, −1, 4) | -3, -1, 4 | 13 |
| 列表中有 0 (0, 4, 9) | 0, 4, 9 | 20.3333 |
| 样本还是总体 (2, 4, 4, 4, 5, 5, 7, 9) | 2, 4, 4, 4, 5, 5, 7, 9 | 4.5714 |
| 只有一个数值 | 7 | 样本方差至少需要 2 个数值。 |
核对于 2026-11-08
常见问题
计算的是样本方差还是总体方差? 本工具计算的是样本方差,除以 n − 1。当你的数据是从更大总体中抽取的样本(而非整个总体)时,这是标准做法。
可以使用哪些分隔符? 逗号、分号、空格以及中文全角逗号都支持,因此即使是从别处粘贴过来、格式略显杂乱的数据,通常也能被正确解析。
为什么还要显示标准差? 标准差更易于理解,因为它与原始数据的单位一致;而方差的单位是原数据单位的平方。