यह वेरिएंस कैलकुलेटर क्या करता है
वेरिएंस (प्रसरण) यह बताता है कि कोई संख्याओं का समूह अपने औसत (माध्य) के आसपास कितना फैला हुआ है। अगर वेरिएंस कम है तो इसका मतलब है कि मान माध्य के बहुत पास-पास हैं; अगर वेरिएंस ज़्यादा है तो मान दूर-दूर बिखरे हुए हैं। यह कैलकुलेटर कॉमा से अलग की गई संख्याओं की एक सूची लेता है और एक ही चरण में माध्य, वेरिएंस और मानक विचलन (standard deviation) निकाल देता है — ताकि आप तुरंत समझ सकें कि आपका डेटा कितना स्थिर है या कितना उतार-चढ़ाव वाला है।
इसका उपयोग कैसे करें
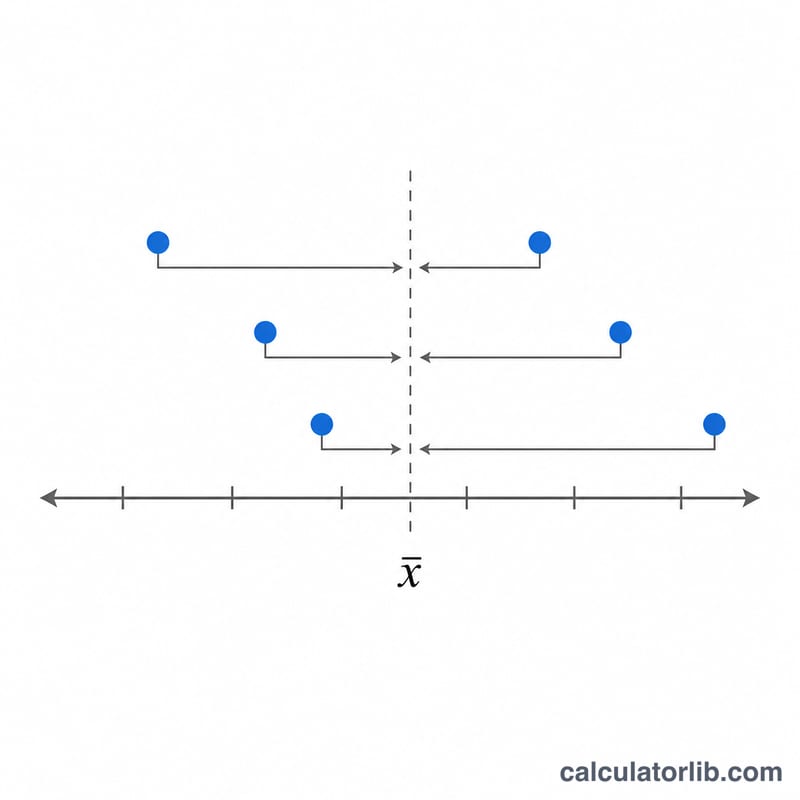
यहाँ सिर्फ़ एक इनपुट फ़ील्ड है: संख्याएँ दर्ज करें (कॉमा से अलग करके)। अपने डेटा पॉइंट्स कॉमा, सेमीकॉलन, स्पेस या फुल-विड्थ कॉमा से अलग करके टाइप करें या पेस्ट करें — उदाहरण के लिए 4, 8, 15, 16, 23, 42। यह टूल टेक्स्ट को अलग करता है, हर एंट्री को संख्या में बदलता है और निकालता है:
- माध्य (Mean) — सभी मानों का अंकगणितीय औसत।
- वेरिएंस (Variance) — माध्य से विचलनों के वर्ग का औसत।
- मानक विचलन (Standard Deviation) — वेरिएंस का वर्गमूल, जो आपके डेटा की ही इकाई में होता है।
इसके पीछे का सूत्र
यह कैलकुलेटर Apache Commons Math की StatUtils.variance विधि का उपयोग करता है, जो नमूना वेरिएंस (sample variance) निकालती है (n के बजाय n − 1 से भाग देकर)। सूत्र इस प्रकार है:
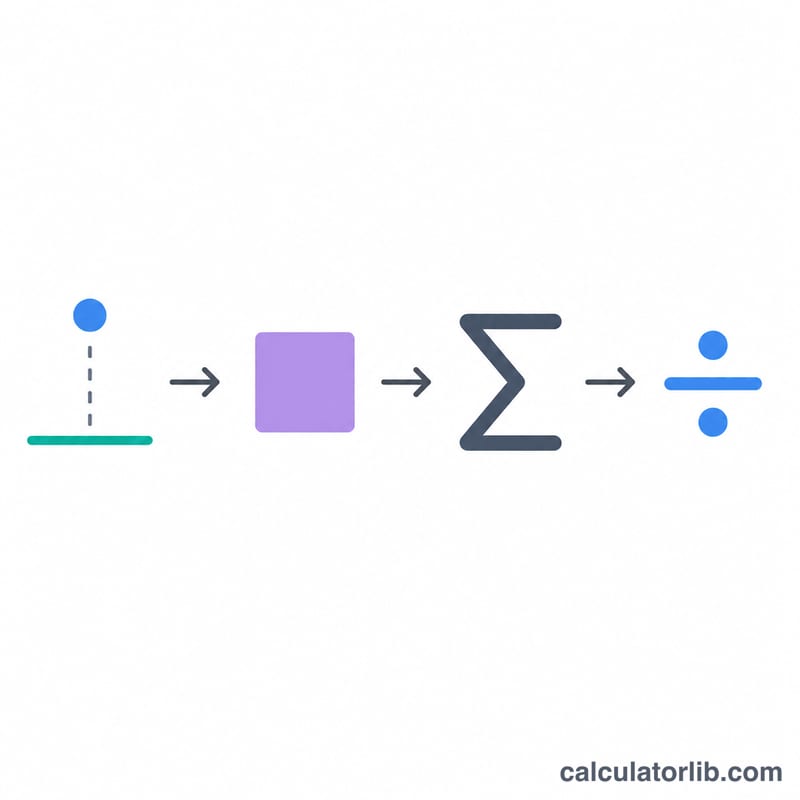
$$s^2 = \frac{\sum (x_i - \bar{x})^2}{n - 1}$$
जहाँ \(x_i\) हर मान है, \(\bar{x}\) माध्य है और \(n\) मानों की संख्या है। मानक विचलन बस \(s = \sqrt{s^2}\) होता है। \(n - 1\) (बेसेल का सुधार / Bessel's correction) का उपयोग करने से किसी बड़ी जनसंख्या से लिए गए नमूने के लिए वेरिएंस का निष्पक्ष (unbiased) अनुमान मिलता है।
हल किया हुआ उदाहरण
मान लीजिए आप 2, 4, 6, 8 दर्ज करते हैं:
- माध्य = \((2 + 4 + 6 + 8) / 4 = \mathbf{5}\)
- विचलनों के वर्ग: \((2-5)^2=9\), \((4-5)^2=1\), \((6-5)^2=1\), \((8-5)^2=9\) → योग = 20
- नमूना वेरिएंस = \(20 / (4 - 1) = \mathbf{6.667}\)
- मानक विचलन = \(\sqrt{6.667} \approx \mathbf{2.582}\)
कैलकुलेटर ये तीनों आँकड़े अपने आप दिखा देता है।
अपने विचरण परिणाम की व्याख्या करना
विचरण मापता है कि डेटा सेट में मान अपने माध्य से कितनी दूर तक फैले हुए हैं। क्योंकि प्रत्येक विचलन को औसत करने से पहले वर्ग किया जाता है, परिणाम वर्गित इकाइयाँ देता है: यदि आपका डेटा सेंटीमीटर में लंबाई है, तो विचरण cm² में है; यदि वे परीक्षा अंक हैं, तो यह "बिंदु वर्ग" में है। यही कारण है कि मानक विचलन (SD) — विचरण का वर्गमूल — आमतौर पर इसके साथ उद्धृत किया जाता है, क्योंकि SD डेटा की मूल इकाइयों पर लौटता है और माध्य के विरुद्ध सीधे तुलना की जा सकती है।
यहाँ उपयोग किया जाने वाला सूत्र नमूना विचरण है, जो वर्गित विचलन के योग को स्वतंत्रता की डिग्री \(n-1\) से विभाजित करता है:
$$s^2 = \frac{1}{n-1}\sum_{i=1}^{n}\left(x_i - \bar{x}\right)^2$$संख्या आपको क्या बताती है
- विचरण कभी नकारात्मक नहीं होता। वर्गित विचलन शून्य से कम नहीं हो सकते, इसलिए \(s^2 \ge 0\) हमेशा। बिल्कुल 0 का विचरण केवल एक अर्थ है: सेट में प्रत्येक मान समान है, और SD भी 0 है।
- बड़ा मतलब अधिक फैलाव — लेकिन केवल समान इकाइयों के भीतर। 400 cm² का विचरण 9 m² के विचरण से "बड़ा" नहीं है; पहले एक सामान्य इकाई में परिवर्तित करें (9 m² = 90 000 cm²)।
- विचरण मापनी-मुक्त नहीं है। बड़े माध्य वाला डेटा स्वाभाविक रूप से बड़े निरपेक्ष विचलन पैदा करता है। विभिन्न माध्य या विभिन्न इकाइयों वाले डेटा सेट के फैलाव की तुलना करने के लिए, विचरण गुणांक का उपयोग करें:
उदाहरण के लिए, सेट {2, 4, 6, 8} में \(\bar{x} = 5\), \(s^2 = 6.667\) और \(s = \sqrt{6.667} \approx 2.582\) है, जो \(\text{CV} = 2.582 / 5 \times 100\% \approx 51.6\%\) देता है। CV केवल सकारात्मक माध्य वाले अनुपात-मापनी डेटा के लिए अर्थपूर्ण है — यह °C में तापमान के लिए या शून्य के पास केंद्रित डेटा के लिए उपयुक्त नहीं है।
विचरण और डेटा का आकार
यदि डेटा लगभग सामान्य रूप से वितरित हैं (मोटे तौर पर सममित और घंटी के आकार का), तो अनुभवजन्य नियम — अक्सर 68–95–99.7 नियम कहा जाता है — मापनी की त्वरित समझ देता है: लगभग 68% मान \(\bar{x} \pm 1s\) के भीतर आते हैं, लगभग 95% \(\bar{x} \pm 2s\) के भीतर, और लगभग 99.7% \(\bar{x} \pm 3s\) के भीतर। ये प्रतिशत सन्निकटन हैं जो केवल लगभग-सामान्य डेटा के लिए होते हैं; तिरछे या बहु-मोडल डेटा के लिए वे बहुत भ्रामक हो सकते हैं, और विचरण अकेले उसे प्रकट नहीं करेगा — हमेशा कच्चे मानों या ग्राफ को भी देखें।
सावधानियाँ
- बाहरी मान प्रभावशाली हैं। क्योंकि विचलन वर्गित हैं, एक एकल चरम मान का अत्यधिक प्रभाव है। {2, 4, 6} में 100 का एक बिंदु जोड़ने से नमूना विचरण 4 से 2300 से अधिक तक चला जाता है। यदि आपका परिणाम अविश्वसनीय रूप से बड़ा दिख रहा है, तो इसकी व्याख्या करने से पहले टाइपो, इकाई मिश्रण, या एक वास्तविक चरम अवलोकन की जाँच करें। मजबूत विकल्प जैसे कि अंतरचतुर्थक रेंज या माध्यिका निरपेक्ष विचलन कम प्रभावित हैं।
- छोटे नमूने अस्थिर अनुमान देते हैं। \(n = 4\) या \(n = 5\) के साथ, नमूना विचरण एक नमूने से अगले तक व्यापक रूप से बदल सकता है यहाँ तक कि जब अंतर्निहित प्रक्रिया अपरिवर्तित हो। इसे एक सटीक मान नहीं, बल्कि एक मोटा संकेत मानें।
- \(n = 1\) अपरिभाषित है। एक एकल मान के साथ हर \(n - 1\) शून्य है, इसलिए नमूना विचरण की गणना नहीं की जा सकती — एक अकेला अवलोकन फैलाव के बारे में कोई जानकारी नहीं देता।
- नमूना बनाम जनसंख्या। यह कैलकुलेटर \(n-1\) भाजक लागू करता है, जो सही विकल्प है जब आपकी संख्याएं एक बड़े समूह से खींचा गया नमूना हैं। यदि आपकी संख्याएं संपूर्ण जनसंख्या हैं, तो जनसंख्या विचरण इसके बजाय \(n\) का उपयोग करता है और हमेशा कुछ हद तक छोटा होगा।
मुख्य शर्तें और प्रतीक
| शब्द | प्रतीक | अर्थ |
|---|---|---|
| माध्य (नमूना) | \(\bar{x}\) | नमूना मानों का अंकगणितीय औसत, \(\bar{x} = \frac{1}{n}\sum x_i\)। "x-bar" के रूप में पढ़ें। |
| माध्य (जनसंख्या) | \(\mu\) | जनसंख्या के प्रत्येक सदस्य का औसत, \(\mu = \frac{1}{N}\sum x_i\)। "mu" के रूप में पढ़ें। |
| नमूना आकार / जनसंख्या आकार | \(n\) / \(N\) | उपयोग किए गए मानों की गणना। निम्न-केस \(n\) परंपरागत रूप से एक नमूने को दर्शाता है, बड़े \(N\) पूरी जनसंख्या को। |
| विचलन | \(x_i - \bar{x}\) | एक मान माध्य से कितनी दूर है। माध्य से ऊपर सकारात्मक, नीचे नकारात्मक। विचलन हमेशा शून्य तक जोड़ते हैं, इसलिए औसत करने से पहले उन्हें वर्ग किया जाता है। |
| वर्गित विचलन | \((x_i - \bar{x})^2\) | विचलन को स्वयं से गुणा किया जाता है — चिन्ह को हटाता है और बड़े अंतराल को बढ़ाता है। |
| वर्गों का योग | SS | सभी वर्गित विचलन का कुल, \(SS = \sum_{i=1}^{n}(x_i - \bar{x})^2\)। प्रत्येक विचरण सूत्र का अंश। |
| नमूना विचरण | \(s^2\) | \(s^2 = \dfrac{SS}{n-1}\) — नमूने से जनसंख्या विचरण का निष्पक्ष अनुमान। यह वह है जो यह कैलकुलेटर लौटाता है। |
| जनसंख्या विचरण | \(\sigma^2\) | \(\sigma^2 = \dfrac{1}{N}\sum (x_i - \mu)^2\) — जब डेटा पूरी जनसंख्या को कवर करता है तो उपयोग किया जाता है। "sigma squared" के रूप में पढ़ें। |
| स्वतंत्रता की डिग्री | \(df = n-1\) | विचलन की संख्या जो माध्य के निश्चित होने के बाद भिन्न हो सकती है; माध्य और \(n-1\) विचलन को जानने से अंतिम विचलन निर्धारित होता है। |
| बेसेल का सुधार | \(n-1\) से विभाजित करना | समायोजन जो \(n\) को \(n-1\) से बदलता है। इसके बिना, नमूना विचरण व्यवस्थित रूप से जनसंख्या विचरण को कम आंकता है, क्योंकि विचलन नमूने के अपने माध्य से मापा जाता है। |
| मानक विचलन | \(s\) / \(\sigma\) | विचरण का वर्गमूल, डेटा के समान इकाइयों में व्यक्त: \(s = \sqrt{s^2}\)। |
| विचरण गुणांक | CV | सापेक्ष फैलाव, \(CV = s / \bar{x}\), आमतौर पर प्रतिशत के रूप में दिखाया जाता है। विमाहीन, इसलिए यह विभिन्न इकाइयों या परिमाणों वाले डेटा सेट की तुलना करता है। |
| परिसर | — | अधिकतम माइनस न्यूनतम। एक कच्चा फैलाव उपाय जो केवल दो मानों का उपयोग करता है और बीच में सब कुछ अनदेखा करता है। |
| बाहरी मान | — | बाकी डेटा से बहुत दूर एक मान। क्योंकि विचलन वर्गित हैं, बाहरी मान विचरण को असंगत रूप से बढ़ाते हैं। |
इकाइयों का नोट: विचरण हमेशा डेटा की इकाइयों के वर्ग में व्यक्त किया जाता है — डेटा के सेकंड s² देते हैं, किलोग्राम kg² देते हैं, मुद्रा राशि "मुद्रा वर्ग" देती है, जिसका कोई दैनिक अर्थ नहीं है। यह व्यावहारिक कारण है कि अधिकांश रिपोर्ट स्वयं विचरण के बजाय मानक विचलन का उद्धरण देते हैं।
नियम और सीमांत स्थितियाँ
नीचे की हर स्थिति इसी कैलकुलेटर पर चलाकर देखी गई है; परिणाम वाला कॉलम वही है जो यह वास्तव में लौटाता है।
| स्थिति | इनपुट | परिणाम |
|---|---|---|
| दशमलव 0.1, 0.2, 0.3 | 0.1, 0.2, 0.3 | 0.01 |
| मानों की सम संख्या (1, 2, 3, 4) | 1, 2, 3, 4 | 1.6667 |
| ऋणात्मक मान (−3, −1, 4) | -3, -1, 4 | 13 |
| सूची में शून्य (0, 4, 9) | 0, 4, 9 | 20.3333 |
| नमूना या जनसंख्या (2, 4, 4, 4, 5, 5, 7, 9) | 2, 4, 4, 4, 5, 5, 7, 9 | 4.5714 |
| केवल एक मान | 7 | नमूना प्रसरण के लिए कम से कम 2 मान चाहिए। |
2026-11-08 को जाँचा गया
अक्सर पूछे जाने वाले प्रश्न
क्या यह नमूना वेरिएंस का उपयोग करता है या जनसंख्या वेरिएंस का? यह नमूना वेरिएंस (sample variance) निकालता है, यानी n − 1 से भाग देता है। जब आपकी संख्याएँ पूरी जनसंख्या के बजाय एक नमूने को दर्शाती हैं, तब यही मानक तरीका होता है।
मैं कौन-से सेपरेटर इस्तेमाल कर सकता हूँ? कॉमा, सेमीकॉलन, स्पेस और फुल-विड्थ एशियाई-शैली के कॉमा — सभी काम करते हैं, इसलिए कहीं से पेस्ट किया गया अव्यवस्थित डेटा भी आमतौर पर सही ढंग से पढ़ लिया जाता है।
मानक विचलन भी क्यों दिखाया जाता है? मानक विचलन को समझना आसान होता है क्योंकि यह आपके मूल डेटा की ही इकाई में होता है, जबकि वेरिएंस वर्ग की हुई इकाई में होता है।