這個變異數計算機能做什麼
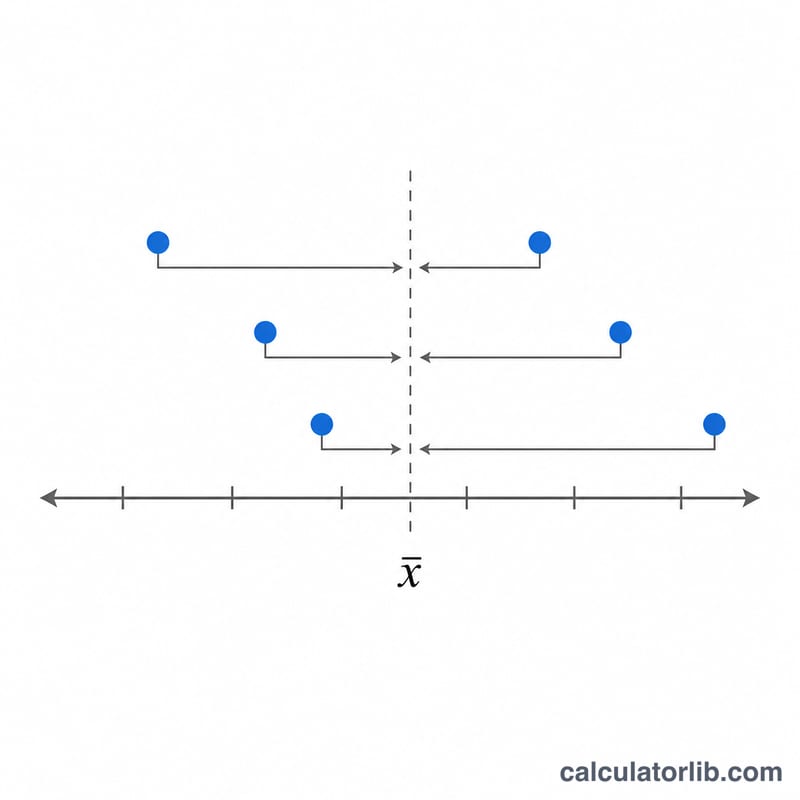
變異數(Variance)用來衡量一組數字相對於平均數(Mean)的離散程度。變異數越小,代表數值集中、緊貼平均數;變異數越大,則表示數值分布得越分散。這個計算機只需要一組以逗號分隔的數字,就能一次幫你算出平均數、變異數與標準差,讓你立刻判斷資料的穩定度或波動性。
如何使用
畫面上只有一個輸入欄位:輸入數字(以逗號分隔)。把你的資料貼上或輸入即可,可用逗號、分號、空格,甚至全形逗號分隔,例如 4, 8, 15, 16, 23, 42。計算機會自動拆解文字、將每一項轉換成數字,並算出:
- 平均數——所有數值的算術平均。
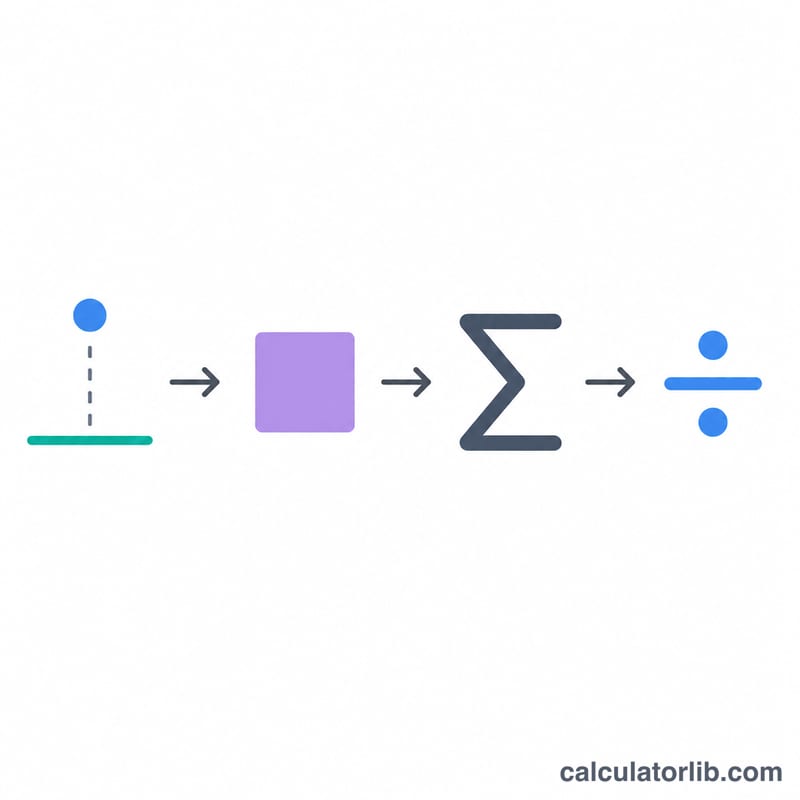
- 變異數——各數值與平均數差距平方後的平均。
- 標準差——變異數開平方根,單位與原始資料相同。
背後的計算公式
本計算機採用 Apache Commons Math 的 StatUtils.variance 方法,計算的是樣本變異數(除以 n − 1,而非 n)。公式如下:
$$s^2 = \frac{1}{n-1}\sum_{i=1}^{n}\left(x_i - \bar{x}\right)^2$$
其中 \(x_i\) 為每一個數值,\(\bar{x}\) 為平均數,\(n\) 為數值的個數。標準差則為 \(s = \sqrt{s^2}\)。除以 \(n - 1\)(即貝索校正,Bessel's correction)能讓樣本變異數成為母體變異數的不偏估計值。
實際範例
假設你輸入 2, 4, 6, 8:
- 平均數 = \((2 + 4 + 6 + 8) / 4 = 5\)
- 各項差距平方:\((2-5)^2=9\)、\((4-5)^2=1\)、\((6-5)^2=1\)、\((8-5)^2=9\) → 總和 = 20
- 樣本變異數 = \(20 / (4 - 1) = 6.667\)
- 標準差 = \(\sqrt{6.667} \approx 2.582\)
計算機會自動同時顯示這三個結果。
理解您的變異數結果
變異數衡量資料集中的值與平均數相差多遠。因為每個偏差在計算平均值前都經過平方,結果的單位是平方單位:如果您的資料是以公分表示的長度,變異數的單位為 cm²;如果是測試分數,單位為「分數平方」。這就是為什麼標準差(SD)— 變異數的平方根 — 通常與變異數一起引用,因為標準差回到資料的原始單位,可直接與平均數比較。
此處使用的公式是樣本變異數,將平方偏差的總和除以自由度 \(n-1\):
$$s^2 = \frac{1}{n-1}\sum_{i=1}^{n}\left(x_i - \bar{x}\right)^2$$這個數字告訴您什麼
- 變異數永遠不為負。 平方偏差不可能小於零,所以 \(s^2 \ge 0\) 始終成立。變異數恰好為 0 只有一個意思:集合中的每個值都相同,標準差也是 0。
- 較大的變異數表示更大的分散 — 但僅限於相同的單位。 400 cm² 的變異數不會「大於」9 m² 的變異數;請先轉換為共同單位(9 m² = 90 000 cm²)。
- 變異數不是無尺度的。 平均數較大的資料自然會產生較大的絕對偏差。若要比較平均數或單位不同的資料集的分散度,請使用變異係數:
例如,集合 {2, 4, 6, 8} 的 \(\bar{x} = 5\)、\(s^2 = 6.667\) 且 \(s = \sqrt{6.667} \approx 2.582\),給出 \(\text{CV} = 2.582 / 5 \times 100\% \approx 51.6\%\)。變異係數僅適用於平均數為正的比率尺度資料 — 不適用於攝氏度 (°C) 溫度或以零附近為中心的資料。
變異數與資料的形狀
如果資料近似正態分布(大約對稱且呈鐘形),經驗法則 — 通常稱為 68–95–99.7 法則 — 可快速指示尺度:約 68% 的值落在 \(\bar{x} \pm 1s\) 範圍內,約 95% 在 \(\bar{x} \pm 2s\) 範圍內,約 99.7% 在 \(\bar{x} \pm 3s\) 範圍內。這些百分比是僅對近似正態分布資料成立的近似值;對於偏斜或多峰值資料,它們可能會嚴重誤導,而變異數本身無法揭示這一點 — 應始終查看原始值或圖表。
注意事項
- 極端值主導。 因為偏差經過平方,單一極端值會產生過大的影響。將一個 100 的點添加到 {2, 4, 6} 會將樣本變異數從 4 推高到超過 2,300。如果您的結果看起來不太合理地大,請在解釋前檢查是否有打字錯誤、單位混淆或真正的極端觀察值。穩健的替代方案(如四分位距或中位數絕對偏差)受影響較少。
- 小樣本給出不穩定的估計。 當 \(n = 4\) 或 \(n = 5\) 時,即使基礎過程未改變,樣本變異數也可能在樣本之間波動很大。將其視為粗略指示,而非精確值。
- \(n = 1\) 未定義。 單一值時,分母 \(n - 1\) 為零,所以無法計算樣本變異數 — 單一觀察值不提供任何關於分散度的訊息。
- 樣本與母體。 此計算器使用 \(n-1\) 除數,當您的數字是從較大群體中抽取的樣本時,這是正確的選擇。如果您的數字是整個母體,母體變異數使用 \(n\) 代替,結果會略小一些。
主要術語和符號
| 術語 | 符號 | 意義 |
|---|---|---|
| 平均數(樣本) | \(\bar{x}\) | 樣本值的算術平均數,\(\bar{x} = \frac{1}{n}\sum x_i\)。讀作「x-bar」。 |
| 平均數(母體) | \(\mu\) | 母體每個成員的平均數,\(\mu = \frac{1}{N}\sum x_i\)。讀作「mu」。 |
| 樣本大小/母體大小 | \(n\) / \(N\) | 使用的值的計數。小寫 \(n\) 習慣上表示樣本,大寫 \(N\) 表示整個母體。 |
| 偏差 | \(x_i - \bar{x}\) | 一個值距離平均數有多遠。高於平均數為正,低於平均數為負。偏差總是加總為零,這就是為什麼它們在計算平均值前要平方。 |
| 平方偏差 | \((x_i - \bar{x})^2\) | 偏差乘以自己 — 移除符號並擴大大的間隙。 |
| 平方和 | SS | 所有平方偏差的總計,\(SS = \sum_{i=1}^{n}(x_i - \bar{x})^2\)。每個變異數公式的分子。 |
| 樣本變異數 | \(s^2\) | \(s^2 = \dfrac{SS}{n-1}\) — 樣本中母體變異數的無偏估計。這是本計算器返回的值。 |
| 母體變異數 | \(\sigma^2\) | \(\sigma^2 = \dfrac{1}{N}\sum (x_i - \mu)^2\) — 用於資料涵蓋整個母體時。讀作「sigma 平方」。 |
| 自由度 | \(df = n-1\) | 一旦平均數被固定,偏差自由變化的數量;知道平均數和 \(n-1\) 個偏差可以確定最後一個。 |
| 貝塞爾校正 | 除以 \(n-1\) | 將 \(n\) 替換為 \(n-1\) 的調整。沒有它,樣本變異數會系統性地低估母體變異數,因為偏差是根據樣本自身的平均數測量的。 |
| 標準差 | \(s\) / \(\sigma\) | 變異數的平方根,用與資料相同的單位表示:\(s = \sqrt{s^2}\)。 |
| 變異係數 | CV | 相對分散度,\(CV = s / \bar{x}\),通常以百分比表示。無量綱,所以可比較不同單位或數量級的資料集。 |
| 範圍 | — | 最大值減去最小值。一種粗略的分散度測度,僅使用兩個值並忽略其間的所有數據。 |
| 極端值 | — | 遠離其他資料的值。因為偏差經過平方,極端值會不成比例地增加變異數。 |
單位附註: 變異數總是以資料單位的平方表示 — 秒數資料給出 s²、公斤給出 kg²、貨幣金額給出「貨幣平方」,這在日常生活中沒有意義。這就是為什麼大多數報告引用標準差而非變異數本身的實際原因。
常見問題
這是樣本變異數還是母體變異數?本工具計算的是樣本變異數,除以 n − 1。當你的數字代表的是「樣本」而非「整個母體」時,這是標準的計算方式。
可以使用哪些分隔符號?逗號、分號、空格,以及亞洲常用的全形逗號都可以,因此即使是貼上來的雜亂資料,通常也能正確解析。
為什麼還要顯示標準差?因為標準差的單位與原始資料相同,比較容易解讀;而變異數的單位是平方後的單位,較不直觀。
計算慣例與邊界情況
以下每個情況都在本計算機上實際執行過,結果欄就是它真正回傳的值。
| 情況 | 輸入 | 結果 |
|---|---|---|
| 小數 0.1、0.2、0.3 | 0.1, 0.2, 0.3 | 0.01 |
| 偶數個數值 (1, 2, 3, 4) | 1, 2, 3, 4 | 1.6667 |
| 負值 (−3, −1, 4) | -3, -1, 4 | 13 |
| 清單中有 0 (0, 4, 9) | 0, 4, 9 | 20.3333 |
| 樣本還是母體 (2, 4, 4, 4, 5, 5, 7, 9) | 2, 4, 4, 4, 5, 5, 7, 9 | 4.5714 |
| 只有一個數值 | 7 | 樣本變異數至少需要 2 個數值。 |
核對於 2026-11-08
相關計算機
- 標準差計算機——標準差公式與怎麼算。
- 平均數計算器——計算算術平均值。
- 平均值計算機——平均數、中位數、總和。
- 變異係數計算器(CV %)——離散係數線上計算。