Что такое функция softmax?
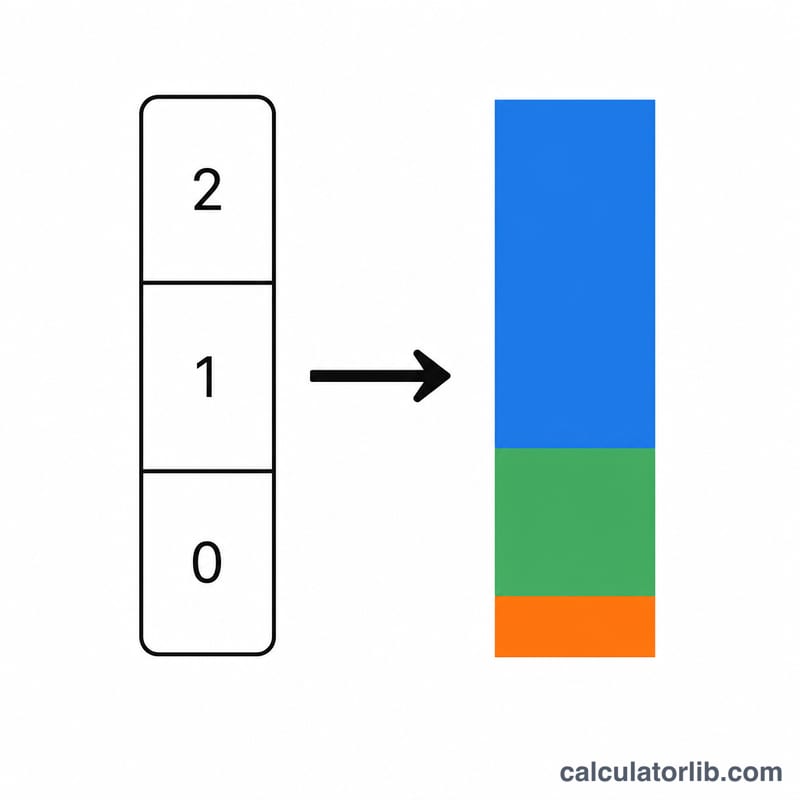
Функция softmax принимает вектор из K действительных чисел и превращает его в распределение вероятностей: каждое выходное значение строго лежит между 0 и 1, а сумма всех K значений равна ровно 1. Это стандартная функция активации выходного слоя в нейросетевых классификаторах — она переводит «сырые» оценки модели (логиты) в вероятности классов. Поскольку функция безразмерна, входные данные — это чистые числа без единиц измерения.
Как пользоваться калькулятором
Введите входной вектор в поле в виде списка чисел, разделённых запятыми, пробелами или переносами строк (например, 1, 2, 3). Числа могут быть положительными, отрицательными, нулевыми или дробными. Нажмите «Рассчитать» — и вы получите вероятность softmax для каждой компоненты, сумму всех выходных значений (она должна равняться 1) и argmax — индекс (начиная с 1) наибольшей вероятности.
Разбор формулы
Для каждой компоненты j функция softmax вычисляется так: \(\sigma(z)_j = \dfrac{e^{z_j}}{\sum_{k} e^{z_k}}\). Возведение в экспоненту делает каждый член положительным, а деление на общую сумму нормирует их так, чтобы итог был равен 1. Для численной устойчивости калькулятор перед возведением в экспоненту вычитает из каждого элемента максимальное значение m:
$$\sigma(\mathbf{x})_i = \frac{e^{\,x_i - \max(\mathbf{x})}}{\displaystyle\sum_{j=1}^{K} e^{\,x_j - \max(\mathbf{x})}}$$Общий множитель \(e^{-m}\) сокращается, поэтому результат остаётся прежним, но при больших входных значениях не возникает переполнения.
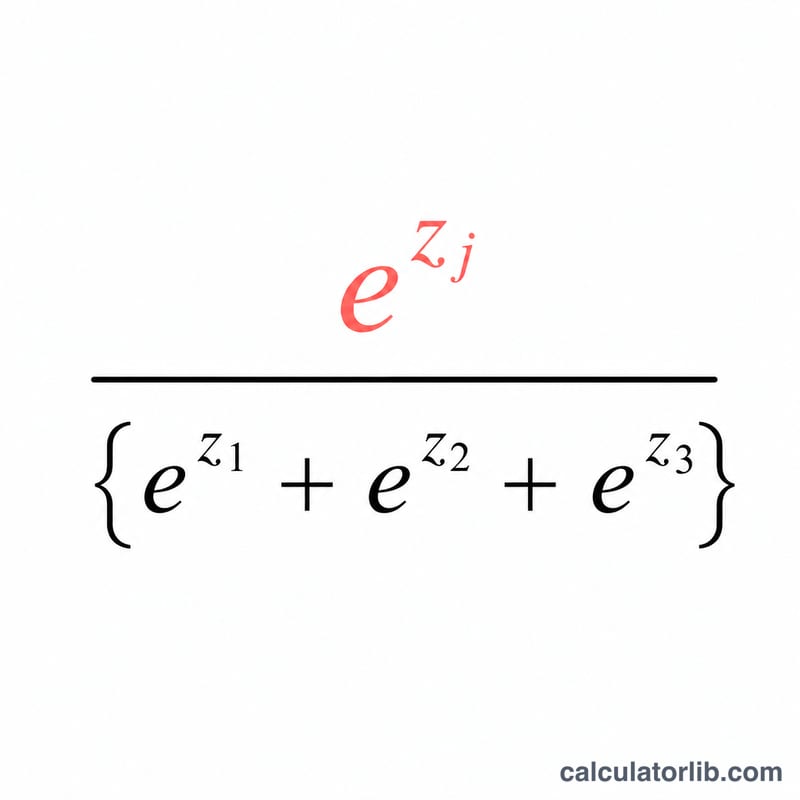
Разбор примера
Для \(z = (1, 2, 3)\): \(e^{1} = 2{,}71828\), \(e^{2} = 7{,}38906\), \(e^{3} = 20{,}08554\), в сумме \(30{,}19287\). Поделив каждое на сумму, получаем
$$\sigma = (0{,}09003,\ 0{,}24473,\ 0{,}66524)$$что в сумме даёт 1. Argmax — индекс 3, соответствующий наибольшему входному числу, с вероятностью \(0{,}66524\).
Частые вопросы
Почему сумма выходных значений всегда равна 1? Каждая экспонента делится на сумму всех экспонент, и эта нормировка гарантирует итог, равный 1.
Что будет, если все входные значения одинаковы? Получится равномерное распределение, где каждое выходное значение равно \(1/K\).
Изменится ли результат, если прибавить ко всем входам одну и ту же константу? Нет. Softmax инвариантна к сдвигу: прибавление одной и той же константы c ко всем входам не меняет результат — именно поэтому вычитание максимума безопасно.
Выходные значения softmax для разных входных векторов
В таблице показаны выходные значения softmax для нескольких входных векторов, вычисленные по формуле \(\sigma(\mathbf{x})_i = e^{x_i - \max(\mathbf{x})} / \sum_j e^{x_j - \max(\mathbf{x})}\). Значения округлены до 4 знаков после запятой; выходные значения всегда в сумме дают 1.
| Входной вектор | Выход softmax | Argmax (позиция) | Комментарий |
|---|---|---|---|
| (1, 1, 1) | 0.3333, 0.3333, 0.3333 | Ничья (все равны) | Равные входы дают равномерное распределение, по 1/3 каждому. |
| (1, 2, 3) | 0.0900, 0.2447, 0.6652 | 3-я | Разница в 1 между входами даёт умеренно уверенный результат. |
| (-1, 0, 1) | 0.0900, 0.2447, 0.6652 | 3-я | Совпадает с (1, 2, 3), так как это тот же вектор, сдвинутый на 2. |
| (0, 0, 5) | 0.0066, 0.0066, 0.9867 | 3-я | Один большой вход доминирует; два равных входа делят остаток поровну. |
| (2, 4, 6) | 0.0159, 0.1173, 0.8668 | 3-я | Вектор (1, 2, 3), умноженный на 2, даёт более резкое распределение. |
| (10, 20, 30) | ≈0.0000 (2.06×10⁻⁹), ≈0.0000 (4.54×10⁻⁵), 1.0000 (0.99995) | 3-я | Почти «one-hot» (почти единичный вектор). Приём вычитания максимума предотвращает переполнение при больших входах. |
Эффект масштабирования: умножение каждого входа на коэффициент больше 1 увеличивает разрывы между ними, поэтому наибольший элемент получает больше вероятности, и распределение становится резче. Ранжирование (argmax) никогда не меняется. Масштабирование коэффициентом между 0 и 1 сглаживает распределение к равномерному.