这款置信区间计算器能做什么
置信区间会根据单个样本,给出一个很可能包含真实总体均值的取值范围。本计算器接收你的样本统计量,并返回区间下限、区间上限以及误差范围——这样你就能像这样报告结果:"真实均值在 X 与 Y 之间,置信水平为 95%。"它采用 z 分布(正态分布)进行计算,这也是当样本量较大或总体标准差已知时的标准方法。
你需要输入的数据
- 样本均值——样本数据的平均值(也就是区间的中心点)。
- 标准差——样本数据的离散程度。
- 样本量——样本中观测值的个数。
- 置信水平——你希望达到的把握程度,常用值为 90%、95% 或 99%。
计算公式
计算器按以下步骤进行运算:
- 标准误差 = 标准差 ÷ √(样本量)
- Z 值 = 对应置信水平的正态分布临界值(例如 90% 对应 1.645,95% 对应 1.96,99% 对应 2.576)
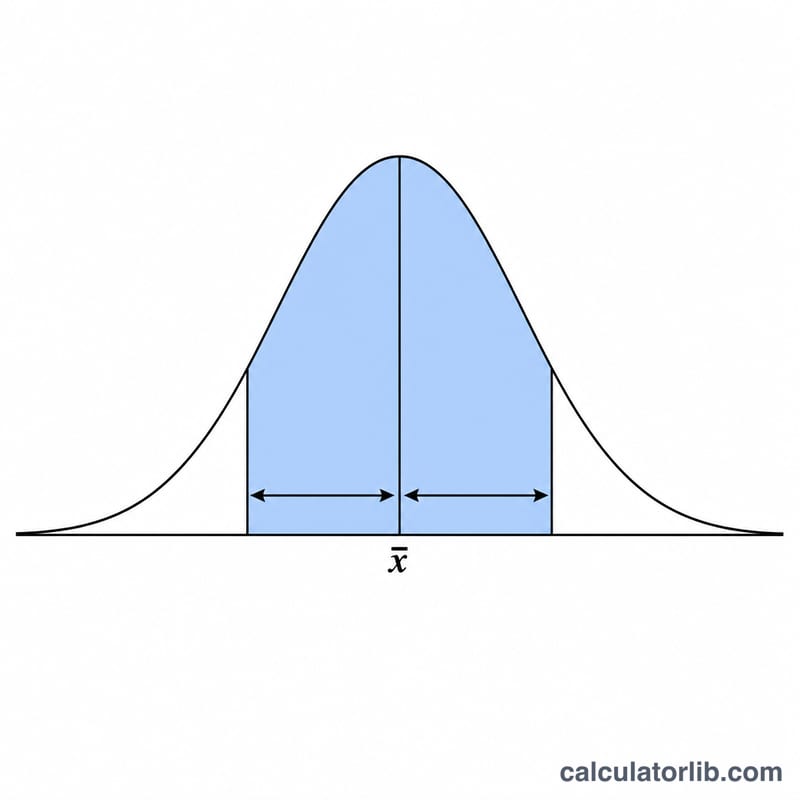
- 误差范围 = Z 值 × 标准误差
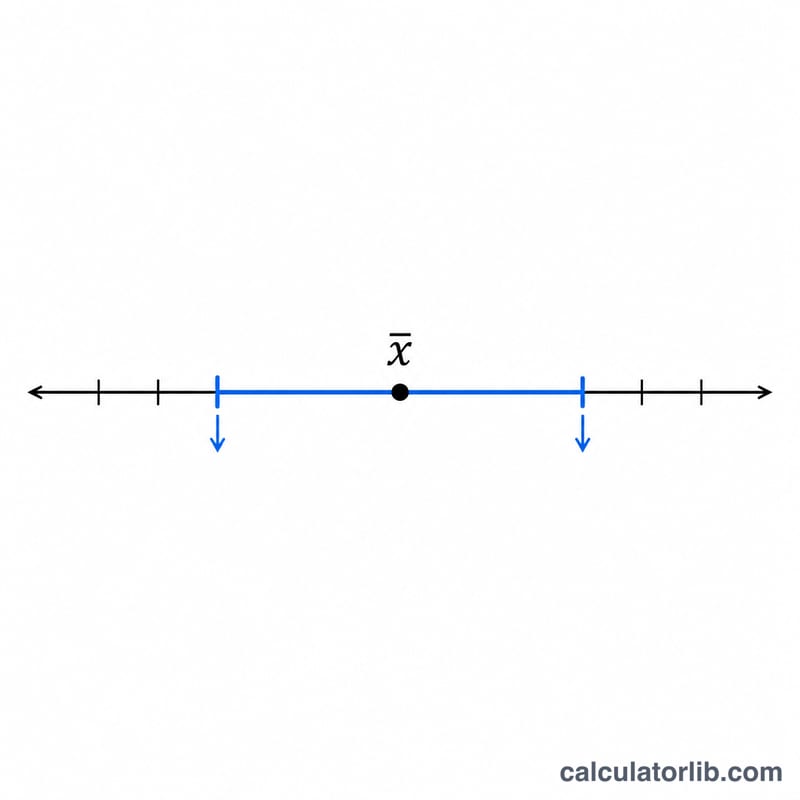
- 置信区间 = 样本均值 ± 误差范围
计算器通过在 alpha/2 处求逆累积概率来确定 Z 值,其中 alpha = 1 − 置信水平。这样可以把不确定性均匀地分配到分布的两侧尾部。
实例演示
假设你的样本均值为 100,标准差为 15,样本量为 36,并选择 95% 的置信水平。
- 标准误差 = 15 ÷ √36 = 15 ÷ 6 = 2.5
- 95% 对应的 Z 值 = 1.96
- 误差范围 = 1.96 × 2.5 = 4.9
- 区间下限 = 100 − 4.9 = 95.1
- 区间上限 = 100 + 4.9 = 104.9
你可以有 95% 的把握认为,真实总体均值落在 95.1 与 104.9 之间。
解释您的置信区间
置信区间报告从样本中得出的总体均值 \(\mu\) 的一系列合理值。它支持的陈述是关于该程序的,而不是关于您屏幕上的单个区间的:如果您重复相同的抽样并每次计算 95% 区间,这些区间中约有 95% 会包含真实均值。真实均值是一个固定的(但未知的)数字 — 它不会移动。随机的是区间,因为它是从随机样本计算出来的。因此说"μ 在这两个数字之间的概率为 95%"是不正确的;一旦计算出区间,\(\mu\) 要么在其中,要么不在。(贝叶斯可信区间确实支持直接概率陈述,但它们是不同的构造,需要先验。)
宽度:什么使估计精确
更窄的区间意味着更精确的估计。半宽是误差范围
$$\text{误差范围} = z \cdot \frac{s}{\sqrt{n}}$$因此有三件事会影响它:
- 样本量 \(n\) — 误差范围随 \(\sqrt{n}\) 缩小,而不是随 \(n\)。样本量增加四倍会使误差范围减半;再次将误差范围减半需要原始样本的 16 倍。这就是为什么精度的改进成本很高。
- 置信水平 — 更高的水平使用更大的临界值,所以在相同数据上 99% 区间总是比 95% 区间更宽(\(2.576/1.960 \approx 1.31\),约宽 31%)。置信度和精度相互权衡。
- 离散度 \(s\) — 数据的变异性越大,对于相同的 \(n\),给出的区间越宽。
读取参考值或假设值
检查您关心的值 — 差异或变化分数为 0、目标均值、去年的数字、规格值 — 是否在区间内。如果参考值位于双侧 \(100(1-\alpha)\%\) 区间的外侧,则对应的 \(H_0: \mu = \text{参考值}\) 的双侧检验在显著性水平 \(\alpha = 1 - \text{置信水平}\) 处拒绝;如果它位于内侧,检验不拒绝。95% 区间和在 \(\alpha = 0.05\) 水平下的双侧检验是同一计算的两个方面。"未拒绝"意味着数据与该值兼容 — 不是说该值是真实的,也不是说效应为零。
还要实质性地读取区间的端点。[0.2, 19.8] 的区间排除零但与从微不足道到很大的效应兼容;这与 [9.5, 10.5] 的情况不同,后者排除零并更准确地确定了效应。
均值,而不是个体
此区间覆盖总体的平均值,而不是下一个观察。当 \(n\) 很大时,均值的区间可能非常窄,但单个值仍然分散很广。如果您需要一个范围来包含单个未来观察,那是预测区间,它更宽,因为它不仅要反映关于均值的不确定性,还要反映个体变异。
您所依赖的假设
- 来自感兴趣的总体的随机、独立观察。方便样本、聚集数据、对同一主题的重复测量和时间序列数据违反了这一点,区间通常会太窄。
- 均值的抽样分布的近似正态性。 根据中心极限定理,对于中等偏斜的数据,一旦 \(n \ge 30\),这通常是合理的;对于小样本,总体本身应该大致正常,对于高度偏斜的数据或重尾值,即使 \(n = 30\) 也可能不够。
- 已知 \(\sigma\) 或大样本近似。 此计算器使用正态临界值 \(z\)。当从小样本估计 \(\sigma\) 为 \(s\) 时,自由度为 \(n-1\) 的 \(t\) 分布是严格正确的选择,并给出稍宽的区间;一旦 \(n\) 大约为 30,差异就很小。
- 无系统误差。 该区间仅量化抽样变异性。它不能纠正选择偏差、无响应、措辞不当、仪器校准不当或测量误差。有偏差的样本会在错误值周围产生一个紧密的区间 — 大 \(n\) 会使这个错误的区间更紧,而不是更好。
最后,如果您从同一数据计算许多区间,至少有一个未命中目标的概率会远高于 \(\alpha\);这需要进行多重性校正。本部分是一般统计信息,不是针对特定研究设计的定制建议。
关键术语和变量
| 术语 | 符号 | 含义 |
|---|---|---|
| 样本均值 | \(\bar{x}\) | 观察数据的算术平均数,\(\bar{x} = \frac{1}{n}\sum x_i\)。它是您测量的值,也是区间的中心。 |
| 总体均值 | \(\mu\) | 整个总体的真实平均值。未知的、固定的,以及区间试图包含的量。 |
| 样本标准差 | \(s\) | 个体观察的离散程度,用 \(n-1\) 在分母中计算:\(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\)。 |
| 总体标准差 | \(\sigma\) | 总体中的真实离散程度。很少已知;\(s\) 用作其估计,这就是为什么存在 \(t\) 分布。 |
| 样本量 | \(n\) | 独立观察的数量。通过 \(\sqrt{n}\) 决定精度。 |
| 均值的标准误 | SE | \(\text{SE} = s/\sqrt{n}\)。样本均值和总体均值之间的典型距离。有别于 \(s\):\(s\) 描述了个体的分散程度,不会随着收集更多数据而缩小;SE 描述了均值的不确定性,随着 \(n\) 增长而缩小。 |
| 误差范围 | MoE | \(\text{MoE} = z \times \text{SE}\)。区间的半宽 — "±数字"与估计一起报告。 |
| 置信水平 | \(1-\alpha\) | 以这种方式构建的会捕获 \(\mu\) 的区间的长期比例(例如 95%)。以十进制形式写的相同值(0.95)是置信系数。 |
| Alpha | \(\alpha\) | \(\alpha = 1 - \text{置信水平}\);长期未命中率和等价双尾检验的显著性水平。 |
| Alpha 除以 2 | \(\alpha/2\) | 双侧区间每端的尾部面积 — 95% 区间每个尾部为 0.025。 |
| 临界值 / z-分数 | \(z\) | 来自标准正态分布的乘数 \(\Phi^{-1}(1-\alpha/2)\)。z 分数更一般地说明一个值离均值有多少个标准差。 |
| 下界 | LB | \(\bar{x} - \text{MoE}\),区间的较小端点。 |
| 上界 | UB | \(\bar{x} + \text{MoE}\),较大的端点。区间写作 \([\text{下界},\ \text{上界}]\)。 |
| 自由度 | \(df = n-1\) | 估计 \(\bar{x}\) 后剩余的独立信息片数。在使用 \(t\) 替代 \(z\) 时选择 \(t\) 表的行。 |
| 点估计 | \(\bar{x}\) | \(\mu\) 的单个最佳猜测数。它不显示自己的不确定性。 |
| 区间估计 | \([\text{下界}, \text{上界}]\) | 具有规定置信水平的范围。报告点估计和其精度,这就是为什么期刊和标准机构通常更喜欢它。 |
| 置信区间 | CI | 一个参数的范围 — 这里是总体均值。随着 \(n \to \infty\) 趋向于单个点。 |
| 预测区间 | PI | 单个未来观察的范围。总是比同一数据上的 CI 更宽,因为它包括个体级别的变异;它不会随着 \(n\) 增长而缩小到一个点,而是大致收敛到 \(\mu \pm z\sigma\)。 |
常见问题
区间越宽是不是结果越差? 区间越宽反映出不确定性越大。提高置信水平(例如从 95% 提高到 99%)或样本量较小都会让区间变宽;而样本量越大,区间则越窄。
"95% 置信"到底是什么意思? 如果你多次重复抽样,并每次都构建一个区间,那么其中大约 95% 的区间会包含真实的总体均值。
该用 z 还是 t? 本工具使用 z(正态)分布,适用于样本量较大或总体标准差已知的情形。对于样本量很小且总体标准差未知的情况,从理论上讲,t 分布会更精确。