這個信賴區間計算器能幫你做什麼
信賴區間是根據單一樣本,估算出一段「很可能包含母體真實平均數」的數值範圍。本計算器會接收你的樣本統計量,並回傳區間下限、上限以及誤差範圍(margin of error),讓你能直接得出像是「在 95% 信賴水準下,真實平均數落在 X 到 Y 之間」這樣的結論。它採用 z 分配(常態分配)來計算,這是在樣本數夠大、或已知母體標準差時最常用的標準做法。
你需要輸入的資料
- 樣本平均數——你的樣本資料平均值(也就是區間的中心點)。
- 標準差——樣本數值分散的程度。
- 樣本數——樣本中的觀測值個數。
- 信賴水準——你希望估計有多大把握,常見為 90%、95% 或 99%。
計算公式
計算器會依照以下步驟運算:
- 標準誤 = 標準差 ÷ √(樣本數)
- Z 值 = 對應信賴水準的常態分配臨界值(例如 90% 為 1.645、95% 為 1.96、99% 為 2.576)
- 誤差範圍 = Z 值 × 標準誤
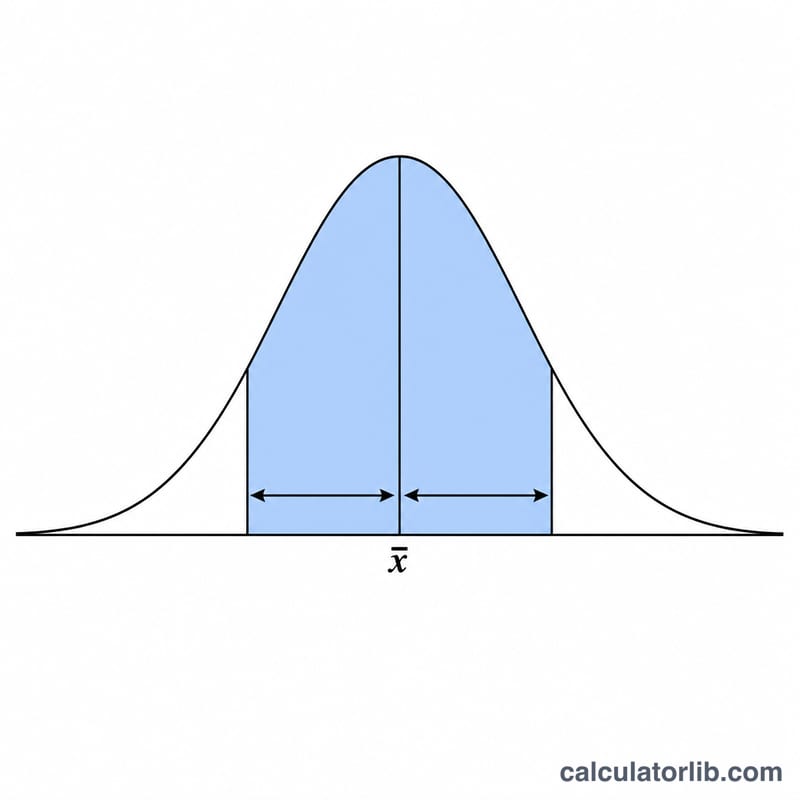
- 信賴區間 = 樣本平均數 ± 誤差範圍
計算器會在 alpha/2 處取累積機率的反函數來求出 Z 值,其中 alpha = 1 −信賴水準。這樣可將不確定性平均分配到分配的左右兩尾。
實例演算
假設你的樣本平均數為 100、標準差為 15、樣本數為 36,並選擇 95% 信賴水準。
- 標準誤 = 15 ÷ √36 = 15 ÷ 6 = 2.5
- 95% 對應的 Z 值 = 1.96
- 誤差範圍 = 1.96 × 2.5 = 4.9
- 下限 = 100 − 4.9 = 95.1
- 上限 = 100 + 4.9 = 104.9
因此,你有 95% 的把握,母體真實平均數會落在 95.1 到 104.9 之間。
解釋您的信賴區間
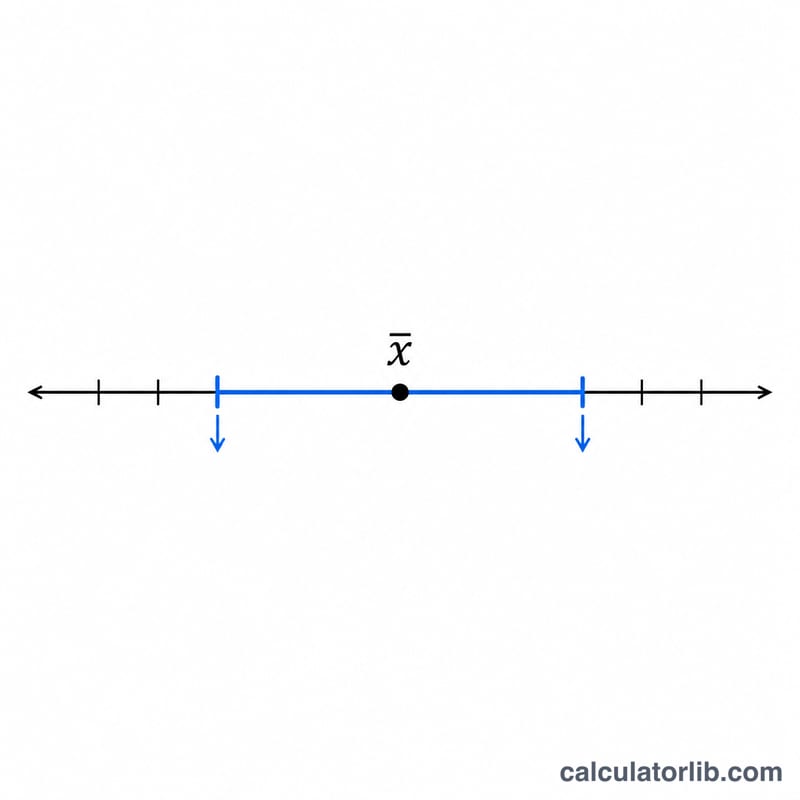
信賴區間報告人口平均數μ的一系列可信值,由您的樣本構建。它支持的陳述是關於程序的,而非關於您螢幕上的這一個區間:如果您重複相同的抽樣並每次計算95%區間,大約95%的這些區間將包含真實平均數。真實平均數是一個固定的(但未知的)數字——它不會移動。隨機的是區間,因為它是從隨機樣本計算出來的。因此說「有95%的概率μ位於這兩個數字之間」是不正確的;一旦計算了區間,μ要麼在其內,要麼不在。(貝葉斯可信區間確實支持直接概率陳述,但它們是不同的構造,需要先驗。)
寬度:什麼使得估計精確
較窄的區間意味著更精確的估計。半寬度是邊際誤差
$$\text{MoE} = z \cdot \frac{s}{\sqrt{n}}$$所以三件事影響它:
- 樣本大小 \(n\) ——邊際隨著 \(\sqrt{n}\) 縮小,而不是隨著 \(n\)。使樣本四倍會使邊際誤差減半;再次減半邊際誤差需要原始樣本的16倍。這就是為什麼精確度很快變得昂貴的原因。
- 信賴水準 ——更高的水準使用更大的臨界值,因此99%區間總是比相同數據上的95%區間寬(\(2.576/1.960 \approx 1.31\),約寬31%)。信賴與精確度相互權衡。
- 離散度 \(s\) ——更多可變數據在相同 \(n\) 情況下給出更寬的區間。
讀取參考值或假設值
檢查您關心的值——差異或變化分數為0、目標平均數、去年的數據、規格值——是否在區間內。如果參考值位於雙側 \(100(1-\alpha)\%\) 區間之外,相應的 \(H_0: \mu = \text{參考值}\) 的雙側檢驗在顯著性水準 \(\alpha = 1 - \text{信賴水準}\) 處拒絕;如果在內部,檢驗不拒絕。95%區間和 \(\alpha = 0.05\) 的雙側檢驗是同一計算的兩個視角。「未拒絕」意味著數據與該值相容——不是說該值為真,也不是說效應為零。
也要實質性地讀取區間的端點。[0.2, 19.8] 的區間排除零但與從微小到大的效應相容;這與 [9.5, 10.5] 不同,後者排除零並確定了效應。
平均值,不是個別值
此區間覆蓋人口的平均值,而不是下一個觀察值。對於大的 \(n\),平均值的區間可以非常窄,而個別值仍然分散得很廣。如果您需要一個可能包含單個未來觀察值的範圍,那就是預測區間,它寬得多,因為它除了必須吸收平均值的不確定性外,還必須吸收個別變異。
您依賴的假設
- 來自感興趣人口的隨機、獨立觀察值。便利樣本、聚集數據、相同受試者的重複測量和時間序列數據違反此點,區間通常會太窄。
- 樣本平均數分佈的近似常態性。根據中央極限定理,對於中等偏斜數據,一旦 \(n \ge 30\),這通常是合理的;對於小樣本,人口本身應該大致正常,對於高度偏斜的數據或重型離群值,即使 \(n = 30\) 也可能不夠。
- 已知-\(\sigma\) 或大-\(n\) 近似。本計算器使用常態臨界值 \(z\)。當 \(\sigma\) 由小樣本的 \(s\) 估計時,具有 \(n-1\) 自由度的 \(t\) 分佈是嚴格正確的選擇並給出稍寬的區間;一旦 \(n\) 約在30以上,差異很小。
- 無系統誤差。區間僅量化抽樣變異性。它不會更正選擇偏差、無響應、措辭不當的問題、未校準的儀器或測量誤差。有偏見的樣本圍繞錯誤值產生緊密區間——大的 \(n\) 使該錯誤區間更緊密,而不是更好。
最後,如果您從相同數據計算許多區間,至少一個錯過其目標的機會遠高於 \(\alpha\);這需要多重性調整。本節是一般統計信息,而不是針對特定研究設計的量身定制建議。
關鍵術語和變數
| 術語 | 符號 | 含義 |
|---|---|---|
| 樣本平均數 | \(\bar{x}\) | 您觀察數據的算術平均值,\(\bar{x} = \frac{1}{n}\sum x_i\)。這是您測量的東西,也是區間的中心。 |
| 人口平均數 | \(\mu\) | 整個人口的真實平均值。未知、固定,是區間試圖包含的量。 |
| 樣本標準差 | \(s\) | 個別觀察值的分散,用分母中的 \(n-1\) 計算:\(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\)。 |
| 人口標準差 | \(\sigma\) | 人口中的真實分散。很少已知;\(s\) 被用作其估計,這就是為什麼 \(t\) 分佈存在的原因。 |
| 樣本大小 | \(n\) | 獨立觀察值的數量。通過 \(\sqrt{n}\) 驅動精確度。 |
| 平均數的標準誤 | SE | \(\text{SE} = s/\sqrt{n}\)。樣本平均數和人口平均數之間的典型距離。與 \(s\) 不同:\(s\) 描述個體分散程度,隨著收集更多數據不會縮小;SE 描述平均數的不確定程度,隨著 \(n\) 增長而縮小。 |
| 邊際誤差 | MoE | \(\text{MoE} = z \times \text{SE}\)。區間的半寬——「± 數字」與估計一起報告。 |
| 信賴水準 | \(1-\alpha\) | 以這種方式構建的區間的長期比例,將捕獲 \(\mu\)(例如95%)。以小數形式寫入的相同值(0.95)是信賴係數。 |
| Alpha | \(\alpha\) | \(\alpha = 1 - \text{信賴水準}\);長期缺失率,以及等效雙側檢驗的顯著性水準。 |
| 二分之Alpha | \(\alpha/2\) | 雙側區間每一端的尾部面積——95%區間每條尾部0.025。 |
| 臨界值 / z 分數 | \(z\) | 標準常態分佈的乘數 \(\Phi^{-1}(1-\alpha/2)\)。z 分數更普遍地說明一個值距離平均數有多少個標準差。 |
| 下界 | LB | \(\bar{x} - \text{MoE}\),區間的較小端點。 |
| 上界 | UB | \(\bar{x} + \text{MoE}\),較大的端點。區間寫作 \([\text{LB},\ \text{UB}]\)。 |
| 自由度 | \(df = n-1\) | 估計 \(\bar{x}\) 後剩下的獨立信息片段的數量。使用 \(t\) 作為 \(z\) 的替代方案時,選擇 \(t\) 表的行。 |
| 點估計 | \(\bar{x}\) | 對 \(\mu\) 的單個最佳猜測數字。它沒有指示其自身的不確定性。 |
| 區間估計 | \([\text{LB}, \text{UB}]\) | 具有指定信賴水準的範圍。報告點估計及其精確度,這就是為什麼期刊和標準機構普遍更喜歡它的原因。 |
| 信賴區間 | CI | 參數的範圍——這裡是人口平均數。隨著 \(n \to \infty\) 縮小至單個點。 |
| 預測區間 | PI | 單個未來觀察值的範圍。總是比相同數據上的 CI 更寬,因為它包括個別級別的變異;隨著 \(n\) 增長,它不會縮小到一點,而是大致收斂到 \(\mu \pm z\sigma\)。 |
常見問題
區間越寬代表結果越差嗎?區間越寬,代表不確定性越高。提高信賴水準(例如從 95% 提高到 99%)或樣本數越小,都會讓區間變寬;反之,樣本數越大,區間就越窄。
「95% 信賴」到底是什麼意思?意思是如果你重複抽樣很多次,並每次都建立一個信賴區間,那麼大約有 95% 的區間會包含母體的真實平均數。
該用 z 還是 t?本工具使用 z(常態)分配,適用於樣本數較大、或已知母體標準差的情況。若樣本數非常小且母體標準差未知,理論上採用 t 分配會更精確。