Что делает этот калькулятор доверительного интервала
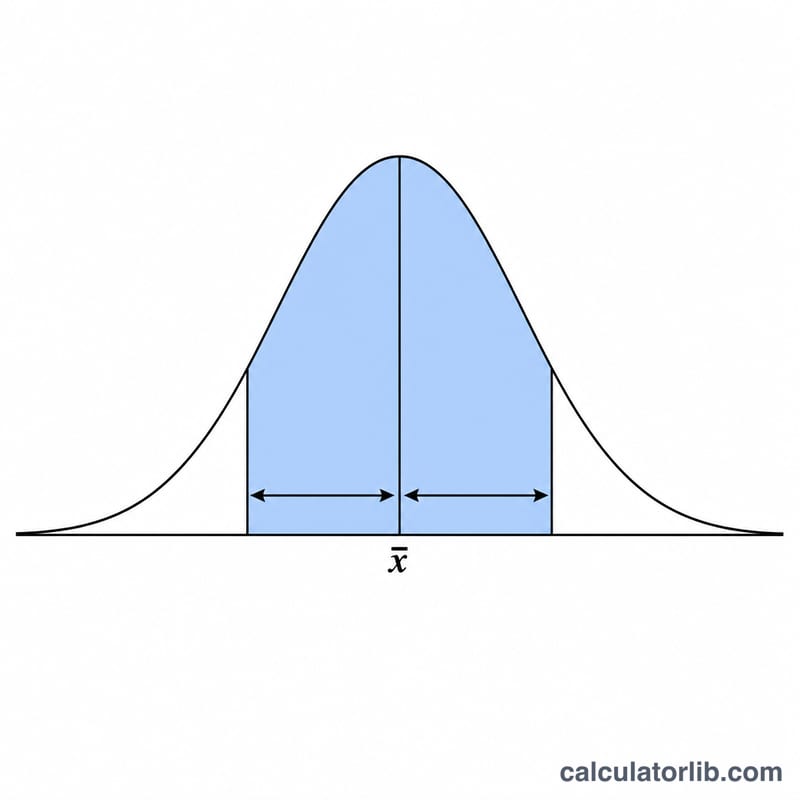
Доверительный интервал — это диапазон значений, который с заданной вероятностью содержит истинное среднее всей генеральной совокупности, оценённое по одной выборке. Калькулятор берёт ваши выборочные показатели и возвращает нижнюю границу, верхнюю границу и предельную ошибку (margin of error). В итоге вы можете сформулировать вывод так: «истинное среднее лежит между X и Y с доверием 95%». В расчётах используется z-распределение (нормальное распределение) — стандартный подход, когда выборка достаточно большая или известно стандартное отклонение генеральной совокупности.
Какие данные нужно ввести
- Выборочное среднее — среднее арифметическое ваших данных (центр интервала).
- Стандартное отклонение — насколько сильно разбросаны значения выборки.
- Объём выборки — количество наблюдений в выборке.
- Уровень доверия — насколько вы хотите быть уверены в результате, обычно 90%, 95% или 99%.
Формула
Калькулятор выполняет расчёт по шагам:
- Стандартная ошибка = стандартное отклонение ÷ √(объём выборки)
- Z-значение = критическое значение нормального распределения для вашего уровня доверия (например, 1,645 для 90%, 1,96 для 95%, 2,576 для 99%)
- Предельная ошибка = Z-значение × стандартная ошибка
- Доверительный интервал = выборочное среднее ± предельная ошибка
Z-значение определяется как обратная функция кумулятивной вероятности в точке alpha/2, где alpha = 1 − уровень доверия. Так неопределённость равномерно распределяется между двумя «хвостами» распределения.
Разбор примера
Допустим, выборочное среднее равно 100, стандартное отклонение — 15, объём выборки — 36, а уровень доверия вы выбрали 95%.
- Стандартная ошибка = 15 ÷ √36 = 15 ÷ 6 = 2,5
- Z-значение для 95% = 1,96
- Предельная ошибка = 1,96 × 2,5 = 4,9
- Нижняя граница = 100 − 4,9 = 95,1
- Верхняя граница = 100 + 4,9 = 104,9
С доверием 95% можно утверждать, что истинное среднее генеральной совокупности находится в диапазоне от 95,1 до 104,9.
Интерпретация вашего доверительного интервала
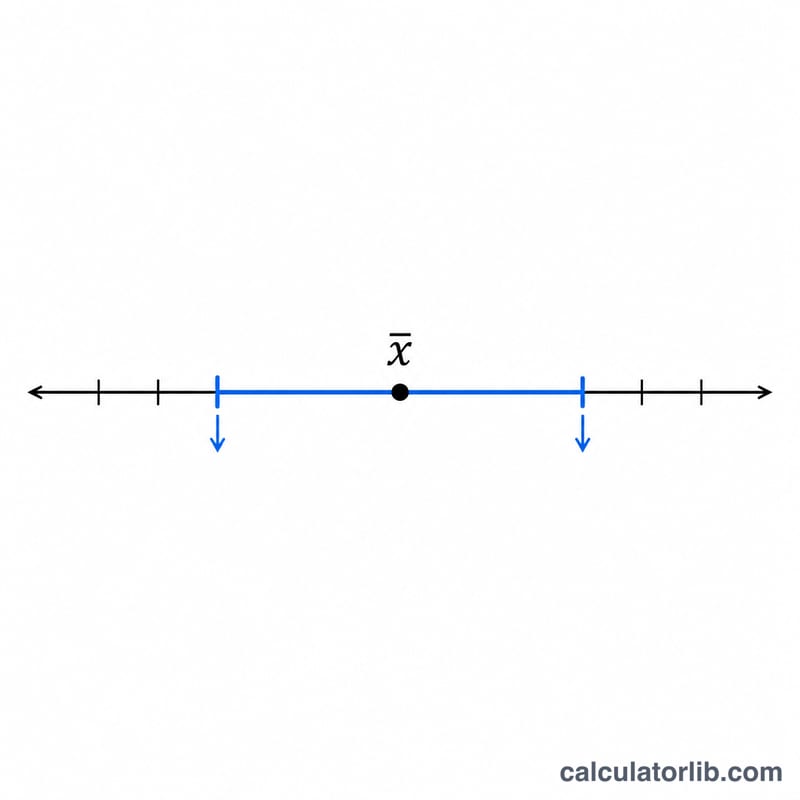
Доверительный интервал сообщает диапазон правдоподобных значений для среднего значения генеральной совокупности \(\mu\), построенный на основе вашей выборки. Утверждение, которое он поддерживает, касается процедуры, а не одного интервала на вашем экране: если бы вы повторили одну и ту же выборку и вычислили бы 95%-й интервал каждый раз, примерно 95% этих интервалов содержали бы истинное среднее. Истинное среднее — это фиксированное (но неизвестное) число — оно не движется. Случайным является интервал, потому что он вычисляется из случайной выборки. Поэтому неправильно говорить «вероятность того, что \(\mu\) лежит между этими двумя числами, составляет 95%»; после того как интервал вычислен, \(\mu\) либо находится внутри него, либо нет. (Байесовы доверительные интервалы действительно поддерживают прямое вероятностное утверждение, но они имеют другую конструкцию и требуют априорного распределения.)
Ширина: что делает оценку точной
Более узкий интервал означает более точную оценку. Полуширина — это предельная ошибка
$$\text{MoE} = z \cdot \frac{s}{\sqrt{n}}$$таким образом, три вещи на него влияют:
- Размер выборки \(n\) — предельная ошибка сокращается с \(\sqrt{n}\), а не с \(n\). Увеличение выборки в четыре раза сокращает предельную ошибку вдвое; сокращение предельной ошибки еще раз требует 16× от исходной выборки. Вот почему точность становится дорогостоящей быстро.
- Уровень доверия — более высокий уровень использует большее критическое значение, поэтому 99%-й интервал всегда шире, чем 95%-й интервал на одних и тех же данных (\(2.576/1.960 \approx 1.31\), примерно на 31% шире). Доверие и точность имеют обратную зависимость друг от друга.
- Разброс \(s\) — более переменные данные дают более широкий интервал при одном и том же \(n\).
Чтение справочного или гипотетического значения
Проверьте, попадает ли значение, которое вас волнует — 0 для оценки разности или изменения, целевое среднее, цифра за прошлый год, значение спецификации — внутрь интервала. Если справочное значение лежит вне двустороннего интервала \(100(1-\alpha)\%\), соответствующий двусторонний критерий \(H_0: \mu = \text{reference}\) отклоняется при уровне значимости \(\alpha = 1 - \text{уровень доверия}\); если оно лежит внутри, критерий не отклоняет. 95%-й интервал и двусторонний критерий при \(\alpha = 0.05\) — это два взгляда на один и тот же расчет. «Не отклонено» означает, что данные совместимы с этим значением — не то что это значение верно, и не то что эффект равен нулю.
Также читайте конечные точки интервала содержательно. Интервал [0.2, 19.8] исключает ноль, но совместим с эффектами, варьирующимися от тривиальных до больших; это отличается от [9.5, 10.5], который исключает ноль и определяет эффект точно.
Средние значения, а не отдельные наблюдения
Этот интервал охватывает среднее значение генеральной совокупности, а не следующее наблюдение. При большом \(n\) интервал для среднего может быть очень узким, в то время как отдельные значения все еще разбросаны широко. Если вам нужен диапазон, который, вероятно, содержит одно единственное будущее наблюдение, это интервал предсказания, который намного шире, потому что он должен поглощать индивидуальную вариацию в дополнение к неопределенности в среднем.
Предположения, на которые вы опираетесь
- Случайные, независимые наблюдения из интересующей вас генеральной совокупности. Удобные выборки, кластеризованные данные, повторные измерения на одних и тех же субъектах и данные временных рядов нарушают это, и интервал будет обычно слишком узким.
- Приблизительная нормальность распределения выборки среднего. По центральной предельной теореме это обычно разумно, как только \(n \ge 30\) для умеренно асимметричных данных; для малых выборок сама генеральная совокупность должна быть приблизительно нормальной, и для сильно асимметричных данных или тяжелых выбросов даже \(n = 30\) может быть недостаточно.
- Известное-\(\sigma\) или приближение для большого-\(n\). Этот калькулятор использует нормальное критическое значение \(z\). Когда \(\sigma\) оценивается по \(s\) из малой выборки, распределение \(t\) с \(n-1\) степенями свободы является строго правильным выбором и дает немного более широкий интервал; разница невелика, как только \(n\) выше примерно 30.
- Отсутствие систематической ошибки. Интервал количественно определяет только вариабельность выборки. Он не исправляет смещение выбора, отсутствие ответов, неправильно сформулированный вопрос, неправильно откалиброванный прибор или ошибку измерения. Смещенная выборка дает узкий интервал вокруг неправильного значения — и большое \(n\) делает этот неправильный интервал еще более узким, а не лучшим.
Наконец, если вы вычисляете много интервалов из одних и тех же данных, вероятность того, что по крайней мере один не попадет в цель, значительно превышает \(\alpha\); это требует поправки на множественность. Этот раздел содержит общую статистическую информацию, а не рекомендации, адаптированные для конкретного дизайна исследования.
Ключевые термины и переменные
| Термин | Символ | Значение |
|---|---|---|
| Выборочное среднее | \(\bar{x}\) | Среднее арифметическое ваших наблюдаемых данных, \(\bar{x} = \frac{1}{n}\sum x_i\). Это то, что вы измеряете, и центр интервала. |
| Среднее значение генеральной совокупности | \(\mu\) | Истинное среднее значение по всей генеральной совокупности. Неизвестно, зафиксировано, и это величина, которую интервал пытается заключить в скобки. |
| Стандартное отклонение выборки | \(s\) | Разброс отдельных наблюдений, вычисленный с \(n-1\) в знаменателе: \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\). |
| Стандартное отклонение генеральной совокупности | \(\sigma\) | Истинный разброс в генеральной совокупности. Редко известно; \(s\) используется как его оценка, вот почему существует распределение \(t\). |
| Размер выборки | \(n\) | Количество независимых наблюдений. Управляет точностью через \(\sqrt{n}\). |
| Стандартная ошибка среднего | SE | \(\text{SE} = s/\sqrt{n}\). Типичное расстояние между выборочным средним и средним значением генеральной совокупности. Отличается от \(s\): \(s\) описывает, насколько разбросаны отдельные наблюдения, и не сокращается по мере сбора данных; SE описывает, насколько неопределенно среднее значение, и сокращается по мере роста \(n\). |
| Предельная ошибка | MoE | \(\text{MoE} = z \times \text{SE}\). Полуширина интервала — число «±» сообщаемое вместе с оценкой. |
| Уровень доверия | \(1-\alpha\) | Доля интервалов, построенных таким образом, которые перехватывали бы \(\mu\) в долгосрочной перспективе (например, 95%). То же значение, написанное как десятичная дробь (0.95), — это коэффициент доверия. |
| Альфа | \(\alpha\) | \(\alpha = 1 - \text{уровень доверия}\); долгосрочная частота пропусков и уровень значимости эквивалентного двустороннего критерия. |
| Альфа, деленная на два | \(\alpha/2\) | Площадь хвоста на каждом конце двустороннего интервала — 0.025 на каждый хвост для 95%-го интервала. |
| Критическое значение / z-оценка | \(z\) | Множитель \(\Phi^{-1}(1-\alpha/2)\) из стандартного нормального распределения. z-оценка в более общем смысле указывает, на сколько стандартных отклонений значение отстоит от среднего. |
| Нижняя граница | LB | \(\bar{x} - \text{MoE}\), меньшая конечная точка интервала. |
| Верхняя граница | UB | \(\bar{x} + \text{MoE}\), большая конечная точка. Интервал записывается как \([\text{LB},\ \text{UB}]\). |
| Степени свободы | \(df = n-1\) | Количество независимых частей информации, оставшихся после оценки \(\bar{x}\). Выбирает строку таблицы \(t\) при использовании альтернативы \(t\) вместо \(z\). |
| Точечная оценка | \(\bar{x}\) | Единственное наилучшее предположение для \(\mu\). Это не указывает на его собственную неопределенность. |
| Интервальная оценка | \([\text{LB}, \text{UB}]\) | Диапазон с указанным уровнем доверия. Сообщает точечную оценку и ее точность, поэтому журналы и органы по стандартизации обычно предпочитают это. |
| Доверительный интервал | CI | Диапазон для параметра — здесь среднее значение генеральной совокупности. Сужается к одной точке при \(n \to \infty\). |
| Интервал предсказания | PI | Диапазон для одного единственного будущего наблюдения. Всегда шире, чем CI на одних и тех же данных, потому что он включает индивидуальную вариацию; он не сокращается к точке при росте \(n\), вместо этого сходясь примерно к \(\mu \pm z\sigma\). |
Часто задаваемые вопросы
Широкий интервал — это плохой результат? Чем шире интервал, тем выше неопределённость. Интервал расширяется при повышении уровня доверия (например, с 95% до 99%) или при малой выборке, а при увеличении выборки — сужается.
Что на самом деле означает «доверие 95%»? Если многократно повторять отбор выборок и каждый раз строить интервал, то примерно 95% таких интервалов будут содержать истинное среднее генеральной совокупности.
Что использовать — z или t? Этот калькулятор работает с z-распределением (нормальным), которое подходит для больших выборок или когда известно стандартное отклонение генеральной совокупности. Для очень малых выборок с неизвестным стандартным отклонением точнее использовать t-распределение Стьюдента.