Máy tính khoảng tin cậy này giúp gì cho bạn
Khoảng tin cậy (confidence interval) cho bạn một khoảng giá trị có khả năng chứa giá trị trung bình thực của tổng thể, dựa trên một mẫu duy nhất. Công cụ này nhận các thống kê của mẫu rồi trả về cận dưới, cận trên và sai số biên (margin of error) — nhờ đó bạn có thể trình bày kết quả kiểu "giá trị trung bình thực nằm trong khoảng từ X đến Y với độ tin cậy 95%". Công cụ sử dụng phân phối z (phân phối chuẩn), vốn là cách tiếp cận tiêu chuẩn khi mẫu đủ lớn hoặc khi đã biết độ lệch chuẩn của tổng thể.
Những thông tin bạn cần nhập
- Trung bình mẫu — giá trị trung bình của dữ liệu mẫu (tâm của khoảng tin cậy).
- Độ lệch chuẩn — mức độ phân tán của các giá trị trong mẫu.
- Cỡ mẫu — số quan sát có trong mẫu của bạn.
- Mức tin cậy — mức độ chắc chắn bạn mong muốn, thường là 90%, 95% hoặc 99%.
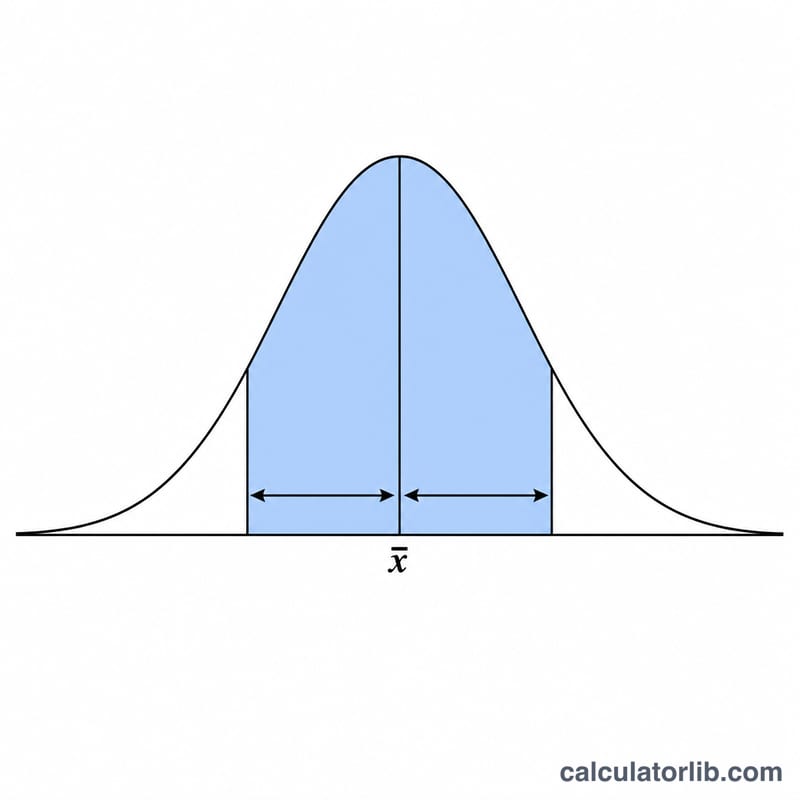
Công thức tính
Công cụ thực hiện theo các bước sau:
- Sai số chuẩn (Standard Error) = Độ lệch chuẩn ÷ √(Cỡ mẫu)
- Điểm Z (Z-score) = giá trị tới hạn từ phân phối chuẩn ứng với mức tin cậy của bạn (ví dụ 1.645 cho 90%, 1.96 cho 95%, 2.576 cho 99%)
- Sai số biên (Margin of Error) = Điểm Z × Sai số chuẩn
- Khoảng tin cậy = Trung bình mẫu ± Sai số biên
Điểm Z được xác định bằng cách lấy nghịch đảo của xác suất tích lũy tại alpha/2, với alpha = 1 − mức tin cậy. Cách này chia đều phần bất định ra hai đuôi của phân phối.
Ví dụ minh họa
Giả sử trung bình mẫu là 100, độ lệch chuẩn là 15, cỡ mẫu là 36 và bạn chọn mức tin cậy 95%.
- Sai số chuẩn = 15 ÷ √36 = 15 ÷ 6 = 2.5
- Điểm Z cho 95% = 1.96
- Sai số biên = 1.96 × 2.5 = 4.9
- Cận dưới = 100 − 4.9 = 95.1
- Cận trên = 100 + 4.9 = 104.9
Bạn có thể tin cậy ở mức 95% rằng giá trị trung bình thực của tổng thể nằm trong khoảng từ 95.1 đến 104.9.
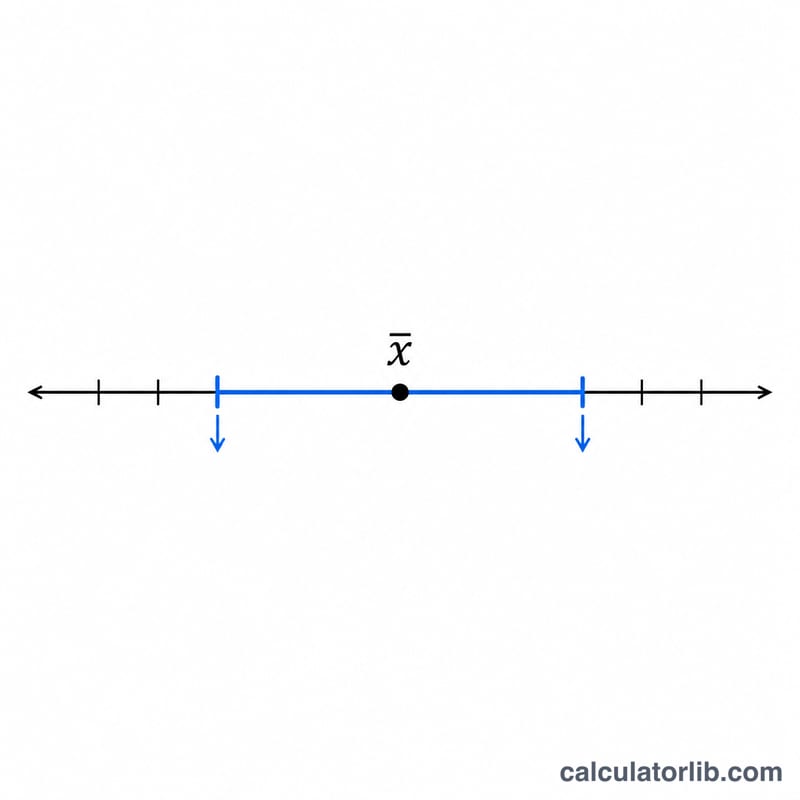
Diễn giải Khoảng tin cậy của bạn
Khoảng tin cậy báo cáo một loạt các giá trị có thể có cho trung bình tổng thể \(\mu\), được xây dựng từ mẫu của bạn. Phát biểu nó hỗ trợ là về thủ tục, không phải về khoảng duy nhất trên màn hình của bạn: nếu bạn lặp lại cùng một lấy mẫu và tính một khoảng 95% mỗi lần, khoảng 95% những khoảng đó sẽ chứa trung bình thực. Trung bình thực là một số cố định (nhưng không biết) — nó không di chuyển. Điều gì là ngẫu nhiên là khoảng, vì nó được tính từ một mẫu ngẫu nhiên. Vì vậy, không chính xác khi nói "có xác suất 95% rằng \(\mu\) nằm giữa hai số này"; khi khoảng được tính, \(\mu\) hoặc nằm bên trong nó hoặc không. (Các khoảng tin cậy Bayes hỗ trợ một phát biểu xác suất trực tiếp, nhưng chúng là một cấu trúc khác và yêu cầu một phân phối tiên nghiệm.)
Chiều rộng: điều gì làm cho ước tính chính xác
Khoảng hẹp hơn có nghĩa là ước tính chính xác hơn. Nửa chiều rộng là sai số biên
$$\text{MoE} = z \cdot \frac{s}{\sqrt{n}}$$vì vậy ba điều làm thay đổi nó:
- Cỡ mẫu \(n\) — sai số biên co lại theo \(\sqrt{n}\), không phải theo \(n\). Tăng cỡ mẫu gấp bốn lần sẽ giảm sai số biên một nửa; để giảm sai số biên một nửa lần nữa cần gấp 16 lần cỡ mẫu ban đầu. Đây là lý do tại sao độ chính xác trở nên tốn kém nhanh chóng.
- Mức độ tin cậy — một mức độ cao hơn sử dụng giá trị tới hạn lớn hơn, vì vậy khoảng 99% luôn rộng hơn khoảng 95% trên cùng dữ liệu (\(2.576/1.960 \approx 1.31\), rộng hơn khoảng 31%). Độ tin cậy và độ chính xác có mối quan hệ đánh đổi lẫn nhau.
- Sự phân tán \(s\) — dữ liệu có biến thiên cao hơn cho khoảng rộng hơn cho cùng một \(n\).
Đọc một giá trị tham chiếu hoặc giá trị giả thuyết
Kiểm tra xem một giá trị bạn quan tâm — 0 cho một chênh lệch hoặc điểm số thay đổi, một trung bình mục tiêu, con số năm ngoái, một giá trị đặc tả — có nằm bên trong khoảng không. Nếu giá trị tham chiếu nằm ngoài một khoảng \(100(1-\alpha)\%\) hai phía, phép kiểm tra hai phía tương ứng của \(H_0: \mu = \text{tham chiếu}\) bác bỏ ở mức ý nghĩa \(\alpha = 1 - \text{mức độ tin cậy}\); nếu nó nằm bên trong, phép kiểm tra không bác bỏ. Khoảng 95% và phép kiểm tra hai phía tại \(\alpha = 0.05\) là hai cách nhìn của cùng một phép tính. "Không bác bỏ" có nghĩa là dữ liệu tương thích với giá trị đó — không phải giá trị đó là đúng, và không phải hiệu ứng bằng không.
Cũng hãy đọc các điểm cuối của khoảng một cách thực chất. Khoảng [0.2, 19.8] loại trừ không nhưng tương thích với các hiệu ứng từ tầm thường đến lớn; đó là một tình huống khác với [9.5, 10.5], loại trừ không và xác định rõ hiệu ứng.
Trung bình, không phải từng cá nhân
Khoảng này bao gồm trung bình của tổng thể, không phải quan sát tiếp theo. Với \(n\) lớn, khoảng cho trung bình có thể rất hẹp trong khi các giá trị từng cá nhân vẫn phân tán rộng. Nếu bạn cần một khoảng có khả năng chứa một quan sát trong tương lai duy nhất, đó là một khoảng dự báo, rộng hơn nhiều vì nó phải hấp thụ biến thiên cá nhân cộng với sự không chắc chắn về trung bình.
Các giả định bạn đang dựa vào
- Quan sát ngẫu nhiên, độc lập từ tổng thể quan tâm. Các mẫu tiện lợi, dữ liệu được nhóm, phép đo lặp lại trên cùng các đối tượng và dữ liệu chuỗi thời gian vi phạm điều này, và khoảng sẽ thường quá hẹp.
- Tính chuẩn hóa gần đúng của phân phối lấy mẫu của trung bình. Theo Định lý Giới hạn Trung tâm, điều này thường hợp lý khi \(n \ge 30\) đối với dữ liệu nghiêng vừa phải; đối với các mẫu nhỏ, tổng thể tự nó phải gần như chuẩn, và đối với dữ liệu nghiêng mạnh hoặc các giá trị ngoại lệ nặng nề, thậm chí \(n = 30\) cũng có thể không đủ.
- Giá trị \(\sigma\) đã biết hoặc xấp xỉ \(n\) lớn. Máy tính này sử dụng giá trị tới hạn chuẩn \(z\). Khi \(\sigma\) được ước tính bởi \(s\) từ một mẫu nhỏ, phân phối \(t\) với \(n-1\) bậc tự do là lựa chọn hoàn toàn chính xác và cho khoảng rộng hơn một chút; sự khác biệt là nhỏ khi \(n\) trên khoảng 30.
- Không có sai số hệ thống. Khoảng định lượng chỉ biến thiên lấy mẫu. Nó không điều chỉnh độ lệch lựa chọn, không phản hồi, một câu hỏi được phát biểu kém, một công cụ được hiệu chuẩn sai hoặc sai số đo lường. Một mẫu có độ lệch tạo ra khoảng chặt chẽ xung quanh giá trị sai — và \(n\) lớn làm cho khoảng sai đó chặt chẽ hơn, không tốt hơn.
Cuối cùng, nếu bạn tính toán nhiều khoảng từ cùng một bộ dữ liệu, khả năng ít nhất một khoảng bỏ lỡ mục tiêu của nó tăng cao trên \(\alpha\); điều đó yêu cầu điều chỉnh độ phức tạp. Phần này là thông tin thống kê chung, không phải lời khuyên được điều chỉnh cho một thiết kế nghiên cứu cụ thể.
Các Thuật ngữ và Biến Quan trọng
| Thuật ngữ | Ký hiệu | Ý nghĩa |
|---|---|---|
| Trung bình mẫu | \(\bar{x}\) | Trung bình số học của dữ liệu quan sát của bạn, \(\bar{x} = \frac{1}{n}\sum x_i\). Đây là những gì bạn đo lường và tâm của khoảng. |
| Trung bình tổng thể | \(\mu\) | Trung bình thực trên toàn bộ tổng thể. Không xác định, cố định, và số lượng mà khoảng đang cố gắng xác định. |
| Độ lệch chuẩn mẫu | \(s\) | Sự phân tán của các quan sát riêng lẻ, được tính toán với \(n-1\) ở mẫu số: \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\). |
| Độ lệch chuẩn tổng thể | \(\sigma\) | Sự phân tán thực trong tổng thể. Hiếm khi biết; \(s\) được sử dụng làm ước tính của nó, đó là lý do tại sao phân phối \(t\) tồn tại. |
| Cỡ mẫu | \(n\) | Số quan sát độc lập. Thúc đẩy độ chính xác qua \(\sqrt{n}\). |
| Sai số chuẩn của trung bình | SE | \(\text{SE} = s/\sqrt{n}\). Khoảng cách điển hình giữa trung bình mẫu và trung bình tổng thể. Khác biệt với \(s\): \(s\) mô tả cách các cá nhân được phân tán và không co lại khi bạn thu thập thêm dữ liệu; SE mô tả mức độ không chắc chắn của trung bình và co lại khi \(n\) tăng. |
| Sai số biên | MoE | \(\text{MoE} = z \times \text{SE}\). Nửa chiều rộng của khoảng — số "±" được báo cáo cùng với ước tính. |
| Mức độ tin cậy | \(1-\alpha\) | Tỷ lệ dài hạn của các khoảng được xây dựng theo cách này sẽ nắm bắt \(\mu\) (ví dụ 95%). Giá trị tương tự được viết dưới dạng thập phân (0.95) là hệ số tin cậy. |
| Alpha | \(\alpha\) | \(\alpha = 1 - \text{mức độ tin cậy}\); tỷ lệ bỏ lỡ dài hạn, và mức ý nghĩa của phép kiểm tra hai phía tương đương. |
| Alpha chia hai | \(\alpha/2\) | Diện tích đuôi ở mỗi đầu của khoảng hai phía — 0.025 cho mỗi đuôi đối với khoảng 95%. |
| Giá trị tới hạn / điểm z | \(z\) | Hệ số nhân \(\Phi^{-1}(1-\alpha/2)\) từ phân phối chuẩn. Điểm z nói chung nêu rõ giá trị nằm cách trung bình bao nhiêu độ lệch chuẩn. |
| Cận dưới | LB | \(\bar{x} - \text{MoE}\), điểm cuối nhỏ hơn của khoảng. |
| Cận trên | UB | \(\bar{x} + \text{MoE}\), điểm cuối lớn hơn. Khoảng được viết \([\text{LB},\ \text{UB}]\). |
| Bậc tự do | \(df = n-1\) | Số phần thông tin độc lập còn lại sau khi ước tính \(\bar{x}\). Chọn hàng của bảng \(t\) khi sử dụng giải pháp thay thế \(t\) cho \(z\). |
| Ước tính điểm | \(\bar{x}\) | Một con số dự đoán tốt nhất duy nhất cho \(\mu\). Nó không có bất kỳ dấu hiệu nào về sự không chắc chắn của riêng nó. |
| Ước tính khoảng | \([\text{LB}, \text{UB}]\) | Một khoảng với mức độ tin cậy được nêu rõ. Báo cáo ước tính điểm và độ chính xác của nó, đó là lý do tại sao các tạp chí và các cơ quan tiêu chuẩn thường ưa thích nó. |
| Khoảng tin cậy | CI | Một khoảng cho một tham số — ở đây là trung bình tổng thể. Thu hẹp đến một điểm duy nhất khi \(n \to \infty\). |
| Khoảng dự báo | PI | Một khoảng cho một quan sát trong tương lai duy nhất. Luôn rộng hơn CI trên cùng dữ liệu, vì nó bao gồm biến thiên cấp độ cá nhân; nó không co lại thành một điểm khi \(n\) tăng, thay vào đó hội tụ đến khoảng \(\mu \pm z\sigma\). |
Câu hỏi thường gặp
Khoảng rộng hơn có phải là kết quả tệ hơn không? Khoảng rộng hơn phản ánh mức độ bất định cao hơn. Tăng mức tin cậy (ví dụ từ 95% lên 99%) hoặc dùng mẫu nhỏ sẽ làm khoảng rộng ra; mẫu lớn hơn sẽ làm khoảng hẹp lại.
"Độ tin cậy 95%" thực sự nghĩa là gì? Nếu bạn lặp lại việc lấy mẫu nhiều lần và mỗi lần đều xây dựng một khoảng tin cậy, thì khoảng 95% trong số các khoảng đó sẽ chứa giá trị trung bình thực của tổng thể.
Nên dùng z hay t? Công cụ này dùng phân phối z (phân phối chuẩn), phù hợp với mẫu lớn hoặc khi đã biết độ lệch chuẩn của tổng thể. Với mẫu rất nhỏ và chưa biết độ lệch chuẩn của tổng thể, về mặt kỹ thuật phân phối t sẽ cho kết quả chính xác hơn.