Qué hace esta calculadora de intervalo de confianza
Un intervalo de confianza te ofrece un rango de valores que, con alta probabilidad, contiene la verdadera media de la población a partir de una sola muestra. Esta calculadora toma tus estadísticos muestrales y devuelve un límite inferior, un límite superior y el margen de error, de modo que puedas expresar resultados como «la media real está entre X e Y, con un 95% de confianza». Utiliza la distribución z (distribución normal), el enfoque estándar cuando la muestra es razonablemente grande o cuando se conoce la desviación estándar poblacional.
Los datos que debes introducir
- Media muestral: el promedio de los datos de tu muestra (el centro del intervalo).
- Desviación estándar: el grado de dispersión de los valores de tu muestra.
- Tamaño de la muestra: el número de observaciones que contiene tu muestra.
- Nivel de confianza: el grado de seguridad que deseas, normalmente del 90%, 95% o 99%.
La fórmula
La calculadora sigue estos pasos:
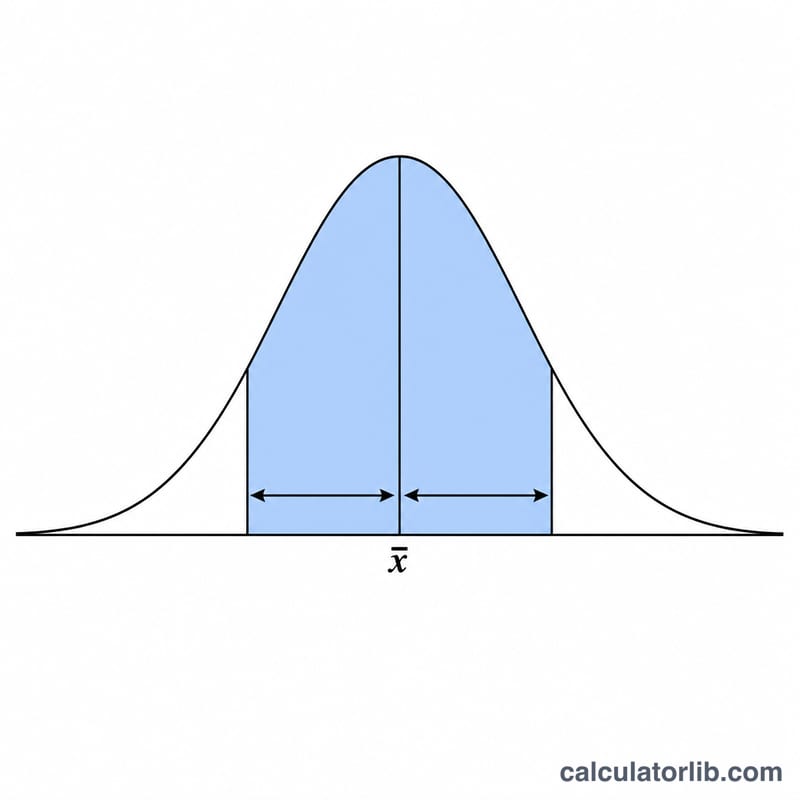
- Error estándar = Desviación estándar ÷ √(Tamaño de la muestra)
- Puntuación Z = el valor crítico de la distribución normal para tu nivel de confianza (por ejemplo, 1,645 para el 90%, 1,96 para el 95% y 2,576 para el 99%)
- Margen de error = Puntuación Z × Error estándar
- Intervalo de confianza = Media muestral ± Margen de error
La puntuación Z se obtiene calculando la probabilidad acumulada inversa en alfa/2, donde alfa = 1 − nivel de confianza. Así, la incertidumbre se reparte de forma equilibrada entre las dos colas de la distribución.
Ejemplo resuelto
Supongamos que tu media muestral es 100, la desviación estándar es 15, el tamaño de la muestra es 36 y eliges un nivel de confianza del 95%.
- Error estándar = 15 ÷ √36 = 15 ÷ 6 = 2,5
- Puntuación Z para el 95% = 1,96
- Margen de error = 1,96 × 2,5 = 4,9
- Límite inferior = 100 − 4,9 = 95,1
- Límite superior = 100 + 4,9 = 104,9
Puedes afirmar con un 95% de confianza que la verdadera media de la población se encuentra entre 95,1 y 104,9.
Interpretación de su Intervalo de Confianza
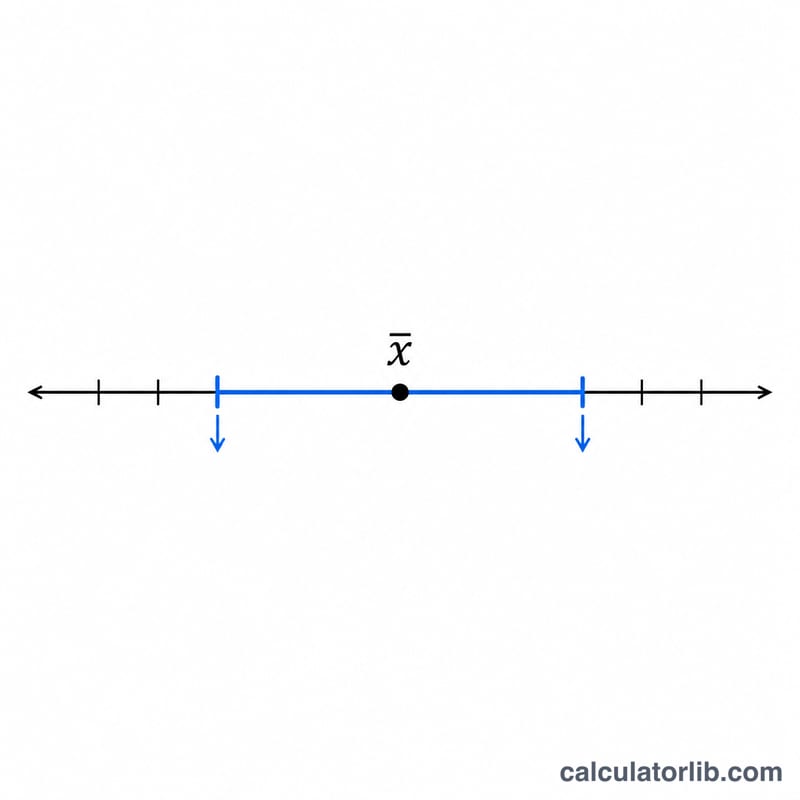
Un intervalo de confianza reporta un rango de valores plausibles para la media poblacional \(\mu\), construido a partir de su muestra. La declaración que apoya es acerca del procedimiento, no acerca del intervalo único que ve en su pantalla: si repitiera el mismo muestreo y calculara un intervalo del 95% cada vez, aproximadamente el 95% de esos intervalos contendrían la media verdadera. La media verdadera es un número fijo (pero desconocido) — no se mueve. Lo que es aleatorio es el intervalo, porque se calcula a partir de una muestra aleatoria. Por lo tanto, no es correcto decir "hay una probabilidad del 95% de que \(\mu\) esté entre estos dos números"; una vez que se calcula el intervalo, \(\mu\) o está dentro de él o no. (Los intervalos creíbles bayesianos sí apoyan una declaración de probabilidad directa, pero son una construcción diferente y requieren una distribución previa.)
Amplitud: qué hace que una estimación sea precisa
Un intervalo más estrecho significa una estimación más precisa. La media amplitud es el margen de error
$$\text{Margen de error} = z \cdot \frac{s}{\sqrt{n}}$$así que tres cosas lo mueven:
- Tamaño de muestra \(n\) — el margen se reduce con \(\sqrt{n}\), no con \(n\). Cuadriplicar la muestra reduce a la mitad el margen de error; reducir el margen nuevamente requiere 16× la muestra original. Por eso la precisión se vuelve cara rápidamente.
- Nivel de confianza — un nivel más alto utiliza un valor crítico más grande, por lo que un intervalo del 99% siempre es más ancho que un intervalo del 95% en los mismos datos (\(2.576/1.960 \approx 1.31\), aproximadamente 31% más ancho). Confianza y precisión se intercambian entre sí.
- Dispersión \(s\) — los datos más variables dan un intervalo más ancho para el mismo \(n\).
Lectura de un valor de referencia o supuesto
Compruebe si un valor que le importa — 0 para una diferencia o puntuación de cambio, una media objetivo, la cifra del año pasado, un valor de especificación — cae dentro del intervalo. Si el valor de referencia se encuentra fuera de un intervalo \(100(1-\alpha)\%\) de dos colas, la prueba correspondiente de dos colas de \(H_0: \mu = \text{referencia}\) rechaza al nivel de significancia \(\alpha = 1 - \text{nivel de confianza}\); si se encuentra dentro, la prueba no rechaza. Un intervalo del 95% y una prueba de dos colas en \(\alpha = 0.05\) son dos vistas del mismo cálculo. "No rechazado" significa que los datos son compatibles con ese valor — no que el valor sea verdadero, y no que el efecto sea cero.
También lea los puntos finales del intervalo de manera sustancial. Un intervalo de [0.2, 19.8] excluye cero pero es compatible con efectos que van desde triviales a grandes; esa es una situación diferente de [9.5, 10.5], que excluye cero y fija el efecto.
Medias, no individuos
Este intervalo cubre el promedio de la población, no la siguiente observación. Con un \(n\) grande, el intervalo para la media puede ser muy estrecho mientras que los valores individuales aún se dispersan ampliamente. Si necesita un rango que sea probable que contenga una sola observación futura, ese es un intervalo de predicción, que es mucho más ancho porque debe absorber la variación individual además de la incertidumbre acerca de la media.
Supuestos en los que está confiando
- Observaciones aleatorias e independientes de la población de interés. Las muestras de conveniencia, los datos agrupados, las medidas repetidas en los mismos sujetos y los datos de series de tiempo violan esto, y el intervalo típicamente será demasiado estrecho.
- Normalidad aproximada de la distribución muestral de la media. Por el Teorema del Límite Central esto es generalmente razonable una vez que \(n \ge 30\) para datos moderadamente sesgados; para muestras pequeñas, la población misma debe ser aproximadamente normal, y para datos fuertemente sesgados u valores atípicos extremos incluso \(n = 30\) puede no ser suficiente.
- Aproximación conocida-\(\sigma\) o grande-\(n\). Esta calculadora utiliza el valor crítico normal \(z\). Cuando \(\sigma\) se estima por \(s\) de una muestra pequeña, la distribución \(t\) con \(n-1\) grados de libertad es la opción estrictamente correcta y da un intervalo ligeramente más ancho; la diferencia es pequeña una vez que \(n\) está por encima de aproximadamente 30.
- Sin error sistemático. El intervalo cuantifica solo la variabilidad muestral. No corrige el sesgo de selección, no respuesta, una pregunta mal redactada, un instrumento mal calibrado o error de medición. Una muestra sesgada produce un intervalo apretado alrededor del valor incorrecto — y un \(n\) grande hace que ese intervalo incorrecto sea más apretado, no mejor.
Finalmente, si calcula muchos intervalos a partir de los mismos datos, la posibilidad de que al menos uno pierda su objetivo se eleva bien por encima de \(\alpha\); eso requiere un ajuste de multiplicidad. Esta sección es información estadística general, no asesoramiento personalizado para un diseño de estudio específico.
Términos y Variables Clave
| Término | Símbolo | Significado |
|---|---|---|
| Media muestral | \(\bar{x}\) | El promedio aritmético de sus datos observados, \(\bar{x} = \frac{1}{n}\sum x_i\). Es lo que mide y el centro del intervalo. |
| Media poblacional | \(\mu\) | El promedio verdadero en toda la población. Desconocido, fijo, y la cantidad que el intervalo está tratando de encerrar. |
| Desviación estándar muestral | \(s\) | Dispersión de las observaciones individuales, calculada con \(n-1\) en el denominador: \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\). |
| Desviación estándar poblacional | \(\sigma\) | Dispersión verdadera en la población. Raramente se conoce; \(s\) se usa como su estimación, por lo cual la distribución \(t\) existe. |
| Tamaño de muestra | \(n\) | Número de observaciones independientes. Impulsa la precisión a través de \(\sqrt{n}\). |
| Error estándar de la media | SE | \(\text{SE} = s/\sqrt{n}\). La distancia típica entre una media muestral y la media poblacional. Distinto de \(s\): \(s\) describe cuán dispersos están los individuos y no se reduce al recopilar más datos; SE describe cuán incierta es la media y se reduce cuando \(n\) crece. |
| Margen de error | MoE | \(\text{MoE} = z \times \text{SE}\). La media amplitud del intervalo — el número "± " reportado junto con la estimación. |
| Nivel de confianza | \(1-\alpha\) | La proporción a largo plazo de intervalos construidos de esta manera que capturarían \(\mu\) (por ejemplo, 95%). El mismo valor escrito como decimal (0.95) es el coeficiente de confianza. |
| Alfa | \(\alpha\) | \(\alpha = 1 - \text{nivel de confianza}\); la tasa de pérdida a largo plazo, y el nivel de significancia de la prueba equivalente de dos colas. |
| Alfa sobre dos | \(\alpha/2\) | El área de cola en cada extremo de un intervalo de dos colas — 0.025 por cola para un intervalo del 95%. |
| Valor crítico / puntuación z | \(z\) | El multiplicador \(\Phi^{-1}(1-\alpha/2)\) de la distribución normal estándar. Una puntuación z más en general establece cuántas desviaciones estándar se encuentra un valor de la media. |
| Límite inferior | LB | \(\bar{x} - \text{MoE}\), el punto final más pequeño del intervalo. |
| Límite superior | UB | \(\bar{x} + \text{MoE}\), el punto final más grande. El intervalo se escribe \([\text{LB},\ \text{UB}]\). |
| Grados de libertad | \(df = n-1\) | El número de piezas de información independientes que quedan después de estimar \(\bar{x}\). Selecciona la fila de la tabla \(t\) al usar la alternativa \(t\) a \(z\). |
| Estimación puntual | \(\bar{x}\) | Un único número de mejor estimación para \(\mu\). No lleva indicación de su propia incertidumbre. |
| Estimación por intervalo | \([\text{LB}, \text{UB}]\) | Un rango con un nivel de confianza establecido. Reporta la estimación puntual y su precisión, por lo cual las revistas y los organismos de normalización generalmente lo prefieren. |
| Intervalo de confianza | CI | Un rango para un parámetro — aquí la media poblacional. Se estrecha hacia un punto único cuando \(n \to \infty\). |
| Intervalo de predicción | PI | Un rango para una sola observación futura. Siempre más ancho que el CI en los mismos datos, porque incluye la variación a nivel individual; no se reduce a un punto cuando \(n\) crece, convergiendo en su lugar a aproximadamente \(\mu \pm z\sigma\). |
Preguntas frecuentes
¿Un intervalo más amplio significa un peor resultado? Un intervalo más amplio refleja una mayor incertidumbre. Aumentar el nivel de confianza (por ejemplo, del 95% al 99%) o trabajar con una muestra más pequeña ensancha el intervalo; una muestra más grande lo estrecha.
¿Qué significa realmente «95% de confianza»? Si repitieras el muestreo muchas veces y construyeras un intervalo en cada ocasión, alrededor del 95% de esos intervalos contendría la verdadera media de la población.
¿Debo usar z o t? Esta herramienta utiliza la distribución z (normal), adecuada para muestras grandes o cuando se conoce la desviación estándar poblacional. Para muestras muy pequeñas con una desviación estándar poblacional desconocida, la distribución t es técnicamente más precisa.