この信頼区間計算ツールでできること
信頼区間とは、1つの標本データをもとに、母集団の真の平均値が含まれていると考えられる値の範囲のことです。本ツールに標本の統計値を入力すると、区間の下限・上限、そして誤差の範囲(マージン・オブ・エラー)を算出します。これにより「真の平均は95%の信頼度でXからYの間にある」といった形で結果を報告できます。計算にはz分布(正規分布)を用いており、これは標本サイズが十分に大きい場合や、母集団の標準偏差が既知の場合に標準的に使われる手法です。
入力する項目
- 標本平均 — 標本データの平均値(区間の中心になります)。
- 標準偏差 — 標本の値がどれくらいばらついているか。
- 標本サイズ — 標本に含まれる観測値(データ)の数。
- 信頼水準 — どの程度の確からしさを求めるか。一般的には90%、95%、99%が使われます。
計算式
このツールは次のステップで計算を進めます。
- 標準誤差 = 標準偏差 ÷ √(標本サイズ)
- Zスコア = 信頼水準に対応する正規分布の臨界値(例:90%なら1.645、95%なら1.96、99%なら2.576)
- 誤差の範囲 = Zスコア × 標準誤差
- 信頼区間 = 標本平均 ± 誤差の範囲
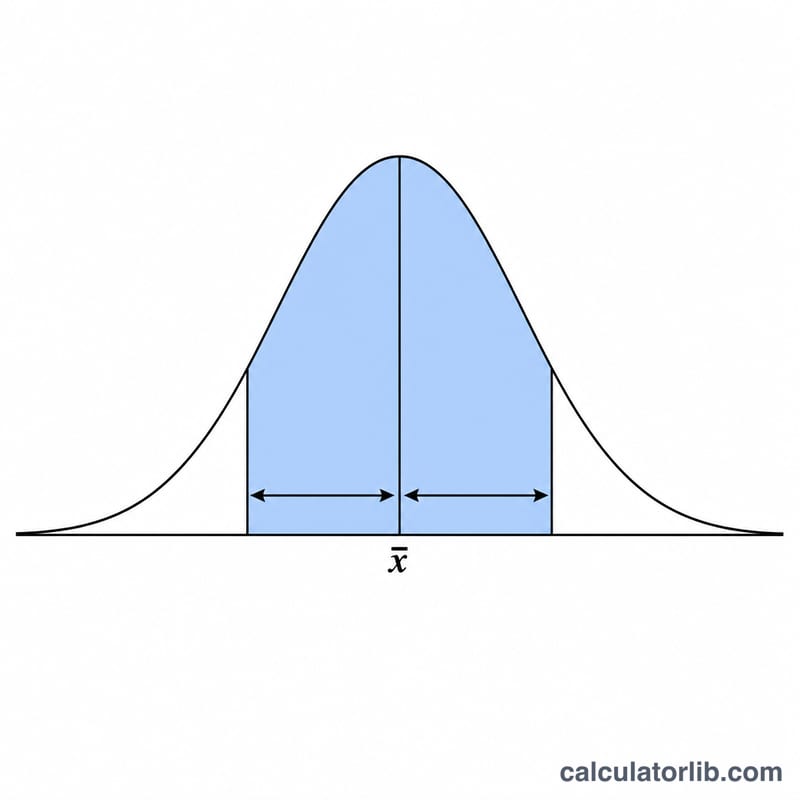
Zスコアは、alpha/2における累積確率の逆関数から求めます(ここで alpha = 1 − 信頼水準)。これにより、不確実性が両側の裾に均等に振り分けられます。
計算例
標本平均が100、標準偏差が15、標本サイズが36で、信頼水準を95%に設定したとします。
- 標準誤差 = 15 ÷ √36 = 15 ÷ 6 = 2.5
- 95%のZスコア = 1.96
- 誤差の範囲 = 1.96 × 2.5 = 4.9
- 下限 = 100 − 4.9 = 95.1
- 上限 = 100 + 4.9 = 104.9
このとき、母集団の真の平均は95.1から104.9の間にあると、95%の信頼度で言えます。
信頼区間の解釈
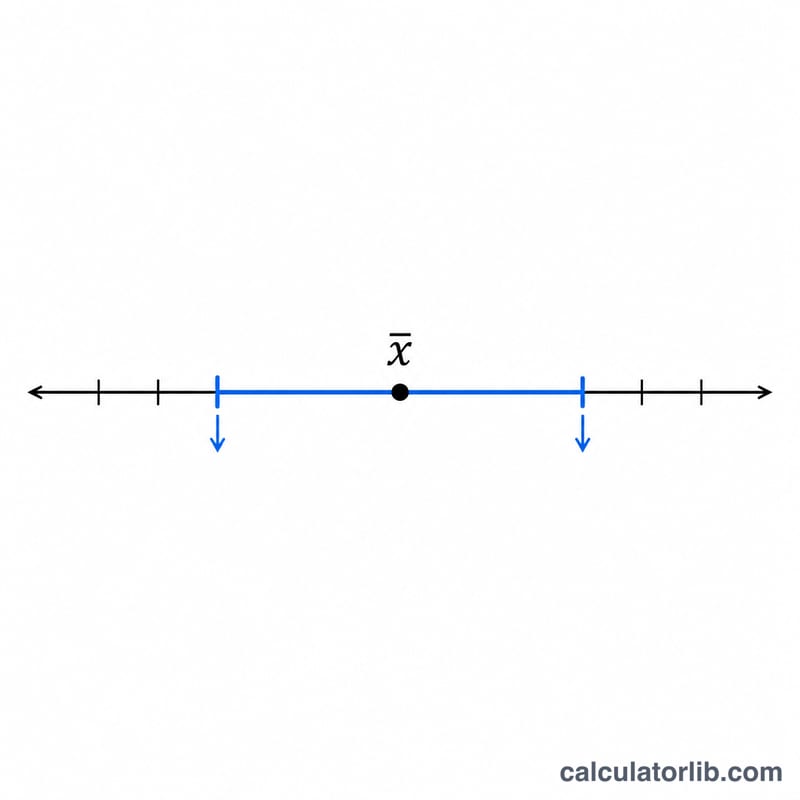
信頼区間は、標本から構築された母平均 \(\mu\) の妥当な値の範囲を報告します。それが支持する陳述は、画面上の1つの区間についてではなく、手順についてです:同じサンプリングを繰り返して毎回95%の区間を計算すれば、それらの区間の約95%が真の平均を含むことになります。真の平均は固定された(しかし未知の)数です — それは動きません。ランダムなのは区間です。なぜなら、ランダムサンプルから計算されるからです。したがって、「\(\mu\) がこの2つの数の間にある確率は95%である」と言うことは正しくありません。区間が計算されたら、\(\mu\) はそれに含まれるか含まれないかのいずれかです。(ベイズ信用区間は直接的な確率陳述をサポートしますが、異なる構築であり、事前分布が必要です。)
幅:推定値をより正確にするもの
より狭い区間は、より正確な推定値を意味します。半幅は誤差の幅です
$$\text{MoE} = z \cdot \frac{s}{\sqrt{n}}$$したがって、3つのものがそれを動かします:
- 標本サイズ \(n\) — 誤差の幅は \(\sqrt{n}\) で縮小しますが、\(n\) では縮小しません。標本を4倍にすると誤差の幅が半分になります。誤差の幅をもう一度半分にするには、元の標本の16倍が必要です。これが精度が急速に高くなる理由です。
- 信頼水準 — より高い水準はより大きい臨界値を使用するため、99%の区間は同じデータの95%の区間よりも常に広いです(2.576/1.960 ≈ 1.31、約31%広い)。信頼と精度はトレードオフです。
- 広がり \(s\) — より可変的なデータは同じ \(n\) に対してより広い区間を与えます。
参照値または仮説値の読み取り
あなたが気にする値—差分または変更スコアの場合は0、ターゲット平均、昨年の数字、仕様値—が区間内に含まれるかどうかを確認してください。参照値が両側 100(1-α)% 区間の外にある場合、\(H_0: \mu = \text{reference}\) の対応する両側検定は有意水準 \(\alpha = 1 - \text{信頼水準}\) で帰無仮説を棄却します。内側にある場合、検定は帰無仮説を棄却しません。95%区間と \(\alpha = 0.05\) での両側検定は、同じ計算の2つの見方です。「帰無仮説が棄却されない」はデータがその値と互換性があることを意味します — その値が真であることではなく、効果がゼロであることでもありません。
また、区間の端点を実質的に読んでください。[0.2, 19.8]の区間はゼロを除外しますが、軽微から大きい効果と互換性があります。[9.5, 10.5](ゼロを除外し、効果を固定する)とは異なる状況です。
個人ではなく、平均
この区間は、次の観測ではなく、母集団の平均をカバーしています。大きな \(n\) では、平均の区間は非常に狭いことがありますが、個々の値は広くばらつきます。単一の将来の観測を含む可能性が高い範囲が必要な場合、それは予測区間であり、平均に関する不確実性に加えて個々の変動を吸収する必要があるため、はるかに広いです。
あなたが依存している仮定
- 対象の母集団からのランダムで独立した観測。便宜的なサンプル、クラスター化されたデータ、同じ被験者の繰り返し測定、および時系列データはこれに違反し、区間は通常は狭すぎます。
- 標本平均の標本分布の近似正規性。中心極限定理により、適度に歪んだデータでは n ≥ 30になると通常合理的です。小さなサンプルの場合、母集団自体がほぼ正常であるべきです。強く歪んだデータまたは外れ値の場合、n = 30でも十分ではない可能性があります。
- 既知-\(\sigma\) または大-n 近似。このカリキュレーターは正規臨界値 \(z\) を使用します。\(\sigma\) が小さなサンプルから \(s\) で推定される場合、\(n-1\) 自由度の \(t\) 分布は厳密に正しい選択であり、わずかに広い区間を与えます。差は \(n\) が約30以上になると小さくなります。
- 体系的エラーなし。区間は標本変動のみを定量化します。選択バイアス、無回答、不適切に文言された質問、キャリブレーションが不正確な機器または測定誤差を補正しません。バイアスされたサンプルは間違った値の周りに厳しい区間を生成します — 大きな \(n\) はその間違った区間をより厳しくしますが、より良くはしません。
最後に、同じデータから多くの区間を計算する場合、少なくとも1つがそのターゲットを逃す確率は \(\alpha\) をはるかに上回ります。これには多重性の調整が必要です。このセクションは一般的な統計情報であり、特定の研究デザインのためのカスタマイズされたアドバイスではありません。
主要な用語と変数
| 用語 | 記号 | 意味 |
|---|---|---|
| 標本平均 | \(\bar{x}\) | 観測データの算術平均、\(\bar{x} = \frac{1}{n}\sum x_i\)。これはあなたが測定するものであり、区間の中心です。 |
| 母平均 | \(\mu\) | 母集団全体の真の平均。未知の、固定された、そして区間が括弧で囲もうとしている量です。 |
| 標本標準偏差 | \(s\) | 個々の観測の広がり。分母に \(n-1\) を使用して計算:\(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\)。 |
| 母標準偏差 | \(\sigma\) | 母集団の真の広がり。滅多に知られていません。\(s\) はその推定値として使用されます。これが \(t\) 分布が存在する理由です。 |
| 標本サイズ | \(n\) | 独立した観測の数。\(\sqrt{n}\) を通じて精度を駆動します。 |
| 平均の標準誤差 | SE | \(\text{SE} = s/\sqrt{n}\)。標本平均と母平均の間の典型的な距離。\(s\) とは異なります:\(s\) は個人がどのように広がっているかを説明し、より多くのデータを収集してもシュリンクしません。SE は平均がどのくらい不確実かを説明し、\(n\) が成長するとシュリンクします。 |
| 誤差の幅 | MoE | \(\text{MoE} = z \times \text{SE}\)。区間の半幅 — 推定値と共に報告される「±数」。 |
| 信頼水準 | \(1-\alpha\) | このように構築された区間のうち、長期的に \(\mu\) をキャプチャする割合(例えば95%)。同じ値が小数で書かれた場合(0.95)は、信頼係数です。 |
| アルファ | \(\alpha\) | \(\alpha = 1 - \text{信頼水準}\);長期的な外れ率、および対応する両側検定の有意水準。 |
| 2で割ったアルファ | \(\alpha/2\) | 両側区間の各端の末尾領域 — 95%区間の場合、末尾あたり0.025。 |
| 臨界値 / z スコア | \(z\) | 標準正規分布からの乗数 \(\Phi^{-1}(1-\alpha/2)\)。z スコアは、より一般的には、値が平均からいくつの標準偏差離れているかを示しています。 |
| 下限 | LB | \(\bar{x} - \text{MoE}\)、区間の小さい方のエンドポイント。 |
| 上限 | UB | \(\bar{x} + \text{MoE}\)、大きい方のエンドポイント。区間は \([\text{LB},\ \text{UB}]\) と書かれます。 |
| 自由度 | \(df = n-1\) | \(\bar{x}\) を推定した後に残された独立情報の数。\(t\) を \(z\) の代替として使用する場合、\(t\) テーブルの行を選択します。 |
| 点推定 | \(\bar{x}\) | \(\mu\) の単一の最良推定値。それは独自の不確実性の指標を持ちません。 |
| 区間推定 | \([\text{LB}, \text{UB}]\) | 陳述された信頼水準を持つ範囲。点推定とその精度を報告します。これが学術誌と標準化団体がそれを好む理由です。 |
| 信頼区間 | CI | パラメータの範囲—ここでは母平均。\(n \to \infty\) のとき、単一の点に向かって狭くなります。 |
| 予測区間 | PI | 単一の将来の観測の範囲。同じデータの CI よりも常に広いです。個々のレベルの変動を含むため。\(n\) が成長しても単一の点にはシュリンクしません。代わりに、おおよそ \(\mu \pm z\sigma\) に収束します。 |
よくある質問
区間が広いほど結果が悪いということですか? 区間が広いということは、それだけ不確実性が大きいことを意味します。信頼水準を上げる(例:95%から99%へ)と区間は広くなり、標本サイズが小さい場合も広がります。逆に標本サイズを大きくすると区間は狭くなります。
「95%の信頼度」とは具体的にどういう意味ですか? 同じ標本抽出を何度も繰り返し、その都度区間を作ったとすると、そのうち約95%の区間が母集団の真の平均を含む、という意味です。
zとt、どちらを使うべきですか? 本ツールはz分布(正規分布)を用いており、これは標本サイズが大きい場合や母集団の標準偏差が既知の場合に適しています。標本サイズが非常に小さく、母集団の標準偏差が不明な場合は、厳密にはt分布のほうがより正確です。