Bu Güven Aralığı Hesaplayıcı Ne İşe Yarar?
Güven aralığı, tek bir örnekleme dayanarak gerçek ana kütle ortalamasını büyük olasılıkla içeren bir değer aralığı sunar. Bu hesaplayıcı, örneklem istatistiklerinizi alır ve size bir alt sınır, bir üst sınır ve hata payı verir; böylece "gerçek ortalama %95 güvenle X ile Y arasındadır" şeklinde sonuçlar bildirebilirsiniz. Araç, örneklem yeterince büyük olduğunda ya da ana kütle standart sapması bilindiğinde tercih edilen standart yaklaşım olan z-dağılımını (normal dağılım) kullanır.
Girmeniz Gereken Değerler
- Örneklem Ortalaması — örneklem verilerinizin ortalaması (aralığınızın merkezi).
- Standart Sapma — örneklem değerlerinizin ne kadar dağınık olduğu.
- Örneklem Büyüklüğü — örneklemdeki gözlem sayısı.
- Güven Düzeyi — ne kadar emin olmak istediğiniz; genellikle %90, %95 veya %99.
Kullanılan Formül
Hesaplayıcı şu adımları izler:
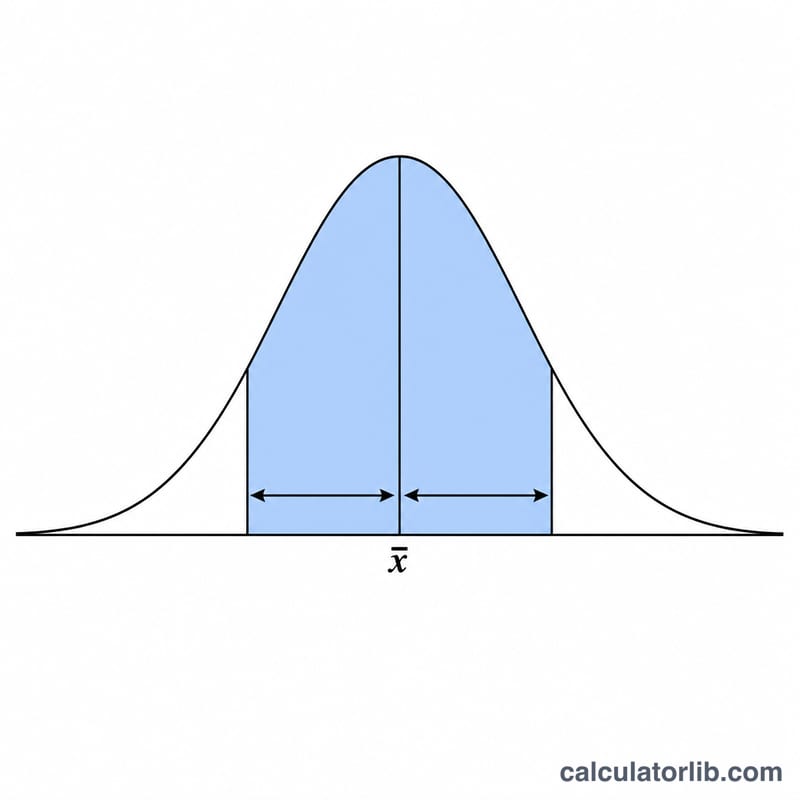
- Standart Hata = Standart Sapma ÷ √(Örneklem Büyüklüğü)
- Z-skoru = güven düzeyinize karşılık gelen normal dağılım kritik değeri (örneğin %90 için 1,645; %95 için 1,96; %99 için 2,576)
- Hata Payı = Z-skoru × Standart Hata
- Güven Aralığı = Örneklem Ortalaması ± Hata Payı
Z-skoru, alfa/2 noktasındaki ters kümülatif olasılık alınarak bulunur; burada alfa = 1 − güven düzeyidir. Bu yöntem, belirsizliği iki kuyruk arasında eşit olarak böler.
Örnek Hesaplama
Örneklem ortalamanızın 100, standart sapmanızın 15, örneklem büyüklüğünüzün 36 olduğunu ve %95 güven düzeyini seçtiğinizi varsayalım.
- Standart Hata = 15 ÷ √36 = 15 ÷ 6 = 2,5
- %95 için Z-skoru = 1,96
- Hata Payı = 1,96 × 2,5 = 4,9
- Alt sınır = 100 − 4,9 = 95,1
- Üst sınır = 100 + 4,9 = 104,9
Gerçek ana kütle ortalamasının 95,1 ile 104,9 arasında olduğundan %95 güvenle emin olabilirsiniz.
Güven Aralığınız Nasıl Yorumlanır
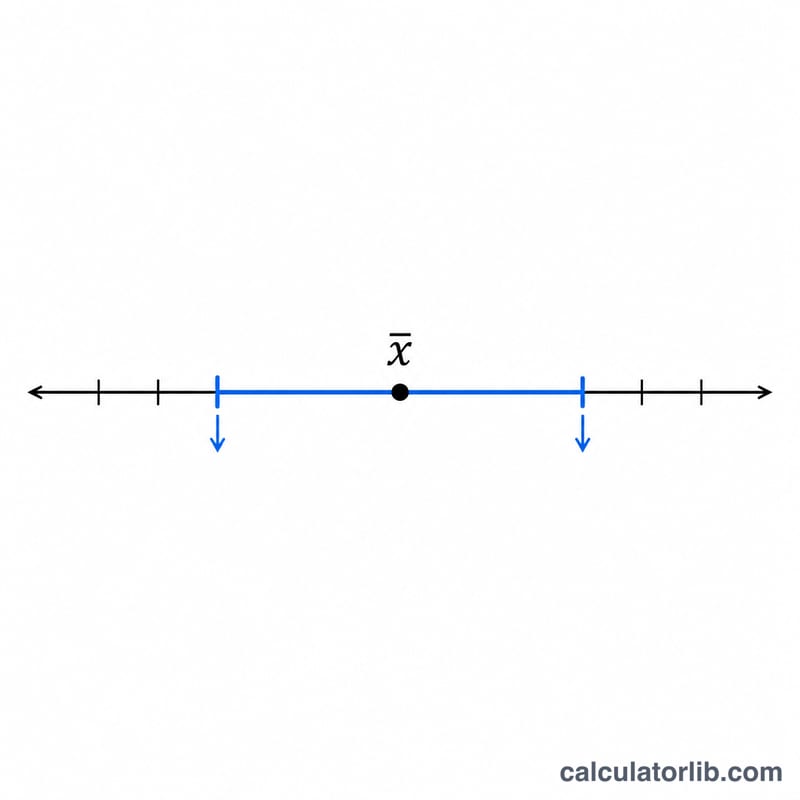
Güven aralığı, örneklemden oluşturulan popülasyon ortalaması \(\mu\) için olası değerlerin bir aralığını bildirir. Desteklediği ifade ekranınızdaki bir aralık hakkında değil, prosedür hakkındadır: aynı örneklemeyi tekrarlayıp her seferinde %95 aralığı hesaplasaydınız, bu aralıkların yaklaşık %95'i gerçek ortalamayı içerirdi. Gerçek ortalama sabit (ama bilinmeyen) bir sayıdır — hareket etmez. Rastgele olan aralıktır, çünkü rastgele bir örneklemden hesaplanmıştır. Bu nedenle "μ bu iki sayı arasında olma olasılığı %95'tir" demek doğru değildir; aralık hesaplandıktan sonra μ ya içindedir ya da değildir. (Bayesci güvenilir aralıklar doğrudan bir olasılık ifadesini destekler, ancak bunlar farklı bir yapıdır ve bir öncül gerektirir.)
Genişlik: bir tahmini kesin yapan nedir
Daha dar bir aralık daha kesin bir tahmini anlamına gelir. Yarı genişlik hata marjıdır
$$\text{Hata Marjı} = z \cdot \frac{s}{\sqrt{n}}$$bu nedenle üç şey bunu etkiler:
- Örneklem büyüklüğü \(n\) — marj \(\sqrt{n}\) ile küçülür, \(n\) ile değil. Örneklemi dörtlendirmek hata marjını yarıya indirir; marjı tekrar yarıya indirmek orijinal örneğin 16 katını gerektirir. Bu nedenle kesinlik hızla pahalı hale gelir.
- Güven düzeyi — daha yüksek bir düzey daha büyük bir kritik değer kullanır, bu nedenle %99 aralığı aynı veriler üzerinde her zaman %95 aralığından daha geniştir (2.576/1.960 ≈ 1.31, yaklaşık %31 daha geniş). Güven ve kesinlik birbirleriyle ödünleşir.
- Dağılım \(s\) — daha değişken veriler aynı \(n\) için daha geniş bir aralık verir.
Bir referans veya varsayılan değeri okuma
Önemsediğiniz bir değeri kontrol edin — fark veya değişim skoru için 0, hedef ortalama, geçen yılın rakamı, bir spesifikasyon değeri — aralık içine düşüyor mu. Referans değer iki taraflı \(100(1-\alpha)\%\) aralığının dışında yer alırsa, \(H_0: \mu = \text{referans}\) için karşılık gelen iki taraflı test \(\alpha = 1 - \text{güven düzeyi}\) anlamlılık düzeyinde reddedilir; içinde yer alırsa, test reddedilmez. %95 aralık ve \(\alpha = 0.05\)'de iki taraflı test aynı hesaplamanın iki görüşüdür. "Reddedilmedi" veriler bu değerle uyumlu — değerin doğru olduğu ve etkinin sıfır olduğu anlamına gelmez.
Ayrıca aralığın uçlarını substantif olarak okuyun. [0.2, 19.8] aralığı sıfırı hariç tutarken 0 ile 0 arasında değişen etkilerle uyumludur; bu [9.5, 10.5]'den farklı bir durumdur ve sıfırı hariç tutar ve etkiyi dar aralıkta kilitler.
Ortamlar, bireyler değil
Bu aralık, sonraki bir gözlem değil, popülasyonun ortalaması kapsamındadır. Büyük bir \(n\) ile ortalama aralığı çok dar olabilirken bireysel değerler hala geniş aralıkta dağılır. Tek bir gelecek gözlemi içermesi muhtemel bir aralığa ihtiyacınız varsa, bu bir tahmin aralığı'dır ve bu çok daha geniştir çünkü bireysel varyasyonu ek olarak ortalama hakkında belirsizliği absorbe etmesi gerekir.
Güvendiğiniz varsayımlar
- İlgilenilen popülasyondan rastgele, bağımsız gözlemler. Kolaylık örnekleri, kümelenmiş veriler, aynı konulara yönelik tekrarlanan ölçümler ve zaman serisi verileri bunu ihlal eder ve aralık tipik olarak çok dar olur.
- Ortalama örnekleme dağılımının yaklaşık normalliği. Merkezi Limit Teoremi tarafından bu genellikle orta düzey çarpık veriler için \(n \ge 30\) kez makul olur; küçük örnekler için popülasyonun kendisinin kabaca normal olması gerekir ve güçlü çarpık veriler veya ağır aykırı değerler için hatta \(n = 30\) da yeterli olmayabilir.
- Bilinen \(\sigma\) veya geniş \(n\) yaklaşıklığı. Bu hesaplayıcı normal kritik değeri \(z\) kullanır. \(\sigma\) küçük bir örnekten \(s\) tarafından tahmin edildiğinde, \(n-1\) serbestlik derecesi ile \(t\) dağılımı kesinlikle doğru seçim ve biraz daha geniş aralık verir; fark \(n\) kabaca 30'dan yukarı olduğunda küçülür.
- Sistematik hata yok. Aralık sadece örnekleme değişkenliğini ölçer. Seçim önyargısı, yanıt vermeme, kötü ifade edilen bir soru, yanlış kalibre edilmiş bir araç veya ölçüm hatası için düzeltme yapmaz. Önyargılı bir örnek yanlış değer etrafında sıkı bir aralık üretir — ve büyük \(n\), bu yanlış aralığı daha sıkı yapar, daha iyi değil.
Son olarak, aynı verilerden birçok aralık hesaplarsanız, en azından birinin hedefini kaçırma şansı \(\alpha\)'nın çok üstüne çıkar; bu çokluluk ayarlaması gerektirir. Bu bölüm genel istatistiksel bilgidir, belirli bir çalışma tasarımı için uyarlanmış tavsiye değildir.
Temel Terimler ve Değişkenler
| Terim | Sembol | Anlamı |
|---|---|---|
| Örneklem ortalaması | \(\bar{x}\) | Gözlemlenen verilerinizin aritmetik ortalaması, \(\bar{x} = \frac{1}{n}\sum x_i\). Ölçtüğünüz şey ve aralığın merkezidir. |
| Popülasyon ortalaması | \(\mu\) | Tüm popülasyon genelinde gerçek ortalama. Bilinmeyen, sabit ve aralığın çerçevelemeye çalıştığı miktardır. |
| Örneklem standart sapması | \(s\) | Bireysel gözlemlerin dağılımı, paydada \(n-1\) ile hesaplanır: \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\). |
| Popülasyon standart sapması | \(\sigma\) | Popülasyondaki gerçek dağılım. Nadiren bilinir; \(s\) tahmini olarak kullanılır, bu nedenle \(t\) dağılımı vardır. |
| Örneklem büyüklüğü | \(n\) | Bağımsız gözlemlerin sayısı. \(\sqrt{n}\) aracılığıyla kesinliği yönlendirir. |
| Ortalamanın standart hatası | SE | \(\text{SE} = s/\sqrt{n}\). Bir örneklem ortalaması ile popülasyon ortalaması arasındaki tipik mesafe. \(s\) ile farklıdır: \(s\) bireysel olarak ne kadar yayılmış olduğunu açıklar ve daha fazla veri topladıkça küçülmez; SE ortalama hakkında ne kadar belirsiz olduğunu açıklar ve \(n\) büyüdükçe küçülür. |
| Hata marjı | HM | \(\text{HM} = z \times \text{SE}\). Aralığın yarı genişliği — tahminin yanında bildirilen "± sayı". |
| Güven düzeyi | \(1-\alpha\) | Bu şekilde oluşturulan aralıkların uzun vadeli oranı \(\mu\) yakalardı (örneğin %95). Ondalık olarak yazılan aynı değer (0.95) güven katsayısıdır. |
| Alfa | \(\alpha\) | \(\alpha = 1 - \text{güven düzeyi}\); uzun vadeli kaçırma oranı ve eşdeğer iki taraflı testin anlamlılık düzeyi. |
| Alfanın yarısı | \(\alpha/2\) | İki taraflı aralığın her ucundaki kuyruk alanı — %95 aralığı için kuyruk başına 0.025. |
| Kritik değer / z-skoru | \(z\) | Çarpan \(\Phi^{-1}(1-\alpha/2)\) standart normal dağılımından. Bir z-skoru daha genel olarak bir değerin ortalamadan kaç standart sapma uzakta olduğunu belirtir. |
| Alt sınır | AS | \(\bar{x} - \text{HM}\), aralığın daha küçük uç noktası. |
| Üst sınır | ÜS | \(\bar{x} + \text{HM}\), daha büyük uç nokta. Aralık \([\text{AS},\ \text{ÜS}]\) olarak yazılır. |
| Serbestlik derecesi | \(df = n-1\) | \(\bar{x}\) tahmin ettikten sonra kalan bağımsız bilgi parçalarının sayısı. \(z\) yerine \(t\) alternatifi kullanırken \(t\) tablosunun satırını seçer. |
| Nokta tahmini | \(\bar{x}\) | \(\mu\) için tek bir en iyi tahmini sayı. Kendi belirsizliğinin hiçbir göstergesi taşımaz. |
| Aralık tahmini | \([\text{AS}, \text{ÜS}]\) | Belirtilen bir güven düzeyine sahip aralık. Nokta tahmini ve kesinliğini bildirir, bu nedenle dergiler ve standartlar organları genellikle bunu tercih eder. |
| Güven aralığı | GA | Bir parametre için aralık — burada popülasyon ortalaması. \(n \to \infty\) olduğunda tek bir noktaya darlaşır. |
| Tahmin aralığı | TA | Tek bir gelecek gözlem için aralık. Aynı veriler üzerinde GA'dan her zaman daha geniştir, çünkü bireysel düzey varyasyonunu içermesi gerekir; \(n\) büyüdükçe küçülmez, bunun yerine kabaca \(\mu \pm z\sigma\)'a yakınsar. |
Sıkça Sorulan Sorular
Daha geniş bir aralık, daha kötü bir sonuç anlamına mı gelir? Daha geniş bir aralık daha fazla belirsizliği yansıtır. Güven düzeyini yükseltmek (örneğin %95'ten %99'a) veya daha küçük bir örneklem kullanmak aralığı genişletir; daha büyük bir örneklem ise daraltır.
"%95 güven" aslında ne anlama gelir? Örneklemeyi birçok kez tekrarlayıp her seferinde bir aralık oluştursaydınız, bu aralıkların yaklaşık %95'i gerçek ana kütle ortalamasını içerirdi.
z mi yoksa t mi kullanmalıyım? Bu araç, daha büyük örneklemler için veya ana kütle standart sapması bilindiğinde uygun olan z (normal) dağılımını kullanır. Ana kütle standart sapmasının bilinmediği çok küçük örneklemlerde teknik olarak t-dağılımı daha hassastır.