À quoi sert ce calculateur d'intervalle de confiance
Un intervalle de confiance fournit une plage de valeurs susceptible de contenir la vraie moyenne de la population, à partir d'un seul échantillon. Ce calculateur exploite vos statistiques d'échantillon pour renvoyer une borne inférieure, une borne supérieure et la marge d'erreur. Vous pouvez ainsi formuler un résultat du type « la vraie moyenne se situe entre X et Y, avec un niveau de confiance de 95 % ». Il s'appuie sur la loi z (loi normale), l'approche de référence lorsque l'échantillon est suffisamment grand ou que l'écart type de la population est connu.
Les données à renseigner
- Moyenne de l'échantillon — la moyenne de vos données (le centre de l'intervalle).
- Écart type — la dispersion de vos valeurs autour de la moyenne.
- Taille de l'échantillon — le nombre d'observations dans votre échantillon.
- Niveau de confiance — le degré de certitude souhaité, généralement 90 %, 95 % ou 99 %.
La formule
Le calculateur procède selon les étapes suivantes :
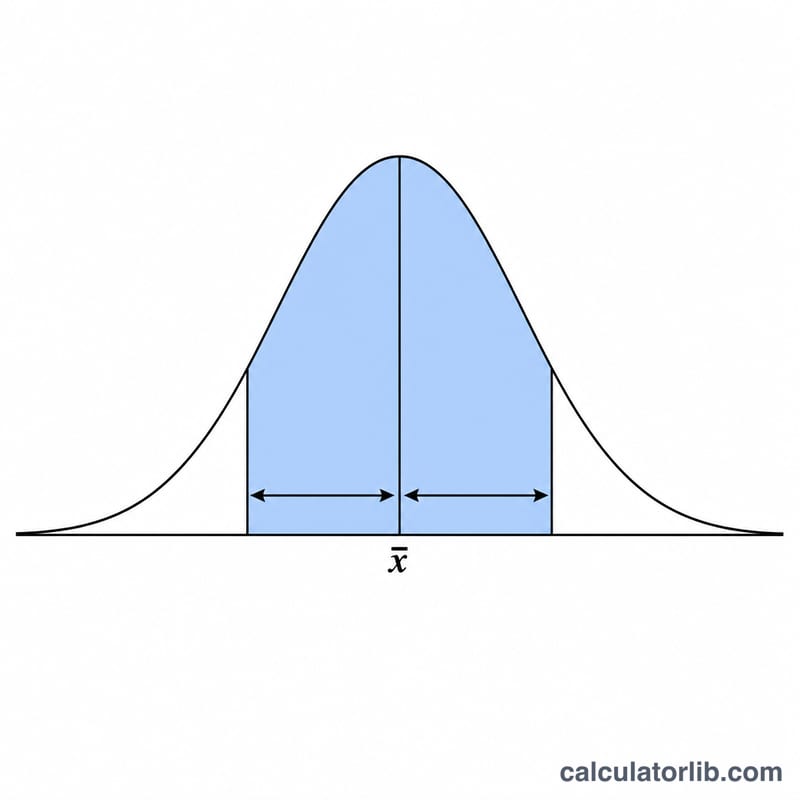
- Erreur standard = Écart type ÷ √(Taille de l'échantillon)
- Score z = la valeur critique de la loi normale correspondant à votre niveau de confiance (par exemple 1,645 pour 90 %, 1,96 pour 95 %, 2,576 pour 99 %)
- Marge d'erreur = Score z × Erreur standard
- Intervalle de confiance = Moyenne de l'échantillon ± Marge d'erreur
Le score z est obtenu en calculant la probabilité cumulée inverse au point alpha/2, où alpha = 1 − niveau de confiance. L'incertitude est ainsi répartie de manière égale entre les deux extrémités de la distribution.
Exemple concret
Supposons une moyenne d'échantillon de 100, un écart type de 15, une taille d'échantillon de 36 et un niveau de confiance de 95 %.
- Erreur standard = 15 ÷ √36 = 15 ÷ 6 = 2,5
- Score z pour 95 % = 1,96
- Marge d'erreur = 1,96 × 2,5 = 4,9
- Borne inférieure = 100 − 4,9 = 95,1
- Borne supérieure = 100 + 4,9 = 104,9
Vous pouvez affirmer avec un niveau de confiance de 95 % que la vraie moyenne de la population se situe entre 95,1 et 104,9.
Interpréter votre intervalle de confiance
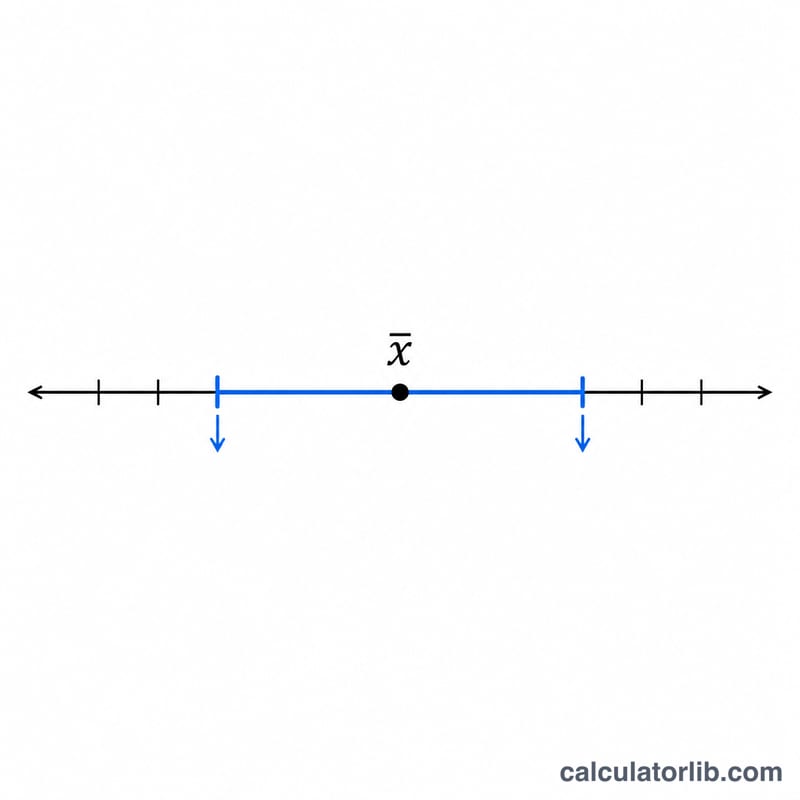
Un intervalle de confiance rapporte une plage de valeurs plausibles pour la moyenne de la population \(\mu\), construite à partir de votre échantillon. L'affirmation qu'il soutient concerne la procédure, et non l'intervalle unique sur votre écran : si vous répétiez l'échantillonnage identique et calculiez un intervalle à 95 % à chaque fois, environ 95 % de ces intervalles contiendraient la vraie moyenne. La vraie moyenne est un nombre fixe (mais inconnu) — elle ne se déplace pas. Ce qui est aléatoire, c'est l'intervalle, car il est calculé à partir d'un échantillon aléatoire. Il n'est donc pas correct de dire « il y a une probabilité de 95 % que \(\mu\) se situe entre ces deux nombres » ; une fois l'intervalle calculé, \(\mu\) est soit à l'intérieur, soit à l'extérieur. (Les intervalles crédibles bayésiens supportent bien une affirmation de probabilité directe, mais il s'agit d'une construction différente qui nécessite une distribution a priori.)
Largeur : ce qui rend une estimation précise
Un intervalle plus étroit signifie une estimation plus précise. La demi-largeur est la marge d'erreur
$$\text{Marge d'erreur} = z \cdot \frac{s}{\sqrt{n}}$$trois choses l'affectent donc :
- Taille de l'échantillon \(n\) — la marge se réduit avec \(\sqrt{n}\), pas avec \(n\). Quadrupler l'échantillon réduit de moitié la marge d'erreur ; réduire de moitié la marge à nouveau nécessite 16× l'échantillon d'origine. C'est pourquoi la précision devient coûteuse rapidement.
- Niveau de confiance — un niveau plus élevé utilise une valeur critique plus grande, de sorte qu'un intervalle à 99 % est toujours plus large qu'un intervalle à 95 % sur les mêmes données (\(2.576/1.960 \approx 1.31\), environ 31 % plus large). La confiance et la précision se font mutuellement concurrence.
- Dispersion \(s\) — des données plus variables donnent un intervalle plus large pour le même \(n\).
Lecture d'une valeur de référence ou hypothétique
Vérifiez si une valeur qui vous intéresse — 0 pour une différence ou un score de changement, une moyenne cible, un chiffre de l'année dernière, une valeur de spécification — se situe à l'intérieur de l'intervalle. Si la valeur de référence se situe à l'extérieur d'un intervalle bilatéral \(100(1-\alpha)\%\), le test bilatéral correspondant \(H_0: \mu = \text{référence}\) rejette au niveau de signification \(\alpha = 1 - \text{niveau de confiance}\) ; si elle se situe à l'intérieur, le test ne rejette pas. Un intervalle à 95 % et un test bilatéral à \(\alpha = 0,05\) sont deux vues du même calcul. « Non rejeté » signifie que les données sont compatibles avec cette valeur — non pas que la valeur est vraie, et non pas que l'effet est zéro.
Lisez aussi les extrémités de l'intervalle de manière substantielle. Un intervalle de [0.2, 19.8] exclut zéro mais est compatible avec des effets allant de trivial à grand ; c'est une situation différente de [9.5, 10.5], qui exclut zéro et fixe l'effet.
Moyennes, pas les individus
Cet intervalle couvre la moyenne de la population, pas la prochaine observation. Avec un grand \(n\), l'intervalle pour la moyenne peut être très étroit tandis que les valeurs individuelles sont encore largement dispersées. Si vous avez besoin d'une plage susceptible de contenir une seule observation future, c'est un intervalle de prédiction, qui est beaucoup plus large car il doit absorber la variation individuelle en plus de l'incertitude sur la moyenne.
Hypothèses sur lesquelles vous vous appuyez
- Observations aléatoires et indépendantes provenant de la population d'intérêt. Les échantillons de convenance, les données groupées, les mesures répétées sur les mêmes sujets et les données de séries chronologiques violent cela, et l'intervalle sera généralement trop étroit.
- Normalité approximative de la distribution d'échantillonnage de la moyenne. Par le théorème central limite, c'est généralement raisonnable une fois \(n \ge 30\) pour les données modérément asymétriques ; pour les petits échantillons, la population elle-même devrait être approximativement normale, et pour les données fortement asymétriques ou les valeurs aberrantes importantes, même \(n = 30\) peut ne pas suffire.
- \(\sigma\) connu ou approximation du grand \(n\). Ce calculateur utilise la valeur critique normale \(z\). Quand \(\sigma\) est estimé par \(s\) d'un petit échantillon, la distribution \(t\) avec \(n-1\) degrés de liberté est le choix strictement correct et donne un intervalle légèrement plus large ; la différence est petite une fois que \(n\) dépasse approximativement 30.
- Pas d'erreur systématique. L'intervalle quantifie uniquement la variabilité d'échantillonnage. Il ne corrige pas le biais de sélection, la non-réponse, une question mal formulée, un instrument mal étalonné ou une erreur de mesure. Un échantillon biaisé produit un intervalle serré autour de la mauvaise valeur — et un grand \(n\) rend cet intervalle faux plus serré, pas mieux.
Enfin, si vous calculez plusieurs intervalles à partir des mêmes données, la chance qu'au moins un manque sa cible augmente bien au-delà de \(\alpha\) ; cela nécessite un ajustement de multiplicité. Cette section est une information statistique générale, pas un conseil adapté à un plan d'étude spécifique.
Termes et variables clés
| Terme | Symbole | Signification |
|---|---|---|
| Moyenne d'échantillon | \(\bar{x}\) | La moyenne arithmétique de vos données observées, \(\bar{x} = \frac{1}{n}\sum x_i\). C'est ce que vous mesurez et le centre de l'intervalle. |
| Moyenne de la population | \(\mu\) | La vraie moyenne sur l'ensemble de la population. Inconnue, fixe, et la quantité que l'intervalle essaie de mettre entre parenthèses. |
| Écart-type d'échantillon | \(s\) | Dispersion des observations individuelles, calculée avec \(n-1\) au dénominateur : \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n-1}}\). |
| Écart-type de la population | \(\sigma\) | Dispersion vraie dans la population. Rarement connu ; \(s\) est utilisé comme son estimation, c'est pourquoi la distribution \(t\) existe. |
| Taille de l'échantillon | \(n\) | Nombre d'observations indépendantes. Détermine la précision à travers \(\sqrt{n}\). |
| Erreur-type de la moyenne | SE | \(\text{SE} = s/\sqrt{n}\). La distance typique entre une moyenne d'échantillon et la moyenne de la population. Distinct de \(s\) : \(s\) décrit la dispersion des individus et ne diminue pas au fur et à mesure que vous collectez plus de données ; SE décrit l'incertitude sur la moyenne et diminue à mesure que \(n\) croît. |
| Marge d'erreur | MoE | \(\text{MoE} = z \times \text{SE}\). La demi-largeur de l'intervalle — le « nombre ± » signalé aux côtés de l'estimation. |
| Niveau de confiance | \(1-\alpha\) | La proportion à long terme des intervalles construits de cette manière qui capturerait \(\mu\) (p. ex. 95 %). La même valeur écrite en décimal (0.95) est le coefficient de confiance. |
| Alpha | \(\alpha\) | \(\alpha = 1 - \text{niveau de confiance}\) ; le taux de manquement à long terme, et le niveau de signification du test bilatéral équivalent. |
| Alpha sur deux | \(\alpha/2\) | La zone de queue à chaque extrémité d'un intervalle bilatéral — 0.025 par queue pour un intervalle à 95 %. |
| Valeur critique / score z | \(z\) | Le multiplicateur \(\Phi^{-1}(1-\alpha/2)\) de la distribution normale standard. Un score z indique plus généralement de combien d'écarts-types une valeur s'écarte de la moyenne. |
| Limite inférieure | LB | \(\bar{x} - \text{MoE}\), l'extrémité plus petite de l'intervalle. |
| Limite supérieure | UB | \(\bar{x} + \text{MoE}\), l'extrémité plus grande. L'intervalle est écrit \([\text{LB},\ \text{UB}]\). |
| Degrés de liberté | \(df = n-1\) | Le nombre de pièces d'information indépendantes restantes après l'estimation de \(\bar{x}\). Sélectionne la ligne du tableau \(t\) lors de l'utilisation de l'alternative \(t\) à \(z\). |
| Estimation ponctuelle | \(\bar{x}\) | Un seul nombre de meilleure estimation pour \(\mu\). Il ne porte aucune indication de sa propre incertitude. |
| Estimation par intervalle | \([\text{LB}, \text{UB}]\) | Une plage avec un niveau de confiance énoncé. Rapporte l'estimation ponctuelle et sa précision, c'est pourquoi les journaux et organismes de normalisation la préfèrent généralement. |
| Intervalle de confiance | CI | Une plage pour un paramètre — ici la moyenne de la population. Se rétrécit vers un seul point à mesure que \(n \to \infty\). |
| Intervalle de prédiction | PI | Une plage pour une seule observation future. Toujours plus large que l'IC sur les mêmes données, car il inclut la variation au niveau individuel ; il ne rétrécit pas vers un point à mesure que \(n\) augmente, convergeant plutôt vers approximativement \(\mu \pm z\sigma\). |
Questions fréquentes
Un intervalle plus large signifie-t-il un moins bon résultat ? Un intervalle plus large traduit une plus grande incertitude. Augmenter le niveau de confiance (par exemple de 95 % à 99 %) ou disposer d'un échantillon plus petit élargit l'intervalle ; à l'inverse, un échantillon plus grand le resserre.
Que signifie réellement « 95 % de confiance » ? Si vous répétiez l'échantillonnage un grand nombre de fois en construisant un intervalle à chaque tirage, environ 95 % de ces intervalles contiendraient la vraie moyenne de la population.
Faut-il utiliser z ou t ? Cet outil emploie la loi z (loi normale), adaptée aux grands échantillons ou lorsque l'écart type de la population est connu. Pour de très petits échantillons dont l'écart type de la population est inconnu, la loi de Student (t) est techniquement plus précise.