Qu'est-ce que l'indice de capabilité du processus (Cp, Cpk) ?
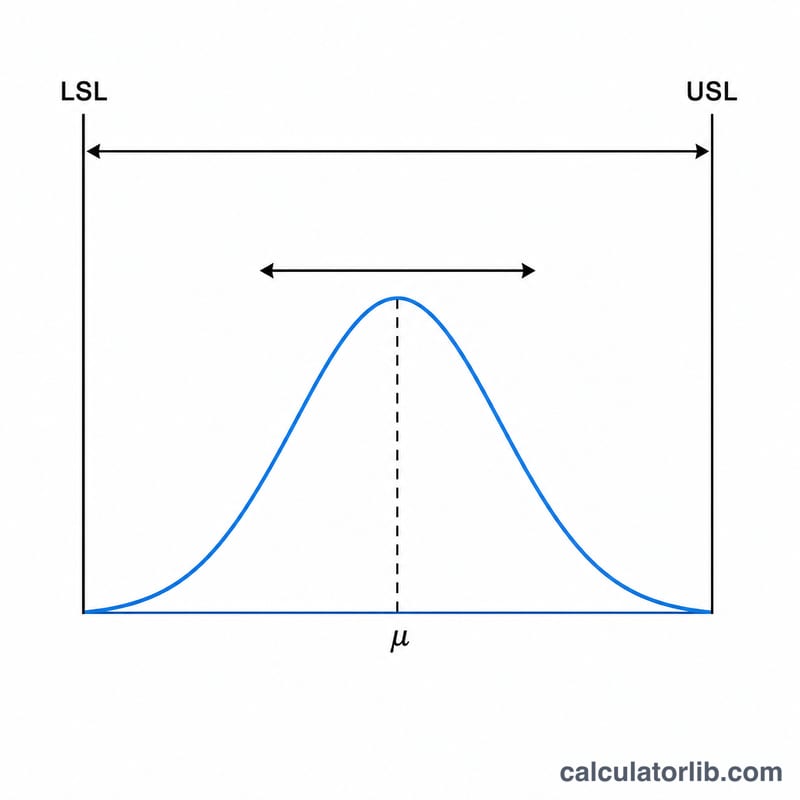
Le Cp et le Cpk sont des indicateurs fondamentaux de la maîtrise statistique des procédés (MSP, ou SPC en anglais) et de l'ingénierie qualité. Ils confrontent la dispersion naturelle d'un procédé de fabrication (six fois son écart-type) à la fenêtre de tolérance définie par la limite de spécification inférieure (LSI, ou LSL) et la limite de spécification supérieure (LSS, ou USL). C'est un outil statistique universel, sans règles propres à un pays.
Le Cp traduit la capabilité potentielle, en supposant le procédé parfaitement centré. Le Cpk traduit la capabilité réelle : il pénalise en plus tout décalage de la moyenne du procédé par rapport au centre de la fenêtre de tolérance.
Comment utiliser ce calculateur
Collez ou saisissez vos mesures dans le champ Données, en les séparant par des virgules, des espaces, des tabulations ou des retours à la ligne. Indiquez les limites de spécification inférieure et supérieure dans la même unité que vos données. Le calculateur analyse la liste, calcule la moyenne, la variance, l'écart-type, le 3 sigma et le 6 sigma, puis en déduit le Cp et le Cpk.
La formule expliquée
Pour des données \(x_1..x_n\), la moyenne vaut \(\mu = (\sum x_i) / n\). La variance de population est \(\sum(x_i - \mu)^2 / n\) et \(\sigma\) en est la racine carrée. On a alors les formules de capabilité :
$$C_p = \frac{\text{USL} - \text{LSL}}{6\,\sigma} \qquad C_{pk} = \min\!\left( \frac{\text{USL} - \mu}{3\,\sigma},\; \frac{\mu - \text{LSL}}{3\,\sigma} \right)$$À noter : cet outil utilise l'écart-type de population (division par \(n\)), de sorte que \(\sigma\) alimente les formules de capabilité de façon cohérente.
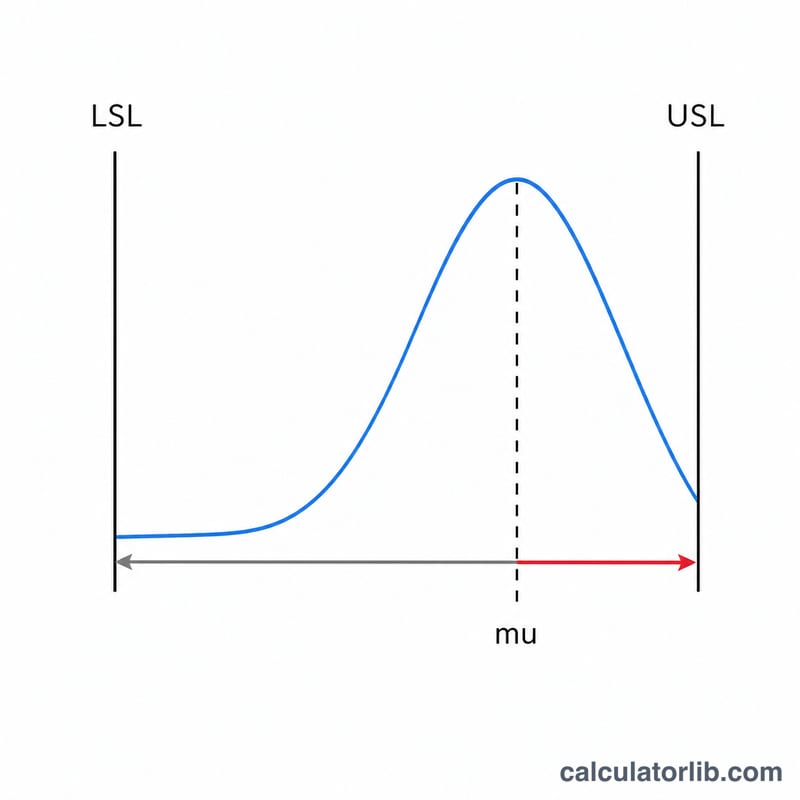
Repère : Cp = Cpk = 1 signifie que la dispersion à +/-3 sigma correspond exactement à la largeur de la tolérance. La cible généralement recommandée est de 1,33 (+/-4 sigma). Plus c'est élevé, mieux c'est ; une valeur inférieure à 1,0 indique un procédé non capable. Un résultat de 0 pour Cp/Cpk signifie ici que sigma = 0 (aucune variation) ou que la plage de spécification est invalide.
Exemple résolu
Données = 45, 46, 44, 47, 43, 48, 45, 46, 44, 47 (\(n = 10\)), LSL = 40, USL = 50. Somme = 455, donc \(\mu = 45{,}5\). La somme des écarts au carré vaut 22,5, soit une variance de 2,25 et \(\sigma = 1{,}5\). On obtient \(3\sigma = 4{,}5\) et \(6\sigma = 9{,}0\).
$$C_p = \frac{10}{9} \approx 1{,}1111$$$$C_{pk} = \min\!\left[ \frac{50 - 45{,}5}{4{,}5} ;\; \frac{45{,}5 - 40}{4{,}5} \right] = \min[1{,}0 ;\; 1{,}2222] = 1{,}0$$Termes et variables clés
| Terme / symbole | Signification |
|---|---|
| LSL — limite inférieure de spécification | La plus petite valeur acceptable de la caractéristique, dans l'unité de mesure (mm, g, MPa, °C, …). Établie par l'ingénierie sur le dessin ou la spécification. |
| USL — limite supérieure de spécification | La plus grande valeur acceptable, même unité que la mesure. |
| Largeur de tolérance | \(\text{USL} - \text{LSL}\), la largeur totale de la fenêtre acceptable, en unités de mesure. Parfois écrite \(2T\) autour d'une cible nominale. |
| \(\mu\) — moyenne du processus | Moyenne des valeurs mesurées, \(\mu = \frac{1}{n}\sum x_i\); même unité que les données. Estimée à partir de l'échantillon comme \(\bar{x}\). |
| \(\sigma\) — écart-type | Dispersion de la caractéristique, même unité que les données. Cet outil utilise la forme de population \(\sigma = \sqrt{\frac{1}{n}\sum (x_i - \mu)^2}\) (divisé par \(n\)); la forme d'échantillon divise par \(n-1\). |
| \(3\sigma\) et \(6\sigma\) dispersion | \(3\sigma\) est la demi-largeur de la dispersion naturelle du processus (un côté de la moyenne); \(6\sigma\), de \(\mu - 3\sigma\) à \(\mu + 3\sigma\), est la dispersion naturelle complète, contenant environ 99,73 % d'une distribution normale. La capacité compare cette dispersion à la largeur de tolérance. |
| \(C_p\) — capacité potentielle | \(C_p = (\text{USL} - \text{LSL})/(6\sigma)\). Ratio adimensionnel de la largeur de tolérance à la dispersion naturelle; ignore où se situe la moyenne, c'est donc la meilleure capacité réalisable si le processus était parfaitement centré. |
| \(C_{pu}\), \(C_{pl}\) — indices unilatéraux | \(C_{pu} = (\text{USL} - \mu)/(3\sigma)\) mesure l'espace jusqu'à la limite supérieure; \(C_{pl} = (\mu - \text{LSL})/(3\sigma)\) mesure l'espace jusqu'à la limite inférieure. L'un ou l'autre peut être signalé seul pour une spécification unilatérale. |
| \(C_{pk}\) — capacité réelle | \(C_{pk} = \min(C_{pu}, C_{pl})\) — capacité à la limite la plus proche, elle reflète à la fois la dispersion et le centrage. Toujours \(C_{pk} \le C_p\); négatif si \(\mu\) se situe en dehors d'une limite. |
| \(k\) — décalage de centrage | Fraction adimensionnelle de la demi-tolérance par laquelle la moyenne manque le point médian: \(k = \lvert m - \mu \rvert / \big((\text{USL} - \text{LSL})/2\big)\) avec point médian \(m\). Alors \(C_{pk} = (1-k)\,C_p\); \(k = 0\) signifie parfaitement centré. |
| \(P_p\), \(P_{pk}\) — indices de performance | Mêmes formules que \(C_p\) et \(C_{pk}\) mais calculés avec l'écart-type global (long terme) de toutes les données, y compris la dérive entre les sous-groupes. \(C_p\)/\(C_{pk}\) dans le sens strict du SPC utilisent une estimation intra-groupe comme \(\bar{R}/d_2\). L'écart entre les deux paires est une mesure de l'instabilité du processus. |
| Contrôle statistique | Un état dans lequel le processus montre uniquement une variation de cause commune (aléatoire) — une moyenne stable et une dispersion stable dans le temps — de sorte que sa sortie future est prévisible. Confirmé avec un graphique de contrôle (par exemple X̄–R ou individus–plage mobile), pas avec un indice de capacité. |
| DPMO / PPM | Défauts par million d'opportunités / pièces par million non conformes: la fraction estimée en dehors de la spécification multipliée par 1 000 000. Pour un processus normal centré, il est dérivé des queues de la distribution normale, c'est donc une estimation basée sur un modèle plutôt qu'un décompte. |
| Limites de spécification vs limites de contrôle | Les limites de spécification (LSL, USL) sont des exigences établies par l'ingénierie, le client ou une norme — elles proviennent de l'intention de conception et ne proviennent jamais des données. Les limites de contrôle (LCL, UCL) sont calculées à partir des données du processus à ±3 erreurs types de la statistique tracée et décrivent ce que le processus fait réellement. Ils répondent à des questions différentes et ne doivent jamais être mélangés ou tracés de manière interchangeable: un point en dehors d'une limite de contrôle signale l'instabilité; une valeur en dehors d'une limite de spécification est une pièce non conforme. |
FAQ
Quelle valeur de Cpk viser ? Un Cpk de 1,33 (correspondant à \(\pm 4\sigma\)) est une cible couramment retenue. En dessous de 1,0, le procédé ne peut pas respecter de façon fiable les spécifications.
Pourquoi le Cp et le Cpk diffèrent-ils ? Le Cp ignore le centrage, tandis que le Cpk diminue dès que la moyenne du procédé s'éloigne du milieu de la fenêtre de tolérance. Le Cpk est toujours inférieur ou égal au Cp.
Et si toutes les valeurs sont identiques ? Alors \(\sigma = 0\) et la capabilité est mathématiquement infinie (variation nulle) ; cet outil renvoie donc 0 pour éviter une division par zéro.