공정능력지수(Cp, Cpk)란?
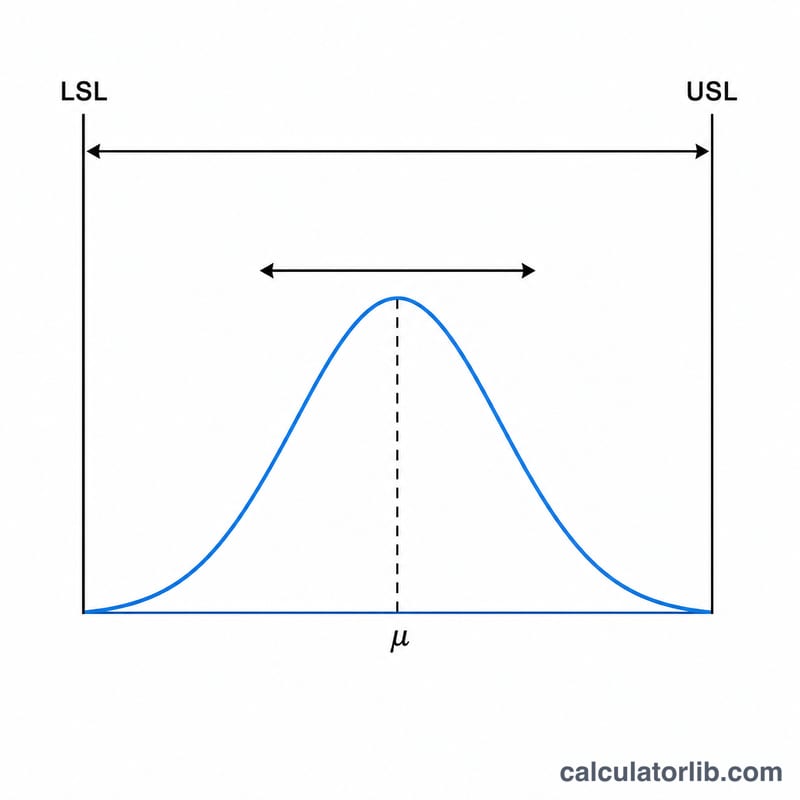
Cp와 Cpk는 통계적 공정관리(SPC)와 품질공학에서 가장 핵심이 되는 지표입니다. 제조 공정이 만들어내는 산포(출력값의 표준편차 6배)를 하한 규격 한계(LSL)와 상한 규격 한계(USL)로 정의된 설계 규격 폭과 비교해 보여줍니다. 특정 국가의 규정에 얽매이지 않는 보편적인 통계 도구입니다.
Cp는 공정이 규격의 중앙에 완벽하게 위치해 있다고 가정했을 때의 잠재적 능력을 나타냅니다. 반면 Cpk는 공정 평균이 규격 중심에서 벗어난 정도까지 반영해 실제 능력을 보여줍니다.
계산기 사용 방법
측정한 데이터 값을 데이터 입력란에 붙여넣거나 직접 입력하세요. 값은 쉼표, 공백, 탭 또는 줄바꿈으로 구분하면 됩니다. 하한·상한 규격 한계는 데이터와 같은 단위로 입력합니다. 계산기는 입력된 값을 분석해 평균, 분산, 표준편차, 3시그마, 6시그마를 구하고, 이를 바탕으로 Cp와 Cpk를 산출합니다.
공식 풀이
데이터 \(x_1..x_n\)에 대해 평균은 \(\mu = \frac{\sum x_i}{n}\) 입니다. 모분산은 \(\frac{\sum (x_i - \mu)^2}{n}\) 이고, \(\sigma\)는 그 제곱근입니다. 이어서 다음과 같이 계산합니다.
$$C_p = \frac{\text{USL} - \text{LSL}}{6\,\sigma} \qquad C_{pk} = \min\!\left( \frac{\text{USL} - \mu}{3\,\sigma},\; \frac{\mu - \text{LSL}}{3\,\sigma} \right)$$이 도구는 모표준편차(n으로 나누는 방식)를 사용하므로, \(\sigma\)가 능력 지수 계산에 일관되게 적용됩니다.
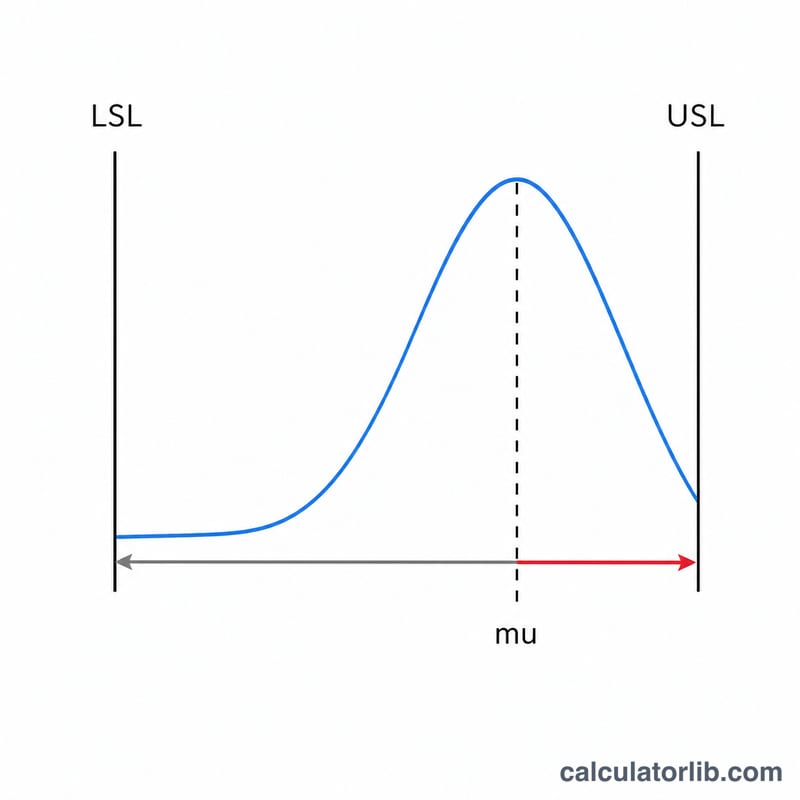
참고: Cp = Cpk = 1이면 ±3시그마 산포가 규격 폭과 정확히 일치한다는 뜻입니다. 일반적으로 권장되는 목표치는 1.33(±4시그마)입니다. 값이 클수록 좋으며, 1.0 미만이면 공정이 능력을 갖추지 못한 상태입니다. 이 계산기에서 Cp/Cpk가 0으로 나오면 시그마 = 0(산포 없음)이거나 규격 범위가 잘못 입력된 경우입니다.
계산 예시
데이터 = 45, 46, 44, 47, 43, 48, 45, 46, 44, 47 (\(n = 10\)), \(\text{LSL} = 40\), \(\text{USL} = 50\)인 경우를 살펴봅시다. 합계 = 455이므로 \(\mu = 45.5\)입니다. 편차 제곱의 합은 22.5이므로 분산 = 2.25, \(\sigma = 1.5\)가 됩니다. 따라서 \(3\sigma = 4.5\), \(6\sigma = 9.0\)입니다.
$$C_p = \frac{10}{9} \approx 1.1111$$$$C_{pk} = \min\!\left[ \frac{50 - 45.5}{4.5},\; \frac{45.5 - 40}{4.5} \right] = \min[1.0,\; 1.2222] = 1.0$$주요 용어 및 변수
| 용어 / 기호 | 의미 |
|---|---|
| LSL — 하한 규격 한계 | 특성의 가장 작은 허용 값으로, 측정 단위(mm, g, MPa, °C, …)로 표시됩니다. 도면이나 규격에서 설계팀에 의해 설정됩니다. |
| USL — 상한 규격 한계 | 가장 큰 허용 값으로, 측정값과 동일한 단위입니다. |
| 공차 폭 | \(\text{USL} - \text{LSL}\), 측정 단위의 허용 창 전체 너비입니다. 때로는 명목 목표 주위에 \(2T\)로 표기됩니다. |
| \(\mu\) — 공정 평균 | 측정값의 평균으로, \(\mu = \frac{1}{n}\sum x_i\)이며, 데이터와 동일한 단위입니다. 표본에서 \(\bar{x}\)로 추정됩니다. |
| \(\sigma\) — 표준 편차 | 특성의 분포로, 데이터와 동일한 단위입니다. 이 도구는 모집단 형식 \(\sigma = \sqrt{\frac{1}{n}\sum (x_i - \mu)^2}\) (\(n\)으로 나눔)을 사용하며, 표본 형식은 \(n-1\)로 나눕니다. |
| \(3\sigma\) 및 \(6\sigma\) 분포 | \(3\sigma\)는 자연 공정 분포의 반폭(평균의 한쪽)입니다. \(6\sigma\), \(\mu - 3\sigma\)에서 \(\mu + 3\sigma\)까지는 정규 분포의 약 99.73%를 포함하는 전체 자연 분포입니다. 능력도는 이 분포를 공차 폭과 비교합니다. |
| \(C_p\) — 잠재 능력도 | \(C_p = (\text{USL} - \text{LSL})/(6\sigma)\). 공차 폭과 자연 분포의 무차원 비율이며, 평균의 위치를 무시합니다. 따라서 공정이 완벽하게 중심에 있을 때 달성할 수 있는 최고의 능력도입니다. |
| \(C_{pu}\), \(C_{pl}\) — 편측 지수 | \(C_{pu} = (\text{USL} - \mu)/(3\sigma)\)는 상한까지의 여유를 측정합니다. \(C_{pl} = (\mu - \text{LSL})/(3\sigma)\)는 하한까지의 여유를 측정합니다. 편측 규격의 경우 둘 중 하나를 단독으로 보고할 수 있습니다. |
| \(C_{pk}\) — 실제 능력도 | \(C_{pk} = \min(C_{pu}, C_{pl})\) — 더 가까운 한계에서의 능력도로, 분포와 중심화를 모두 반영합니다. 항상 \(C_{pk} \le C_p\)이며, \(\mu\)가 한계 밖에 있으면 음수입니다. |
| \(k\) — 중심화 편차 | 평균이 중점을 벗어난 반-공차의 무차원 분수입니다: \(k = \lvert m - \mu \rvert / \big((\text{USL} - \text{LSL})/2\big)\), 중점은 \(m\)입니다. 그러면 \(C_{pk} = (1-k)\,C_p\)이고, \(k = 0\)은 완벽하게 중심화되었음을 의미합니다. |
| \(P_p\), \(P_{pk}\) — 성능 지수 | \(C_p\)와 \(C_{pk}\)와 같은 공식이지만, 부분군 간 드리프트를 포함한 모든 데이터의 전체(장기) 표준 편차로 계산됩니다. 엄격한 SPC 의미의 \(C_p\)/\(C_{pk}\)는 \(\bar{R}/d_2\)와 같은 부분군 내 추정치를 사용합니다. 두 쌍 간의 간격은 공정 불안정성의 척도입니다. |
| 통계적 관리 | 공정이 공통원인(무작위) 변동만 보이는 상태입니다 — 시간 경과에 따라 안정적인 평균과 안정적인 분포를 가지므로 향후 출력을 예측할 수 있습니다. 능력도 지수가 아닌 관리도(예: X̄–R 또는 개별값–이동범위)로 확인됩니다. |
| DPMO / PPM | 백만 기회당 결함 수 / 백만 개당 부적합 부품: 규격 외의 추정 분율에 1,000,000을 곱한 값입니다. 정규, 중심화된 공정의 경우 정규 꼬리 면적에서 도출되므로, 개수가 아닌 모델 기반 추정치입니다. |
| 규격 한계 대 관리 한계 | 규격 한계(LSL, USL)는 설계팀, 고객 또는 표준에 의해 설정된 요구사항입니다 — 설계 의도에서 비롯되며, 데이터에서 나오지 않습니다. 관리 한계(LCL, UCL)는 공정 데이터에서 계산되며, 계획된 통계의 ±3 표준 오차에서 계산되고, 공정이 실제로 수행하는 작업을 설명합니다. 이들은 다른 질문에 답하므로 혼합하거나 교환하여 사용되어서는 안 됩니다: 관리 한계 외의 점은 불안정성을 신호하고, 규격 한계 외의 값은 부적합 부품입니다. |
자주 묻는 질문(FAQ)
Cpk는 얼마면 좋은 수치인가요? 일반적으로 1.33(±4\(\sigma\)에 해당)을 목표치로 삼습니다. 1.0 미만이면 공정이 규격을 안정적으로 만족하지 못한다는 뜻입니다.
Cp와 Cpk가 다른 이유는 무엇인가요? Cp는 공정의 중심 위치를 고려하지 않지만, Cpk는 공정 평균이 규격 폭의 중앙에서 멀어질수록 값이 낮아집니다. 따라서 Cpk는 항상 Cp보다 작거나 같습니다.
모든 값이 동일하면 어떻게 되나요? 이 경우 \(\sigma = 0\)이 되어 산포가 전혀 없으므로 수학적으로 능력 지수는 무한대가 됩니다. 이 도구는 0으로 나누는 오류를 방지하기 위해 이런 경우 0을 반환합니다.