प्यार के लिए ड्रेक समीकरण क्या है?
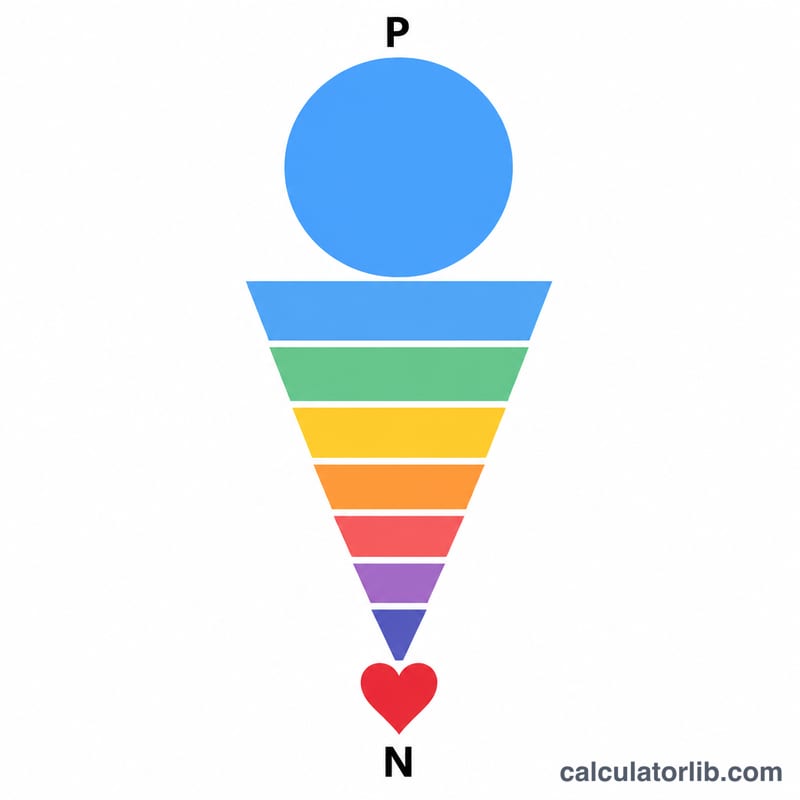
मूल ड्रेक समीकरण हमारी आकाशगंगा में संवाद करने वाली एलियन सभ्यताओं की संख्या का अनुमान लगाता है। यह मज़ेदार रूपांतरण उसी "चेन प्रोबेबिलिटी" यानी जुड़ी हुई संभावनाओं वाली सोच को उधार लेकर यह अनुमान लगाता है कि आपके आस-पास कितने संभावित रोमांटिक पार्टनर असल में हो सकते हैं। यह आपके शहर की आबादी से शुरू होकर कदम-दर-कदम छंटाई करता है, जब तक सिर्फ़ वही लोग बचते हैं जो वाकई आपके लिए "वो ख़ास" हो सकते हैं।
इसका इस्तेमाल कैसे करें
अपने शहर या डेटिंग पूल की आबादी डालें, फिर हर प्रतिशत का अनुमान लगाएं: कितने लोग आपकी पसंदीदा उम्र के दायरे में हैं, कितने आपके आस-पास रहते हैं, कितने आपको आकर्षक लगेंगे, कितने सिंगल और उपलब्ध हैं, और कितनों को आप में दिलचस्पी होने की संभावना है। कैलकुलेटर इन सबको आपस में गुणा करता है और संभावित पार्टनर्स की अनुमानित संख्या के साथ-साथ आपकी मोटी-मोटी "हर N में 1" डेटिंग संभावना बताता है।
फ़ॉर्मूला समझें
$$N = P \times f_{\text{age}} \times f_{\text{loc}} \times f_{\text{att}} \times f_{\text{avail}} \times f_{\text{like}}$$ गुणा करने से पहले हर प्रतिशत को भिन्न में बदला जाता है (100 से भाग देकर)। चूँकि ये भिन्न आपस में गुणा होकर तेज़ी से घटते हैं, इसलिए छोटे-छोटे फ़िल्टर भी पूल को नाटकीय रूप से सिकोड़ देते हैं — और ठीक यही वजह है कि एक बढ़िया मैच ढूँढना इतना दुर्लभ लगता है।
हल किया हुआ उदाहरण
मान लीजिए आपके शहर में 1,000,000 लोग हैं। 25% आपकी उम्र के दायरे में हैं (0.25), 50% आपके आस-पास रहते हैं (0.50), 18% आपको आकर्षक लगते हैं (0.18), 50% सिंगल हैं (0.50), और 5% को आप में दिलचस्पी हो सकती है (0.05)। $$N = 1{,}000{,}000 \times 0.25 \times 0.50 \times 0.18 \times 0.50 \times 0.05 = \mathbf{562.5}$$ संभावित पार्टनर — यानी लगभग हर 1,778 लोगों में 1।
अक्सर पूछे जाने वाले सवाल
क्या यह वैज्ञानिक रूप से सटीक है? नहीं — यह खगोलशास्त्री फ़्रैंक ड्रेक के समीकरण से प्रेरित एक मज़ेदार विचार-प्रयोग है, कोई प्रमाणित डेटिंग मॉडल नहीं।
मेरी संख्या इतनी छोटी क्यों हो जाती है? कई प्रतिशतों को आपस में गुणा करने पर नतीजा बहुत तेज़ी से घटता है, इसलिए हर अतिरिक्त फ़िल्टर परिणाम को काफ़ी कम कर देता है।
क्या नतीजा एक भिन्न (दशमलव) हो सकता है? हाँ। 1 से कम का मान बस यह दिखाता है कि पूल इतना छन गया है कि आँकड़ों के हिसाब से एक भी आदर्श मैच की उम्मीद नहीं रहती — ऐसे में अपने मापदंड थोड़े और खुले रखें।