Qu'est-ce qu'un calculateur de distribution de fréquences ?
Un calculateur de distribution de fréquences transforme des données brutes en un tableau récapitulatif clair, qui indique combien de fois chaque valeur — ou chaque plage de valeurs — apparaît dans un jeu de données. Plutôt que de parcourir une longue liste de chiffres, vous obtenez une vision immédiate : là où vos données se concentrent, là où se trouvent les écarts et à quel point les valeurs sont dispersées. Cet outil calcule également les principales statistiques de synthèse — la moyenne, la médiane et l'écart-type — et vous laisse personnaliser la taille des classes pour regrouper des données continues en intervalles pertinents.
Comment utiliser le calculateur
- Saisissez vos valeurs, séparées par des virgules ou des espaces (par exemple : 12, 15, 15, 18, 22, 22, 22, 30).
- Choisissez le mode de regroupement : par valeurs individuelles ou par intervalles de classes (classes).
- Définissez une taille de classe ou un nombre de classes si vous regroupez des plages de données.
- Cliquez sur « Calculer » pour générer le tableau de fréquences, les fréquences relatives et cumulées, ainsi que les statistiques de synthèse.
Les formules expliquées
Un tableau de fréquences indique chaque valeur ou classe accompagnée de son nombre d'occurrences. Deux mesures complémentaires apportent du contexte :
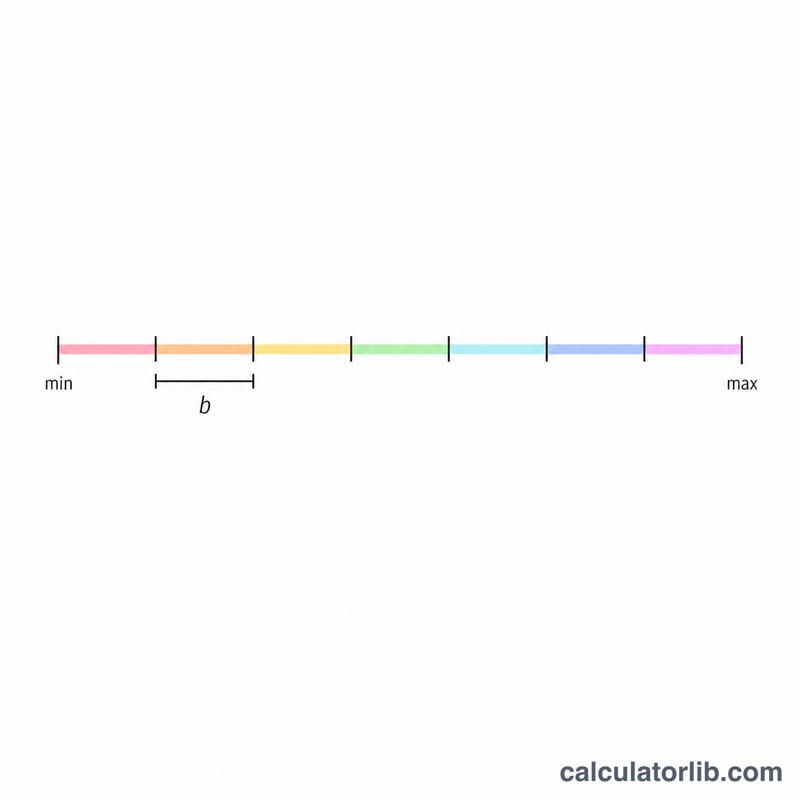
$$k = \left\lceil \frac{\max - \min}{h} \right\rceil, \qquad f_i = \#\{\, x : L_i \le x < L_i + h \,\}$$
$$\text{where}\quad \left\{ \begin{aligned} x &= \text{Data values} \\ h &= \text{Bin Size} \;\text{or}\; \left\lceil \sqrt{n} \right\rceil \\ L_i &= \min + i\,h \end{aligned} \right.$$
- Fréquence relative = fréquence ÷ effectif total. Elle exprime chaque fréquence sous forme de proportion ou de pourcentage.
- Fréquence cumulée = total progressif des fréquences jusqu'à une classe donnée incluse.
Les statistiques de synthèse reposent sur des formules classiques : la moyenne est la somme de toutes les valeurs divisée par l'effectif ; la médiane est la valeur centrale une fois les données triées ; et l'écart-type mesure l'éloignement habituel des valeurs par rapport à la moyenne, calculé comme la racine carrée de la moyenne des écarts au carré.
Exemple concret
Supposons que vous releviez des notes : 70, 75, 75, 80, 80, 80, 85, 90. La valeur 80 apparaît trois fois : sa fréquence est donc de 3 et sa fréquence relative de \(3 \div 8 = 0{,}375\) (37,5 %). La moyenne vaut \((70+75+75+80+80+80+85+90) \div 8 = 79{,}4\). Avec 8 valeurs, la médiane correspond à la moyenne des 4ᵉ et 5ᵉ valeurs triées : \((80+80) \div 2 = 80\). L'écart-type s'établit à environ 6,0, ce qui montre que les notes restent assez proches de la moyenne.
Comment construire un tableau de fréquences à la main
- Trouver le minimum et le maximum de l'ensemble de données.
- Calculer l'étendue : \(\text{étendue} = \max - \min\).
- Choisir le nombre de classes \(k\). Deux règles courantes sont la règle de Sturges, \(k = 1 + \log_2(n)\), et la règle de la racine carrée, \(k = \lceil \sqrt{n} \rceil\). Arrondir \(k\) à l'entier supérieur. Ces deux règles ne sont que des points de départ.
- Fixer la largeur de classe : \(h = \lceil \text{étendue} / k \rceil\). Arrondir par excès (souvent à un nombre entier pratique) garantit que les classes couvrent toute l'étendue.
- Définir les bornes de classes sans chevauchement à partir du minimum : \(L_i = \min + i\,h\). Chaque classe est \([L_i, L_i + h)\), donc la borne inférieure est incluse et la borne supérieure est exclue. Une valeur égale à la borne supérieure d'une classe va dans la classe suivante.
- Compter chaque valeur dans exactement une classe pour obtenir la fréquence \(f_i\).
- Calculer la fréquence relative \(f_i / n\) et la fréquence cumulée (total cumulé de \(f_i\)).
- Vérifier : les fréquences doivent totaliser \(n\), les fréquences relatives doivent totaliser 1 (à l'arrondi près), et la dernière fréquence cumulée doit être égale à \(n\).
Court exemple avec classes
Données (n = 12) : 4, 7, 8, 9, 11, 12, 12, 14, 15, 18, 19, 22.
Minimum = 4, maximum = 22, donc l'étendue est \(22 - 4 = 18\). La règle de Sturges donne \(k = 1 + \log_2(12) \approx 4{,}58\), arrondi à l'entier supérieur soit 5 classes. La largeur est \(18 / 5 = 3{,}6\), arrondie par excès à \(h = 4\).
| Classe | Valeurs | Fréquence | Relative | Cumulée |
|---|---|---|---|---|
| [4, 8) | 4, 7 | 2 | 0,167 | 2 |
| [8, 12) | 8, 9, 11 | 3 | 0,250 | 5 |
| [12, 16) | 12, 12, 14, 15 | 4 | 0,333 | 9 |
| [16, 20) | 18, 19 | 2 | 0,167 | 11 |
| [20, 24) | 22 | 1 | 0,083 | 12 |
Vérification : \(2 + 3 + 4 + 2 + 1 = 12 = n\), et la dernière fréquence cumulée est 12.
Termes clés des distributions de fréquences
- Fréquence (\(f\)) : le nombre d'observations qui tombent dans une catégorie ou une classe.
- Fréquence relative : \(f / n\), la proportion de toutes les observations dans la classe. Multiplier par 100 pour obtenir un pourcentage.
- Fréquence cumulée : le total cumulé des fréquences jusqu'à une classe donnée incluse.
- Intervalle de classe (classe) : un domaine de valeurs qui regroupe les données, par exemple [8, 12).
- Largeur de classe (\(h\)) : la distance entre la borne inférieure d'une classe et la borne inférieure de la classe suivante.
- Bornes de classe et frontières : les bornes sont les extrémités énoncées d'une classe (pour des données entières, 10–19). Les frontières sont les points situés à mi-chemin entre classes adjacentes (9,5 et 19,5), afin qu'il n'y ait pas d'écarts. Avec la convention semi-ouverte [L, L + h), la borne inférieure est incluse et la borne supérieure est exclue.
- Centre de classe : \((\text{inférieure} + \text{supérieure}) / 2\). Il sert à représenter toutes les valeurs de la classe lors de l'estimation de statistiques à partir de données groupées.
- Mode : la valeur la plus fréquente. Pour des données groupées, la classe modale est la classe ayant la fréquence la plus élevée.
- Étendue : maximum moins minimum.
- Écart type : une mesure de la distance typique à la moyenne. La version pour une population est \(\sigma = \sqrt{\frac{\sum (x_i - \mu)^2}{N}}\), utilisée lorsque les données constituent toute la population. La version pour un échantillon est \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n - 1}}\), utilisée lorsque les données sont un échantillon tiré d'une population plus grande. Diviser par \(n - 1\) corrige la tendance d'un échantillon à sous-estimer la dispersion.
Interpréter votre distribution de fréquences
Lire la forme
- Symétrique : les deux côtés de l'histogramme se reflètent autour du centre. La moyenne et la médiane sont proches.
- Asymétrique à droite (asymétrie positive) : une longue queue s'étend vers les grandes valeurs, et la plupart des observations se situent du côté des petites valeurs.
- Asymétrique à gauche (asymétrie négative) : une longue queue s'étend vers les petites valeurs, et la plupart des observations se situent du côté des grandes valeurs.
- Bimodale : deux pics distincts, ce qui indique souvent deux sous-groupes mélangés dans un même ensemble de données.
- Uniforme : les classes ont des fréquences à peu près égales, sans pic clair.
Moyenne et médiane
Dans une distribution asymétrique à droite, la moyenne est généralement supérieure à la médiane. Dans une distribution asymétrique à gauche, la moyenne est généralement inférieure à la médiane. Lorsque les deux sont à peu près égales, la distribution est généralement à peu près symétrique. Il s'agit d'une tendance courante, et non d'une règle stricte ; elle peut ne pas se vérifier pour des données multimodales ou irrégulières.
Effet des valeurs aberrantes
La moyenne et l'écart type sont sensibles aux valeurs extrêmes, car chacun est calculé à partir de toutes les observations et l'écart type élève les écarts au carré. La médiane et le mode sont beaucoup moins affectés. Une valeur très grande peut attirer nettement la moyenne vers elle et élargir l'écart type, tout en laissant la médiane presque inchangée.
Écart type et dispersion
Un écart type plus grand signifie que les valeurs sont plus dispersées autour de la moyenne. Pour des données à peu près normales (en forme de cloche), environ 68 % des valeurs se situent à moins de 1 écart type de la moyenne, environ 95 % à moins de 2 écarts types et environ 99,7 % à moins de 3 écarts types. Ces pourcentages ne sont pas valables en général pour des données asymétriques ou à queues lourdes.
La largeur de classe modifie la forme apparente
Des classes très étroites produisent un histogramme irrégulier, avec de nombreux petits pics qui ne sont peut-être que du bruit. Des classes très larges lissent tellement les données que de véritables caractéristiques, comme un second pic ou une asymétrie, peuvent disparaître. Un même ensemble de données peut sembler unimodal avec une largeur de classe et bimodal avec une autre ; il est donc utile de tester plusieurs largeurs avant de tirer des conclusions sur la forme. Des règles comme celle de Sturges ou de la racine carrée fournissent un point de départ raisonnable, et non une réponse unique et correcte.
Questions fréquentes
Quel est le nombre de classes idéal ? Une règle empirique courante consiste à prendre la racine carrée du nombre de données, mais vous pouvez ajuster les classes pour faire ressortir le plus clairement possible la tendance. Trop peu de classes masquent les détails ; trop nombreuses, elles créent du bruit.
Quelle est la différence entre fréquence et fréquence relative ? La fréquence est le nombre brut d'occurrences, tandis que la fréquence relative est ce nombre exprimé en fraction ou en pourcentage du total — ce qui facilite la comparaison entre jeux de données de tailles différentes.
Puis-je l'utiliser pour des données continues regroupées ? Oui. Définissez une largeur de classe pour regrouper les valeurs continues en intervalles tels que 0–9, 10–19, etc., puis lisez la fréquence de chaque plage.