¿Qué es una calculadora de distribución de frecuencias?
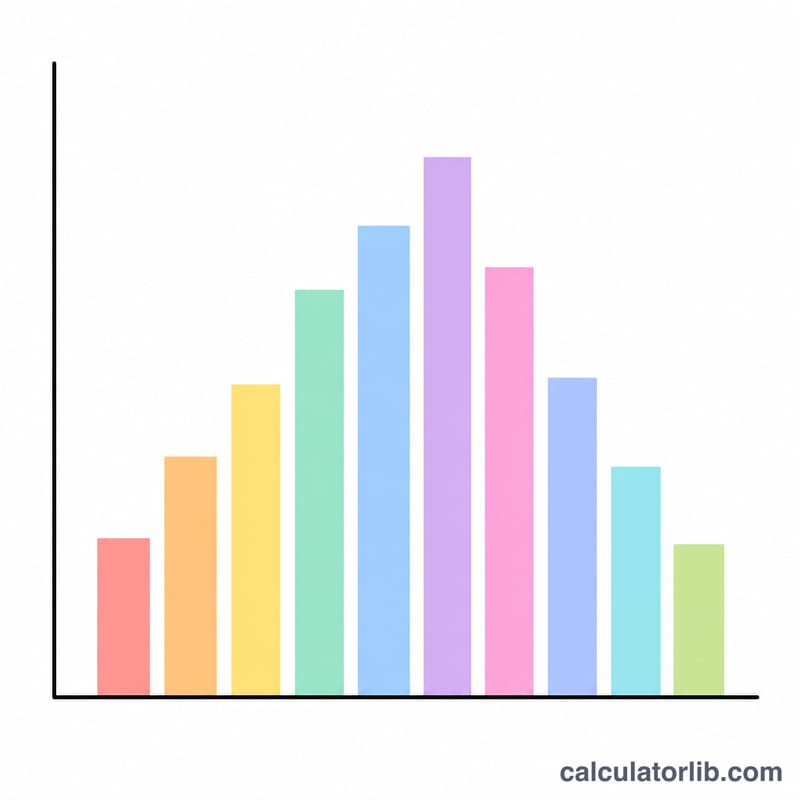
Una calculadora de distribución de frecuencias organiza los datos en bruto en una tabla clara y resumida que muestra cuántas veces aparece cada valor o rango de valores dentro de un conjunto de datos. En lugar de revisar una lista interminable de números, obtienes una visión inmediata de dónde se concentran tus datos, dónde hay huecos y qué tan dispersos están los valores. Esta herramienta también calcula los estadísticos clave —la media, la mediana y la desviación estándar— y te permite ajustar el tamaño de los intervalos para agrupar datos continuos en rangos con sentido.
Cómo usar la calculadora
- Introduce tus valores separados por comas o espacios (por ejemplo: 12, 15, 15, 18, 22, 22, 22, 30).
- Elige cómo quieres agrupar los datos: por valores individuales o por intervalos de clase (bins).
- Define el tamaño del intervalo o el número de intervalos si vas a agrupar rangos de datos.
- Pulsa calcular para generar la tabla de frecuencias, las frecuencias relativas y acumuladas, y los estadísticos resumen.
Las fórmulas explicadas
Una tabla de frecuencias muestra cada valor o clase junto al número de veces que aparece. Dos medidas relacionadas añaden contexto:
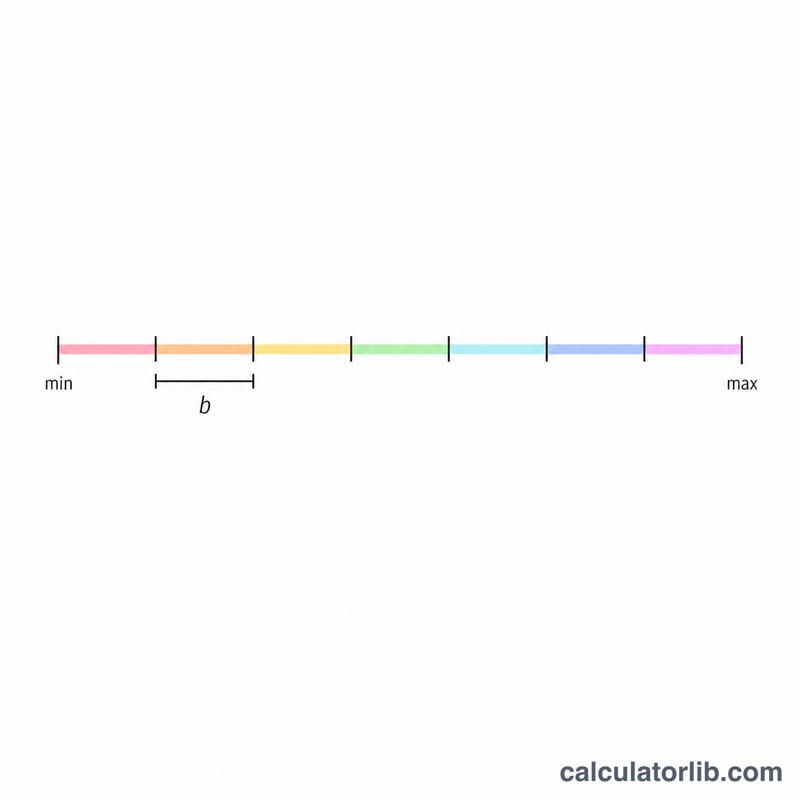
$$k = \left\lceil \frac{\max - \min}{h} \right\rceil, \qquad f_i = \#\{\, x : L_i \le x < L_i + h \,\}$$$$\text{where}\quad \left\{ \begin{aligned} x &= \text{Data values} \\ h &= \text{Bin Size} \;\text{or}\; \left\lceil \sqrt{n} \right\rceil \\ L_i &= \min + i\,h \end{aligned} \right.$$- Frecuencia relativa = frecuencia ÷ total de datos. Expresa cada frecuencia como una proporción o porcentaje.
- Frecuencia acumulada = suma progresiva de las frecuencias hasta una clase determinada, incluida esta.
Los estadísticos resumen utilizan las fórmulas habituales: la media es la suma de todos los valores dividida entre el número de datos; la mediana es el valor central una vez ordenados los datos; y la desviación estándar mide cuánto se alejan normalmente los valores respecto a la media, y se obtiene como la raíz cuadrada del promedio de las desviaciones al cuadrado.
Ejemplo resuelto
Imagina que recoges estas calificaciones de un examen: 70, 75, 75, 80, 80, 80, 85, 90. El valor 80 aparece tres veces, por lo que su frecuencia es 3 y su frecuencia relativa es \(3 \div 8 = 0{,}375\) (37,5 %). La media es \((70+75+75+80+80+80+85+90) \div 8 = 79{,}4\). Como hay 8 valores, la mediana es el promedio del 4.º y el 5.º valores ordenados: \((80+80) \div 2 = 80\). La desviación estándar resulta ser de unos 6,0, lo que indica que las notas se mantienen bastante cerca de la media.
Cómo construir una tabla de frecuencias a mano
- Encuentra el mínimo y el máximo del conjunto de datos.
- Calcula el rango: \(\text{rango} = \max - \min\).
- Elige el número de intervalos \(k\). Dos reglas comunes son la regla de Sturges, \(k = 1 + \log_2(n)\), y la regla de la raíz cuadrada, \(k = \lceil \sqrt{n} \rceil\). Redondea \(k\) hacia arriba a un número entero. Ambas son solo puntos de partida.
- Define el ancho del intervalo: \(h = \lceil \text{rango} / k \rceil\). Redondear hacia arriba (a menudo a un número entero conveniente) garantiza que los intervalos cubran todo el rango.
- Define los límites de clase sin solapamiento comenzando en el mínimo: \(L_i = \min + i\,h\). Cada intervalo es \([L_i, L_i + h)\), por lo que el límite inferior es inclusivo y el límite superior es exclusivo. Un valor igual al límite superior de un intervalo pasa al siguiente.
- Cuenta cada valor en exactamente un intervalo para obtener la frecuencia \(f_i\).
- Calcula la frecuencia relativa \(f_i / n\) y la frecuencia acumulada (total acumulado de \(f_i\)).
- Verifica: las frecuencias deben sumar \(n\), las frecuencias relativas deben sumar 1 (admitiendo redondeos), y la última frecuencia acumulada debe ser igual a \(n\).
Ejemplo breve agrupado
Datos (n = 12): 4, 7, 8, 9, 11, 12, 12, 14, 15, 18, 19, 22.
Mín = 4, máx = 22, por lo que el rango es \(22 - 4 = 18\). La regla de Sturges da \(k = 1 + \log_2(12) \approx 4.58\), que se redondea hacia arriba a 5 intervalos. El ancho es \(18 / 5 = 3.6\), redondeado hacia arriba a \(h = 4\).
| Intervalo | Valores | Frecuencia | Relativa | Acumulada |
|---|---|---|---|---|
| [4, 8) | 4, 7 | 2 | 0.167 | 2 |
| [8, 12) | 8, 9, 11 | 3 | 0.250 | 5 |
| [12, 16) | 12, 12, 14, 15 | 4 | 0.333 | 9 |
| [16, 20) | 18, 19 | 2 | 0.167 | 11 |
| [20, 24) | 22 | 1 | 0.083 | 12 |
Verificación: \(2 + 3 + 4 + 2 + 1 = 12 = n\), y la última frecuencia acumulada es 12.
Términos clave en distribuciones de frecuencia
- Frecuencia (\(f\)): el número de observaciones que caen en una categoría o intervalo.
- Frecuencia relativa: \(f / n\), la proporción de todas las observaciones en el intervalo. Multiplica por 100 para obtener un porcentaje.
- Frecuencia acumulada: el total acumulado de las frecuencias hasta un intervalo dado, incluido este.
- Intervalo de clase (bin): un rango de valores que agrupa los datos, como [8, 12).
- Ancho de clase (\(h\)): la distancia desde el límite inferior de un intervalo hasta el límite inferior del siguiente.
- Límites de clase frente a fronteras: los límites son los extremos indicados de un intervalo (para datos de números enteros, 10–19). Las fronteras son los puntos medios entre intervalos adyacentes (9.5 y 19.5), de modo que no hay huecos. Con la convención semiabierta [L, L + h), el límite inferior es inclusivo y el superior es exclusivo.
- Punto medio de clase: \((\text{inferior} + \text{superior}) / 2\). Se usa para representar todos los valores del intervalo al estimar estadísticos a partir de datos agrupados.
- Moda: el valor más frecuente. En datos agrupados, la clase modal es el intervalo con la frecuencia más alta.
- Rango: máximo menos mínimo.
- Desviación estándar: una medida de la distancia típica respecto a la media. La versión poblacional es \(\sigma = \sqrt{\frac{\sum (x_i - \mu)^2}{N}}\), que se usa cuando los datos son toda la población. La versión muestral es \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n - 1}}\), que se usa cuando los datos son una muestra extraída de una población más grande. Dividir entre \(n - 1\) corrige la tendencia de una muestra a subestimar la dispersión.
Interpretación de tu distribución de frecuencias
Lectura de la forma
- Simétrica: los dos lados del histograma son imágenes especulares uno del otro alrededor del centro. La media y la mediana están cerca.
- Asimétrica a la derecha (sesgo positivo): una cola larga se extiende hacia valores mayores, y la mayoría de las observaciones se sitúan en el lado bajo.
- Asimétrica a la izquierda (sesgo negativo): una cola larga se extiende hacia valores menores, y la mayoría de las observaciones se sitúan en el lado alto.
- Bimodal: dos picos distintos, lo que a menudo indica dos subgrupos mezclados en un mismo conjunto de datos.
- Uniforme: los intervalos tienen frecuencias aproximadamente iguales, sin un pico claro.
Media frente a mediana
En una distribución asimétrica a la derecha, la media es normalmente mayor que la mediana. En una asimétrica a la izquierda, la media es normalmente menor que la mediana. Cuando ambas son aproximadamente iguales, la distribución suele ser más o menos simétrica. Esta es una tendencia habitual, no una regla estricta, y puede fallar en datos multimodales o irregulares.
Efecto de los valores atípicos
La media y la desviación estándar son sensibles a los valores extremos, porque la media se calcula con todas las observaciones y la desviación estándar eleva al cuadrado las desviaciones. La mediana y la moda se ven mucho menos afectadas. Un valor muy grande puede atraer notablemente la media hacia él y ampliar la desviación estándar, mientras que la mediana casi no cambia.
Desviación estándar y dispersión
Una desviación estándar mayor significa que los valores están más dispersos alrededor de la media. Para datos aproximadamente normales (con forma de campana), alrededor del 68% de los valores se encuentran a menos de 1 desviación estándar de la media, alrededor del 95% a menos de 2 y alrededor del 99.7% a menos de 3. Estos porcentajes no se cumplen en general para datos asimétricos o de colas pesadas.
El ancho del intervalo cambia la forma aparente
Los intervalos muy estrechos producen un histograma irregular con muchos picos pequeños que pueden ser simple ruido. Los intervalos muy anchos suavizan tanto los datos que rasgos reales, como un segundo pico o una asimetría, pueden desaparecer. El mismo conjunto de datos puede parecer unimodal con un ancho de intervalo y bimodal con otro, por lo que conviene probar varios anchos antes de sacar conclusiones sobre la forma. Reglas como la de Sturges o la de la raíz cuadrada ofrecen un punto de partida razonable, no una única respuesta correcta.
Preguntas frecuentes
¿Cuál es el número ideal de intervalos? Una regla práctica habitual es usar la raíz cuadrada del número de datos, pero puedes ajustar los intervalos para que el patrón se vea con la máxima claridad. Con muy pocos intervalos se pierde detalle; con demasiados, aparece ruido.
¿En qué se diferencian la frecuencia y la frecuencia relativa? La frecuencia es el recuento directo de apariciones, mientras que la frecuencia relativa es ese recuento expresado como fracción o porcentaje del total, lo que facilita comparar conjuntos de datos de tamaños distintos.
¿Puedo usarla con datos continuos agrupados? Sí. Define un ancho de intervalo para agrupar los valores continuos en rangos como 0–9, 10–19, y así sucesivamente, y luego consulta la frecuencia de cada rango.