度数分布計算ツールとは?
度数分布計算ツールは、バラバラな生データを整理し、それぞれの値や範囲がどのくらいの頻度で現れるかを一目で分かる表にまとめてくれるツールです。長い数字の羅列を一つひとつ確認する必要はなく、データがどこに集中しているのか、どこに空白があるのか、ばらつきはどの程度かをひと目で把握できます。さらに、平均・中央値・標準偏差といった主要な統計量も同時に算出。階級幅(ビン幅)を自由に設定できるので、連続データを意味のある区間にまとめて分析できます。
使い方
- データの値を入力します。カンマまたはスペースで区切ってください(例:12, 15, 15, 18, 22, 22, 22, 30)。
- データのまとめ方を選びます。値ごとにまとめるか、階級(区間)ごとにまとめるかを指定します。
- 範囲でまとめる場合は、階級幅または階級の数を設定します。
- 「計算する」をクリックすると、度数分布表・相対度数・累積度数、そして主要な統計量が表示されます。
計算式の解説
度数分布表は、それぞれの値や階級が何回現れたかを一覧にしたものです。これに加えて、関連する2つの指標があります。
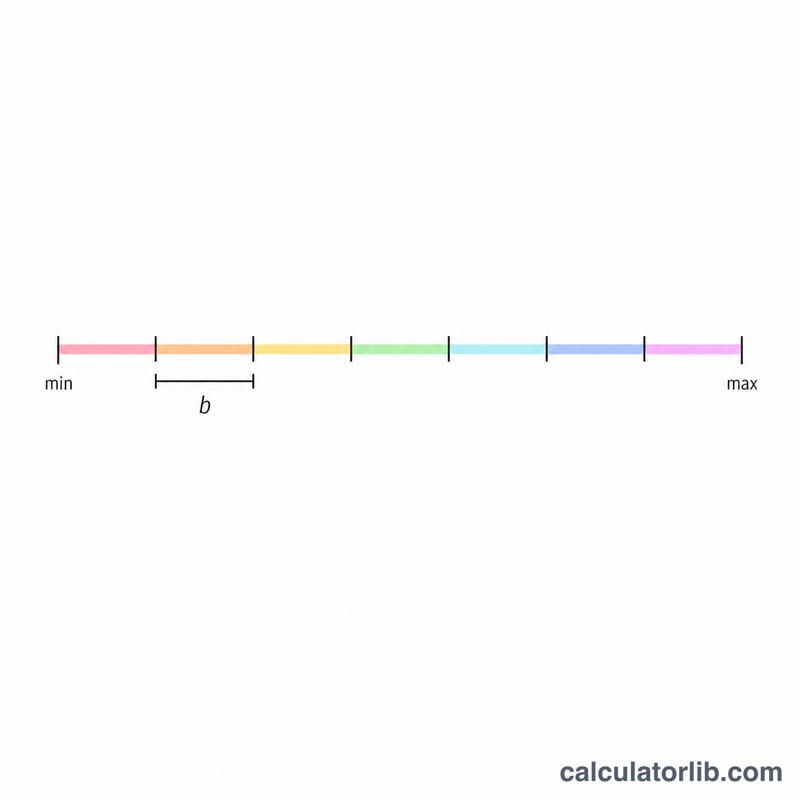
$$k = \left\lceil \frac{\max - \min}{h} \right\rceil, \qquad f_i = \#\{\, x : L_i \le x < L_i + h \,\}$$ここで \(x\) はデータの値、\(h\) は階級幅または \(\left\lceil \sqrt{n} \right\rceil\)、\(L_i = \min + i\,h\) です。
- 相対度数=度数 ÷ 合計件数。各度数を全体に対する割合(%)で表します。
- 累積度数=その階級までの度数を順に足し合わせた累計です。
統計量には次の標準的な計算式を用います。平均はすべての値の合計を件数で割った値、中央値はデータを並べ替えたときの真ん中の値、標準偏差は値が平均からどの程度離れているかを表す指標で、偏差の二乗の平均値の平方根として求めます。
具体例で理解する
たとえばテストの点数として 70, 75, 75, 80, 80, 80, 85, 90 を集めたとします。値「80」は3回現れているので、度数は3、相対度数は \(3 \div 8 = 0.375\)(37.5%)です。平均は \((70 + 75 + 75 + 80 + 80 + 80 + 85 + 90) \div 8 = 79.4\)。値が8個あるので、中央値は並べ替えた4番目と5番目の平均、すなわち \((80 + 80) \div 2 = 80\) となります。標準偏差は約6.0となり、点数が平均からそれほど大きく離れていないことが分かります。
度数分布表を手作業で作る方法
- データの最小値と最大値を求める。
- 範囲を計算する: \(\text{範囲} = \max - \min\)。
- 階級の数 \(k\) を選ぶ。 よく使われる方法は2つあります。スタージェスの公式 \(k = 1 + \log_2(n)\) と、平方根の方法 \(k = \lceil \sqrt{n} \rceil\) です。\(k\) は整数に切り上げます。どちらも出発点にすぎません。
- 階級の幅を設定する: \(h = \lceil \text{範囲} / k \rceil\)。切り上げ(多くの場合、区切りのよい整数に)を行うと、階級が範囲全体を覆うことが保証されます。
- 最小値から始まる重複しない階級の境界を定義する: \(L_i = \min + i\,h\)。各階級は \([L_i, L_i + h)\) となり、下限は含み、上限は含みません。ある階級の上限に等しい値は、次の階級に入ります。
- 各値を必ずひとつの階級に集計(集計表に記入) して度数 \(f_i\) を求める。
- 相対度数 \(f_i / n\) と累積度数(\(f_i\) の累計)を計算する。
- 確認: 度数の合計は \(n\) に、相対度数の合計は(丸め誤差を考慮して)1 に、最後の累積度数は \(n\) に等しくなければなりません。
簡単な階級別の例
データ(n = 12):4, 7, 8, 9, 11, 12, 12, 14, 15, 18, 19, 22。
最小値 = 4、最大値 = 22 なので、範囲は \(22 - 4 = 18\) です。スタージェスの公式では \(k = 1 + \log_2(12) \approx 4.58\) となり、切り上げて5階級になります。幅は \(18 / 5 = 3.6\) で、切り上げて \(h = 4\) です。
| 階級 | 値 | 度数 | 相対度数 | 累積度数 |
|---|---|---|---|---|
| [4, 8) | 4, 7 | 2 | 0.167 | 2 |
| [8, 12) | 8, 9, 11 | 3 | 0.250 | 5 |
| [12, 16) | 12, 12, 14, 15 | 4 | 0.333 | 9 |
| [16, 20) | 18, 19 | 2 | 0.167 | 11 |
| [20, 24) | 22 | 1 | 0.083 | 12 |
確認:\(2 + 3 + 4 + 2 + 1 = 12 = n\)、最後の累積度数は12です。
度数分布の主な用語
- 度数(\(f\)): あるカテゴリーや階級に入る観測値の数。
- 相対度数: \(f / n\)。階級に入る観測値が全体に占める割合。100を掛けるとパーセントになります。
- 累積度数: ある階級までの(その階級を含む)度数の累計。
- 階級(区間): データをまとめる値の範囲。例えば [8, 12) など。
- 階級幅(\(h\)): ある階級の下限から次の階級の下限までの距離。
- 階級の限界と境界: 限界は階級の明示された端点です(整数データの場合、10〜19)。境界は隣接する階級の中間点(9.5 と 19.5)であり、隙間がないようにします。半開区間 [L, L + h) の規則では、下限は含み、上限は含みません。
- 階級値(階級の中央値): \((\text{下限} + \text{上限}) / 2\)。階級別データから統計量を推定する際に、階級内のすべての値を代表させるために使います。
- 最頻値: 最も頻繁に現れる値。階級別データでは、最頻階級とは度数が最も高い階級のことです。
- 範囲: 最大値から最小値を引いた値。
- 標準偏差: 平均からの典型的な距離を表す指標。母集団版は \(\sigma = \sqrt{\frac{\sum (x_i - \mu)^2}{N}}\) で、データが母集団全体の場合に用います。標本版は \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n - 1}}\) で、データがより大きな母集団から抽出された標本の場合に用います。\(n - 1\) で割るのは、標本が散らばりを過小評価しがちであることを補正するためです。
度数分布の解釈
分布の形を読む
- 対称: ヒストグラムの左右が中心を挟んで互いに鏡像のようになっています。平均と中央値は近い値です。
- 右に裾が長い(正の歪み): 長い裾が大きい値の方へ伸び、大部分の観測値は小さい側に集まっています。
- 左に裾が長い(負の歪み): 長い裾が小さい値の方へ伸び、大部分の観測値は大きい側に集まっています。
- 双峰性: 2つの明確なピークがあり、多くの場合、1つのデータセットに2つの下位集団が混在していることを示します。
- 一様: 各階級の度数がほぼ等しく、はっきりしたピークがありません。
平均と中央値の比較
右に裾が長い分布では、平均は通常、中央値より大きくなります。左に裾が長い分布では、平均は通常、中央値より小さくなります。両者がほぼ等しい場合、分布はたいてい概ね対称です。これは一般的な傾向であり厳密な規則ではなく、多峰性や不規則なデータでは当てはまらないことがあります。
外れ値の影響
平均と標準偏差は極端な値に敏感です。平均はすべての観測値から計算され、標準偏差は偏差を二乗するためです。中央値と最頻値の影響ははるかに小さくなります。非常に大きな値が1つあると、平均がその値の方へ大きく引き寄せられ、標準偏差も広がりますが、中央値はほとんど変わりません。
標準偏差と散らばり
標準偏差が大きいほど、値は平均の周りにより散らばっています。ほぼ正規分布(釣鐘型)のデータでは、値の約68%が平均から±1標準偏差以内に、約95%が±2標準偏差以内に、約99.7%が±3標準偏差以内に入ります。これらの割合は、歪んだデータや裾の重いデータには一般には当てはまりません。
階級幅が見かけの形を変える
非常に狭い階級幅では、ただの雑音かもしれない小さな多数のピークを持つギザギザしたヒストグラムになります。非常に広い階級幅ではデータが過度に平滑化され、2つ目のピークや歪みといった実際の特徴が消えてしまうことがあります。同じデータセットでも、ある階級幅では単峰に、別の階級幅では双峰に見えることがあるため、分布の形について結論を出す前にいくつかの階級幅を確認する価値があります。スタージェスの公式や平方根の方法は、唯一の正しい答えではなく、妥当な出発点を与えるものです。
よくある質問
階級(ビン)の数はいくつが最適ですか? よく使われる目安は「データ数の平方根」ですが、パターンが最も分かりやすくなるように調整してかまいません。階級が少なすぎると細かい特徴が見えにくくなり、多すぎると不要なばらつき(ノイズ)が目立ってしまいます。
度数と相対度数の違いは? 度数は出現回数そのもの(生の件数)、相対度数はそれを全体に対する割合や%で表したものです。相対度数を使うと、データ数の異なるデータセット同士でも比較しやすくなります。
連続データを区間にまとめて使えますか? はい。階級幅を設定すれば、連続値を 0〜9、10〜19 といった区間にまとめ、各範囲ごとの度数を読み取ることができます。