Что такое калькулятор частотного распределения?
Калькулятор частотного распределения превращает «сырой» набор данных в наглядную сводную таблицу, которая показывает, как часто встречается каждое значение или диапазон значений. Вместо того чтобы вглядываться в длинный список чисел, вы сразу видите, где данные сгруппированы, где есть пробелы и насколько широко разбросаны значения. Помимо самой таблицы калькулятор считает ключевые статистические показатели — среднее, медиану и стандартное отклонение, — а также позволяет задать размер интервала (бина), чтобы разбить непрерывные данные на удобные группы.
Как пользоваться калькулятором
- Введите значения через запятую или пробел (например: 12, 15, 15, 18, 22, 22, 22, 30).
- Выберите способ группировки — по отдельным значениям или по интервалам (бинам).
- Укажите размер интервала или число интервалов, если группируете данные по диапазонам.
- Нажмите «Рассчитать», чтобы получить таблицу частот, относительные и накопленные частоты, а также сводную статистику.
Разбор формул
Таблица частот перечисляет каждое значение или класс рядом с тем, сколько раз оно встречается. Дополнительный контекст дают два связанных показателя:
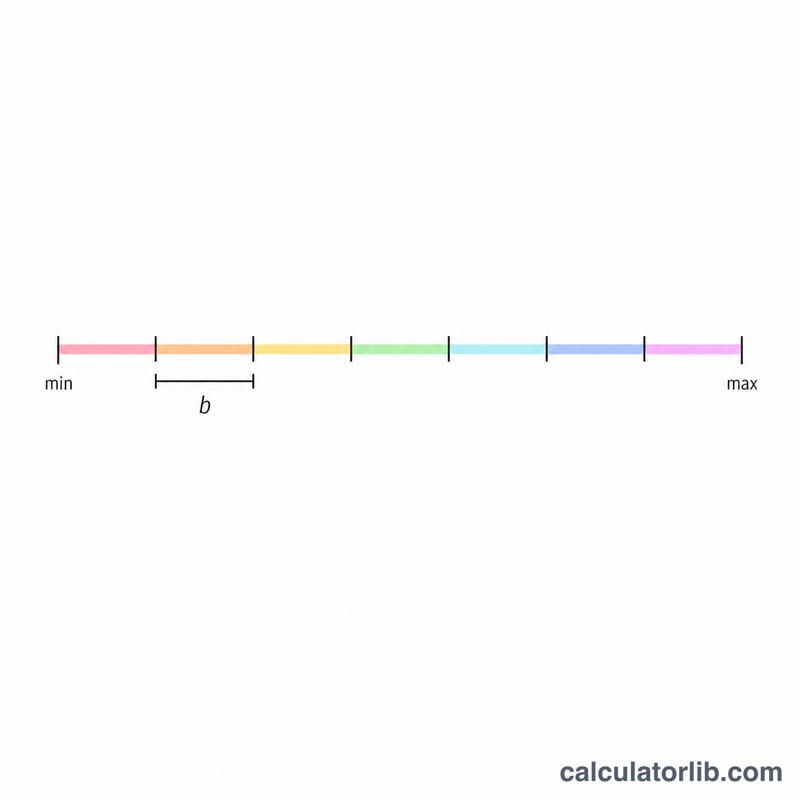
$$k = \left\lceil \frac{\max - \min}{h} \right\rceil, \qquad f_i = \#\{\, x : L_i \le x < L_i + h \,\}$$
$$\text{where}\quad \left\{ \begin{aligned} x &= \text{Data values} \\ h &= \text{Bin Size} \;\text{or}\; \left\lceil \sqrt{n} \right\rceil \\ L_i &= \min + i\,h \end{aligned} \right.$$
- Относительная частота = частота ÷ общее число наблюдений. Она показывает каждую частоту как долю или процент.
- Накопленная частота = нарастающий итог частот вплоть до данного класса включительно.
Сводная статистика рассчитывается по стандартным формулам: среднее — это сумма всех значений, делённая на их количество; медиана — это среднее значение в отсортированном ряду; а стандартное отклонение показывает, насколько в среднем значения отклоняются от среднего, и вычисляется как квадратный корень из среднего квадрата отклонений.
Разбор на примере
Допустим, вы собрали баллы за тест: 70, 75, 75, 80, 80, 80, 85, 90. Значение 80 встречается три раза, поэтому его частота равна 3, а относительная частота — \(3 \div 8 = 0{,}375\) (37,5 %). Среднее: \((70+75+75+80+80+80+85+90) \div 8 = 79{,}4\). При 8 значениях медиана — это среднее 4-го и 5-го значений в отсортированном ряду: \((80+80) \div 2 = 80\). Стандартное отклонение получается около 6,0, что говорит о том, что баллы держатся довольно близко к среднему.
Как построить частотную таблицу вручную
- Найдите минимум и максимум набора данных.
- Вычислите размах: \(\text{размах} = \max - \min\).
- Выберите число интервалов \(k\). Два распространённых правила — правило Старджеса \(k = 1 + \log_2(n)\) и правило квадратного корня \(k = \lceil \sqrt{n} \rceil\). Округлите \(k\) вверх до целого числа. Оба правила дают лишь отправную точку.
- Задайте ширину интервала: \(h = \lceil \text{размах} / k \rceil\). Округление вверх (часто до удобного целого числа) гарантирует, что интервалы покроют весь размах.
- Определите непересекающиеся границы классов, начиная с минимума: \(L_i = \min + i\,h\). Каждый интервал имеет вид \([L_i, L_i + h)\), то есть нижняя граница включается, а верхняя не включается. Значение, равное верхней границе интервала, попадает в следующий интервал.
- Отметьте каждое значение ровно в одном интервале, чтобы получить частоту \(f_i\).
- Вычислите относительную частоту \(f_i / n\) и накопленную частоту (нарастающую сумму \(f_i\)).
- Проверка: частоты должны в сумме давать \(n\), относительные частоты — 1 (с учётом округления), а последняя накопленная частота должна равняться \(n\).
Краткий пример с группировкой
Данные (n = 12): 4, 7, 8, 9, 11, 12, 12, 14, 15, 18, 19, 22.
Минимум = 4, максимум = 22, поэтому размах равен \(22 - 4 = 18\). Правило Старджеса даёт \(k = 1 + \log_2(12) \approx 4{,}58\), что округляется вверх до 5 интервалов. Ширина равна \(18 / 5 = 3{,}6\), округлённой вверх до \(h = 4\).
| Интервал | Значения | Частота | Относительная | Накопленная |
|---|---|---|---|---|
| [4, 8) | 4, 7 | 2 | 0,167 | 2 |
| [8, 12) | 8, 9, 11 | 3 | 0,250 | 5 |
| [12, 16) | 12, 12, 14, 15 | 4 | 0,333 | 9 |
| [16, 20) | 18, 19 | 2 | 0,167 | 11 |
| [20, 24) | 22 | 1 | 0,083 | 12 |
Проверка: \(2 + 3 + 4 + 2 + 1 = 12 = n\), а последняя накопленная частота равна 12.
Ключевые термины частотных распределений
- Частота (\(f\)): количество наблюдений, попадающих в категорию или интервал.
- Относительная частота: \(f / n\), доля всех наблюдений в интервале. Умножьте на 100, чтобы получить проценты.
- Накопленная частота: нарастающая сумма частот до данного интервала включительно.
- Интервал класса (бин): диапазон значений, объединяющий данные, например [8, 12).
- Ширина класса (\(h\)): расстояние от нижней границы одного интервала до нижней границы следующего.
- Границы класса и пределы: пределы — это заявленные конечные точки интервала (для целочисленных данных 10–19). Границы — это точки посередине между соседними интервалами (9,5 и 19,5), поэтому разрывов нет. При полуоткрытом соглашении [L, L + h) нижняя граница включается, а верхняя не включается.
- Середина класса: \((\text{нижняя} + \text{верхняя}) / 2\). Она используется для представления всех значений интервала при оценке статистик по сгруппированным данным.
- Мода: наиболее часто встречающееся значение. В сгруппированных данных модальный класс — это интервал с наибольшей частотой.
- Размах: максимум минус минимум.
- Стандартное отклонение: мера типичного отклонения от среднего. Версия для генеральной совокупности: \(\sigma = \sqrt{\frac{\sum (x_i - \mu)^2}{N}}\), используется, когда данные охватывают всю совокупность. Выборочная версия: \(s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n - 1}}\), используется, когда данные — выборка из большей совокупности. Деление на \(n - 1\) корректирует склонность выборки занижать разброс.
Интерпретация частотного распределения
Определение формы
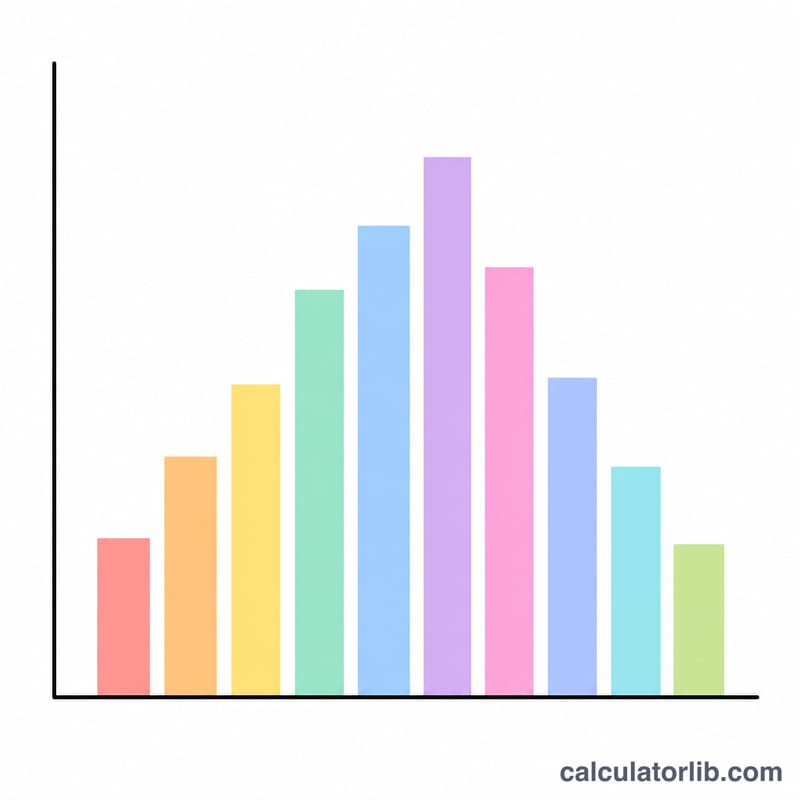
- Симметричное: две стороны гистограммы зеркально отражают друг друга относительно центра. Среднее и медиана близки.
- Правосторонняя асимметрия (положительная асимметрия): длинный хвост тянется к большим значениям, а большинство наблюдений находится в области малых значений.
- Левосторонняя асимметрия (отрицательная асимметрия): длинный хвост тянется к меньшим значениям, а большинство наблюдений находится в области больших значений.
- Бимодальное: два отчётливых пика, что часто указывает на смешение двух подгрупп в одном наборе данных.
- Равномерное: интервалы имеют примерно равные частоты, без выраженного пика.
Среднее и медиана
В распределении с правосторонней асимметрией среднее обычно больше медианы. При левосторонней асимметрии среднее обычно меньше медианы. Когда они примерно равны, распределение обычно почти симметрично. Это общая тенденция, а не строгое правило, и она может не выполняться для мультимодальных или нерегулярных данных.
Влияние выбросов
Среднее и стандартное отклонение чувствительны к экстремальным значениям, поскольку каждое из них вычисляется по всем наблюдениям, а SD возводит отклонения в квадрат. Медиана и мода почти не подвержены влиянию. Одно очень большое значение может заметно сместить среднее в свою сторону и увеличить SD, оставив медиану почти неизменной.
Стандартное отклонение и разброс
Больший SD означает, что значения сильнее разбросаны вокруг среднего. Для данных, близких к нормальному (колоколообразному) распределению, около 68% значений лежат в пределах 1 SD от среднего, около 95% — в пределах 2 SD и около 99,7% — в пределах 3 SD. Эти проценты в общем случае не выполняются для асимметричных данных или данных с тяжёлыми хвостами.
Ширина интервала меняет видимую форму
Очень узкие интервалы дают зубчатую гистограмму со множеством мелких пиков, которые могут быть просто шумом. Очень широкие интервалы так сильно сглаживают данные, что реальные особенности, например второй пик или асимметрия, могут исчезнуть. Один и тот же набор данных может выглядеть одномодальным при одной ширине интервала и бимодальным при другой, поэтому стоит проверить несколько ширин интервалов, прежде чем делать выводы о форме. Правила Старджеса или квадратного корня дают разумную отправную точку, а не единственно верный ответ.
Часто задаваемые вопросы
Сколько интервалов лучше брать? Распространённое эмпирическое правило — квадратный корень из числа наблюдений, но количество интервалов можно подбирать так, чтобы закономерность была видна максимально чётко. Слишком мало интервалов скрывают детали, слишком много — создают «шум».
Чем частота отличается от относительной частоты? Частота — это «сырое» число повторений, а относительная частота — это то же число как доля или процент от общего количества. Относительная частота удобнее, когда нужно сравнивать наборы данных разного размера.
Можно ли использовать калькулятор для сгруппированных непрерывных данных? Да. Задайте ширину интервала, чтобы сгруппировать непрерывные значения в диапазоны вроде 0–9, 10–19 и так далее, а затем считайте частоту для каждого диапазона.