Qu'est-ce que la fonction softmax ?
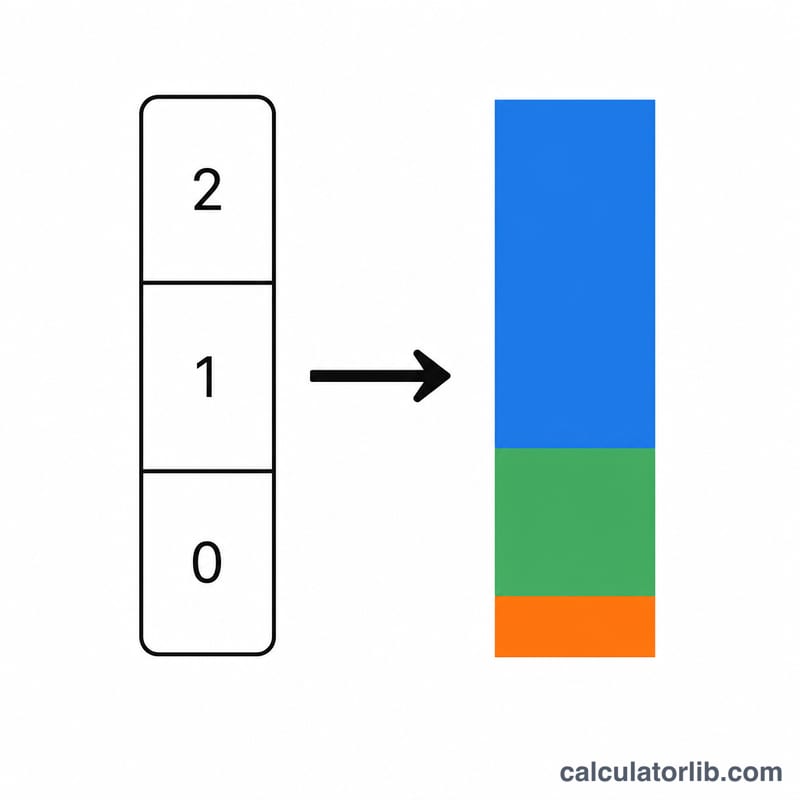
La fonction softmax prend un vecteur de K nombres réels et le transforme en une distribution de probabilités : chaque sortie est strictement comprise entre 0 et 1, et l'ensemble des K valeurs s'additionne exactement à 1. C'est la fonction d'activation de référence dans la couche de sortie des classifieurs à réseaux de neurones, où elle convertit les scores bruts du modèle (les logits) en probabilités de classe. Comme elle est sans dimension, les entrées sont de purs nombres, sans unité.
Comment utiliser ce calculateur
Saisissez votre vecteur d'entrée dans le champ sous la forme d'une liste de nombres séparés par des virgules, des espaces ou des sauts de ligne (par exemple 1, 2, 3). Les nombres peuvent être positifs, négatifs, nuls ou décimaux. Cliquez sur « Calculer » : vous obtiendrez la probabilité softmax de chaque composante, la somme des sorties (qui doit valoir 1) ainsi que l'argmax — l'indice (à partir de 1) de la plus grande probabilité.
La formule expliquée
Pour chaque composante j, le softmax vaut \(\sigma(z)_j = \dfrac{e^{z_j}}{\sum_{k} e^{z_k}}\). L'exponentiation rend chaque terme positif, et la division par le total les normalise pour que leur somme atteigne 1. Pour garantir la stabilité numérique, ce calculateur soustrait la valeur maximale \(m\) de chaque élément avant l'exponentiation :
$$\sigma(z)_j = \frac{e^{\,z_j - m}}{\displaystyle\sum_{k} e^{\,z_k - m}}$$Le facteur commun \(e^{-m}\) se simplifie, ce qui donne un résultat identique tout en évitant le dépassement de capacité (overflow) sur de grandes valeurs.
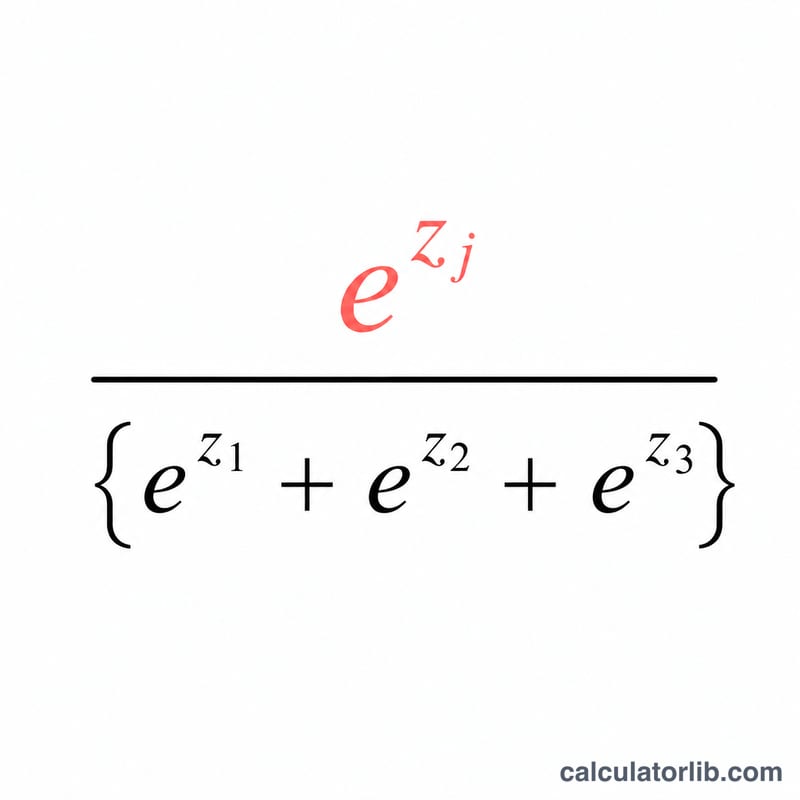
Exemple détaillé
Pour \(z = (1, 2, 3)\) : \(e^{1} = 2{,}71828\), \(e^{2} = 7{,}38906\), \(e^{3} = 20{,}08554\), soit une somme de \(30{,}19287\). En divisant chaque terme, on obtient
$$\sigma = (0{,}09003,\ 0{,}24473,\ 0{,}66524)$$dont la somme vaut 1. L'argmax est l'indice 3, qui correspond à la plus grande entrée, avec une probabilité de \(0{,}66524\).
Sortie softmax pour différents vecteurs d'entrée
Le tableau présente les sorties softmax pour plusieurs vecteurs d'entrée, calculées avec \(\sigma(\mathbf{x})_i = e^{x_i - \max(\mathbf{x})} / \sum_j e^{x_j - \max(\mathbf{x})}\). Les valeurs sont arrondies à 4 décimales, et les sorties totalisent toujours 1.
| Vecteur d'entrée | Sortie softmax | Argmax (position) | Commentaire |
|---|---|---|---|
| (1, 1, 1) | 0,3333, 0,3333, 0,3333 | Égalité (toutes égales) | Des entrées égales donnent une distribution uniforme, 1/3 chacune. |
| (1, 2, 3) | 0,0900, 0,2447, 0,6652 | 3e | Des écarts de 1 entre les entrées donnent une sortie модérément confiante. |
| (-1, 0, 1) | 0,0900, 0,2447, 0,6652 | 3e | Identique à (1, 2, 3) car il s'agit du même vecteur décalé de 2. |
| (0, 0, 5) | 0,0066, 0,0066, 0,9867 | 3e | Une grande entrée domine ; les deux entrées égales se partagent le reste à parts égales. |
| (2, 4, 6) | 0,0159, 0,1173, 0,8668 | 3e | Le vecteur (1, 2, 3) multiplié par 2 est plus accentué. |
| (10, 20, 30) | ≈0,0000 (2,06×10⁻⁹), ≈0,0000 (4,54×10⁻⁵), 1,0000 (0,99995) | 3e | Presque en one-hot. L'astuce de soustraction du maximum évite le dépassement de capacité avec de grandes entrées. |
Effet de mise à l'échelle : multiplier chaque entrée par un facteur supérieur à 1 élargit les écarts entre elles, de sorte que la plus grande entrée gagne en probabilité et la distribution se resserre. Le classement (argmax) ne change jamais. Une mise à l'échelle par un facteur compris entre 0 et 1 aplatit la distribution vers l'uniforme.
FAQ
Pourquoi la somme des sorties vaut-elle toujours 1 ? Parce que chaque exponentielle est divisée par la somme de toutes les exponentielles : cette normalisation garantit un total de 1.
Que se passe-t-il si toutes les entrées sont égales ? Le résultat est une distribution uniforme où chaque sortie vaut \(1/K\).
Ajouter une constante à toutes les entrées change-t-il le résultat ? Non. Le softmax est invariant par translation : ajouter la même constante \(c\) à toutes les entrées ne modifie pas la sortie, et c'est précisément pour cela que soustraire le maximum est sans risque.