R-स्क्वायर्ड क्या है?
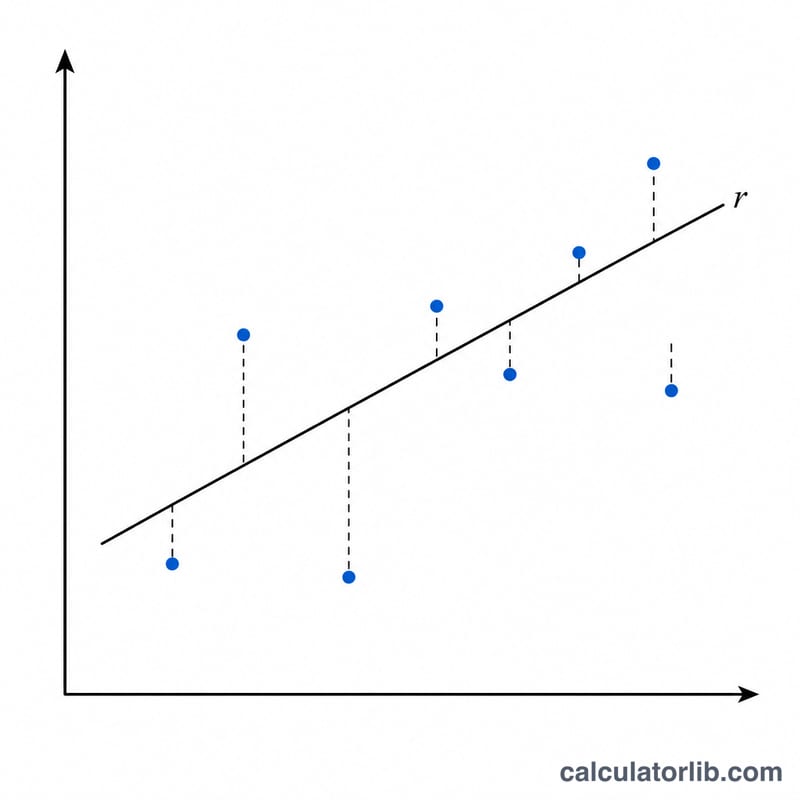
R-स्क्वायर्ड (R²), जिसे निर्धारण गुणांक (coefficient of determination) भी कहा जाता है, यह बताता है कि किसी मॉडल के अनुमान वास्तविक डेटा से कितने अच्छे ढंग से मेल खाते हैं। यह आश्रित चर (dependent variable) के विचरण (variance) का वह अनुपात दर्शाता है जिसे मॉडल समझा पाता है। एक समझदार मॉडल के लिए R² का मान 0 से 1 के बीच होता है: 1 का मतलब है कि अनुमान डेटा से पूरी तरह मेल खाते हैं, जबकि 0 का मतलब है कि मॉडल किसी भी विचरण को नहीं समझा पाता और औसत (mean) का अनुमान लगाने से बेहतर नहीं है। जब कोई मॉडल औसत पर खींची गई एक सीधी रेखा से भी खराब फिट बैठता है, तब R² ऋणात्मक भी हो सकता है।
इस कैलकुलेटर का उपयोग कैसे करें
अपने देखे गए मान (वास्तविक Y डेटा) और अनुमानित मान (मॉडल के आउटपुट Ŷ) कॉमा से अलग की गई सूची के रूप में दर्ज करें। दोनों सूचियाँ एक ही क्रम में और एक समान लंबाई की होनी चाहिए। 'गणना करें' पर क्लिक करने पर आपको R² के साथ-साथ अवशिष्ट वर्ग योग (\(SS_{res}\)), कुल वर्ग योग (\(SS_{tot}\)) और उपयोग किए गए डेटा बिंदुओं की संख्या मिलेगी।
सूत्र की व्याख्या
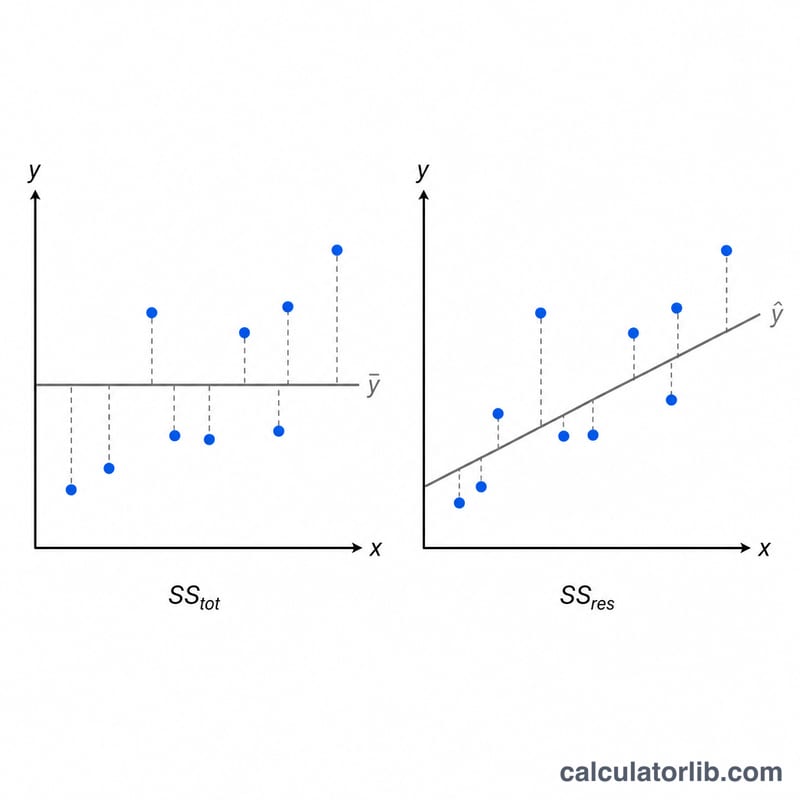
कैलकुलेटर सबसे पहले देखे गए मानों का औसत निकालता है। कुल वर्ग योग (total sum of squares) प्रत्येक अवलोकन और उस औसत के बीच के अंतर के वर्गों का योग है:
$$SS_{tot} = \sum \left( y_i - \bar{y} \right)^{2}$$अवशिष्ट वर्ग योग (residual sum of squares) देखे गए और अनुमानित मानों के बीच के अंतर के वर्गों का योग है:
$$SS_{res} = \sum \left( y_i - \hat{y}_i \right)^{2}$$इसके बाद यह होता है:
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$जब अवशेष (residuals) कुल विचरण की तुलना में छोटे होते हैं, तो \(SS_{res}/SS_{tot}\) शून्य के करीब होता है और R² 1 की ओर बढ़ता है।
हल किया हुआ उदाहरण
मान लीजिए देखे गए मान 3, −0.5, 2, 7 हैं और अनुमानित मान 2.5, 0.0, 2, 8 हैं। देखे गए मानों का औसत है \((3 - 0.5 + 2 + 7)/4 = 2.875\)।
$$SS_{res} = 0.5^{2} + (-0.5)^{2} + 0^{2} + (-1)^{2} = 0.25 + 0.25 + 0 + 1 = 1.5$$$$SS_{tot} = (0.125)^{2} + (-3.375)^{2} + (-0.875)^{2} + (4.125)^{2} \approx 0.015625 + 11.390625 + 0.765625 + 17.015625 = 29.1875$$$$R^{2} = 1 - \frac{1.5}{29.1875} \approx 0.9486$$विभिन्न फिट परिदृश्यों में R²
सभी पंक्तियाँ एक ही प्रेक्षित मानों का उपयोग करती हैं: 2, 4, 6, 8। माध्य \(\bar{Y} = (2+4+6+8)/4 = 5\) है, इसलिए \(SS_{tot} = (-3)^2 + (-1)^2 + 1^2 + 3^2 = 9+1+1+9 = 20\)। केवल पूर्वानुमान बदलते हैं।
| परिदृश्य | पूर्वानुमानित मान | SS_res | SS_tot | R² |
|---|---|---|---|---|
| उत्तम फिट | 2, 4, 6, 8 | 0 | 20 | 1 |
| निकट फिट | 3, 4, 6, 7 | (-1)² + 0² + 0² + 1² = 2 | 20 | 0.9 |
| मध्यम फिट | 4, 4, 6, 6 | (-2)² + 0² + 0² + 2² = 8 | 20 | 0.6 |
| माध्य का पूर्वानुमान | 5, 5, 5, 5 | 9 + 1 + 1 + 9 = 20 | 20 | 0 |
| खराब फिट (उलटा रुझान) | 8, 6, 4, 2 | (-6)² + (-2)² + 2² + 6² = 80 | 20 | -3 |
निकट फिट के लिए कार्य की जाँच: \(R^2 = 1 - 2/20 = 1 - 0.1 = 0.9\)। खराब फिट के लिए: \(R^2 = 1 - 80/20 = 1 - 4 = -3\)। जब भी \(SS_{res}\), \(SS_{tot}\) से अधिक होता है, R² शून्य से नीचे चला जाता है।
अक्सर पूछे जाने वाले सवाल
क्या R² ऋणात्मक हो सकता है? हाँ। जब मॉडल केवल डेटा का औसत अनुमान लगाने से भी खराब फिट बैठता है, तो \(SS_{res}\), \(SS_{tot}\) से अधिक हो जाता है और R² ऋणात्मक हो जाता है।
क्या ऊँचा R² अच्छे मॉडल का संकेत है? हमेशा नहीं। ऊँचा R² इस डेटा से निकट फिट दर्शाता है, लेकिन यह ओवरफिटिंग (overfitting) का परिणाम भी हो सकता है। हमेशा ऐसे डेटा से सत्यापन करें जो मॉडल को प्रशिक्षित करने में उपयोग नहीं हुआ हो।
R² और एडजस्टेड R² में क्या अंतर है? एडजस्टेड R² ऐसे प्रिडिक्टर जोड़ने पर दंड लगाता है जो मॉडल को बेहतर नहीं बनाते, जो बहु-प्रतिगमन (multiple regression) में उपयोगी होता है। यह कैलकुलेटर बिना एडजस्ट किया गया R² दिखाता है।