決定係数R²とは?
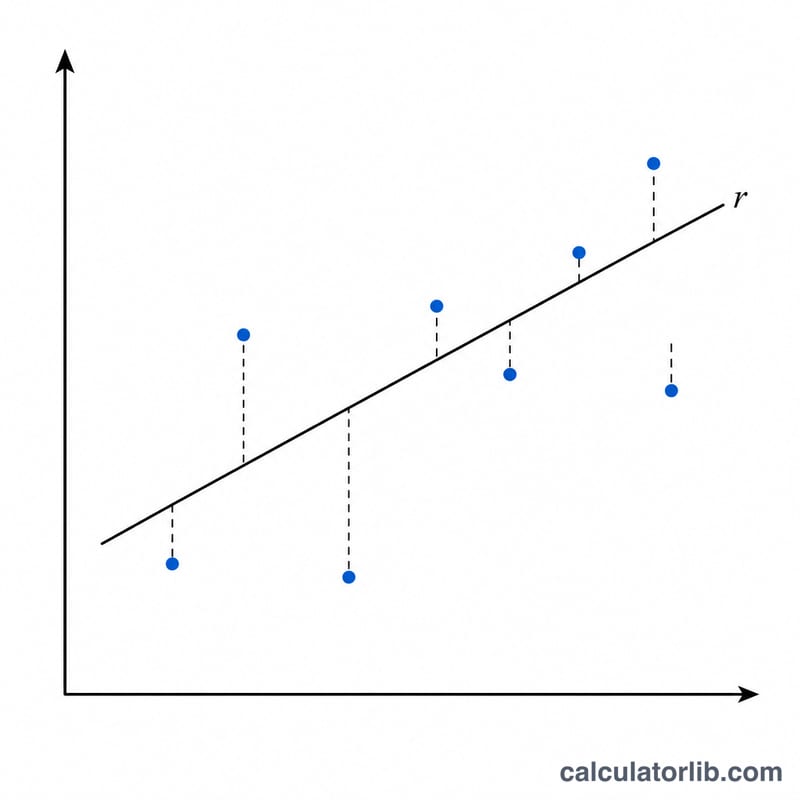
決定係数(R²)は「coefficient of determination」とも呼ばれ、モデルの予測値が実際の観測データにどれだけよく一致しているかを表す指標です。目的変数(従属変数)の分散のうち、モデルによって説明できる割合を示します。妥当なモデルであればR²は0から1の範囲に収まり、1なら予測がデータに完全に一致していること、0ならモデルがばらつきをまったく説明できておらず、平均値で予測するのと変わらないことを意味します。なお、モデルの当てはまりが平均値の水平線よりも悪い場合には、R²が負の値になることもあります。
この計算ツールの使い方
観測値(実際のYデータ)と予測値(モデルの出力Ŷ)を、それぞれカンマ区切りのリストで入力してください。2つのリストは同じ順序・同じ個数で揃える必要があります。「計算」をクリックすると、R²に加えて、残差平方和(\(SS_{res}\))、全平方和(\(SS_{tot}\))、使用したデータ点の個数が表示されます。
計算式の解説
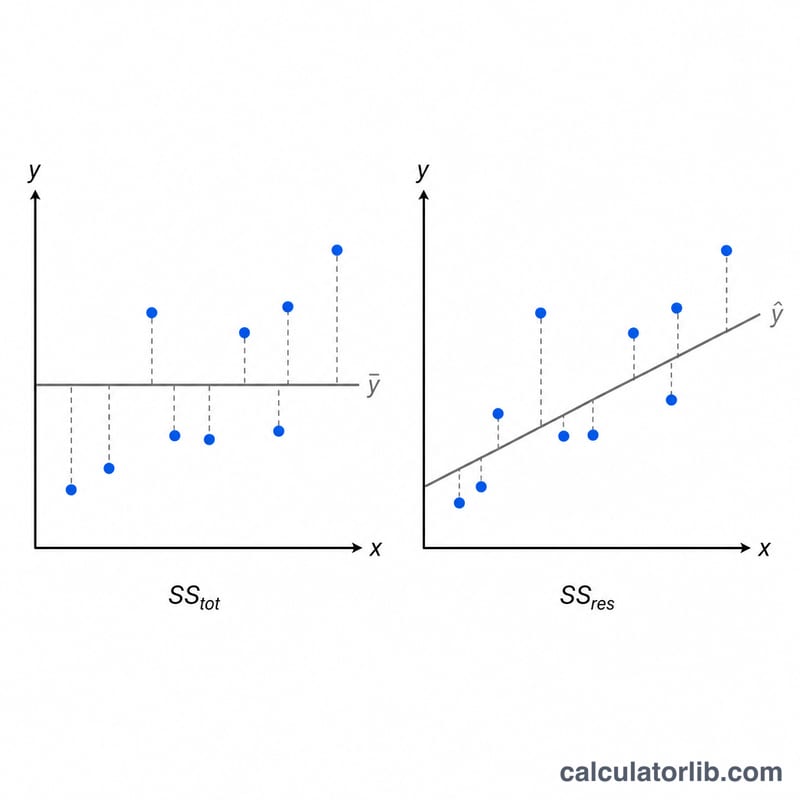
このツールはまず観測値の平均を求めます。全平方和は、各観測値とその平均との差を2乗して合計したものです:$$SS_{tot} = \sum \left( y_i - \bar{y} \right)^2$$残差平方和は、観測値と予測値の差を2乗して合計したものです:$$SS_{res} = \sum \left( y_i - \hat{y}_i \right)^2$$そしてR²は $$R^2 = 1 - \frac{SS_{res}}{SS_{tot}}$$ で求められます。残差が全体のばらつきに対して小さいとき、\(SS_{res}/SS_{tot}\) は0に近づき、R²は1に近づきます。
計算例
観測値が 3、−0.5、2、7 で、予測値が 2.5、0.0、2、8 だとします。観測値の平均は $$\frac{3 - 0.5 + 2 + 7}{4} = 2.875$$ です。$$SS_{res} = 0.5^2 + (-0.5)^2 + 0^2 + (-1)^2 = 0.25 + 0.25 + 0 + 1 = 1.5$$ となります。$$SS_{tot} = (0.125)^2 + (-3.375)^2 + (-0.875)^2 + (4.125)^2 \approx 0.015625 + 11.390625 + 0.765625 + 17.015625 = 29.1875$$ です。したがって $$R^2 = 1 - \frac{1.5}{29.1875} \approx 0.9486$$ となります。
異なるフィッティング条件における R²
すべての行で同じ観測値 2, 4, 6, 8 を使用します。平均は \(\bar{Y} = (2+4+6+8)/4 = 5\) なので、\(SS_{tot} = (-3)^2 + (-1)^2 + 1^2 + 3^2 = 9+1+1+9 = 20\) となります。変わるのは予測値だけです。
| 条件 | 予測値 | SS_res | SS_tot | R² |
|---|---|---|---|---|
| 完全一致 | 2, 4, 6, 8 | 0 | 20 | 1 |
| 近い適合 | 3, 4, 6, 7 | (-1)² + 0² + 0² + 1² = 2 | 20 | 0.9 |
| 中程度の適合 | 4, 4, 6, 6 | (-2)² + 0² + 0² + 2² = 8 | 20 | 0.6 |
| 平均値の予測 | 5, 5, 5, 5 | 9 + 1 + 1 + 9 = 20 | 20 | 0 |
| 不適合(傾向が逆転) | 8, 6, 4, 2 | (-6)² + (-2)² + 2² + 6² = 80 | 20 | -3 |
近い適合の検算:\(R^2 = 1 - 2/20 = 1 - 0.1 = 0.9\)。不適合の場合:\(R^2 = 1 - 80/20 = 1 - 4 = -3\)。\(SS_{res}\) が \(SS_{tot}\) を上回ると、R² は負の値になります。
よくある質問(FAQ)
R²は負の値になることがありますか? はい、あります。モデルの当てはまりが、単純にデータの平均値で予測する場合よりも悪いとき、\(SS_{res}\) が \(SS_{tot}\) を上回り、R²は負の値になります。
R²が高ければ良いモデルと言えますか? 必ずしもそうとは限りません。R²が高いことは、そのデータへの当てはまりが良いことを示しますが、過学習(オーバーフィッティング)が原因である場合もあります。常に学習に使っていない別のデータ(アウトオブサンプル)で検証することが大切です。
R²と自由度調整済みR²の違いは何ですか? 自由度調整済みR²は、モデルの改善に寄与しない説明変数を追加した場合にペナルティを課す指標で、重回帰分析で特に役立ちます。この計算ツールが算出するのは、調整前の通常のR²です。