決定係数(R²)とは?
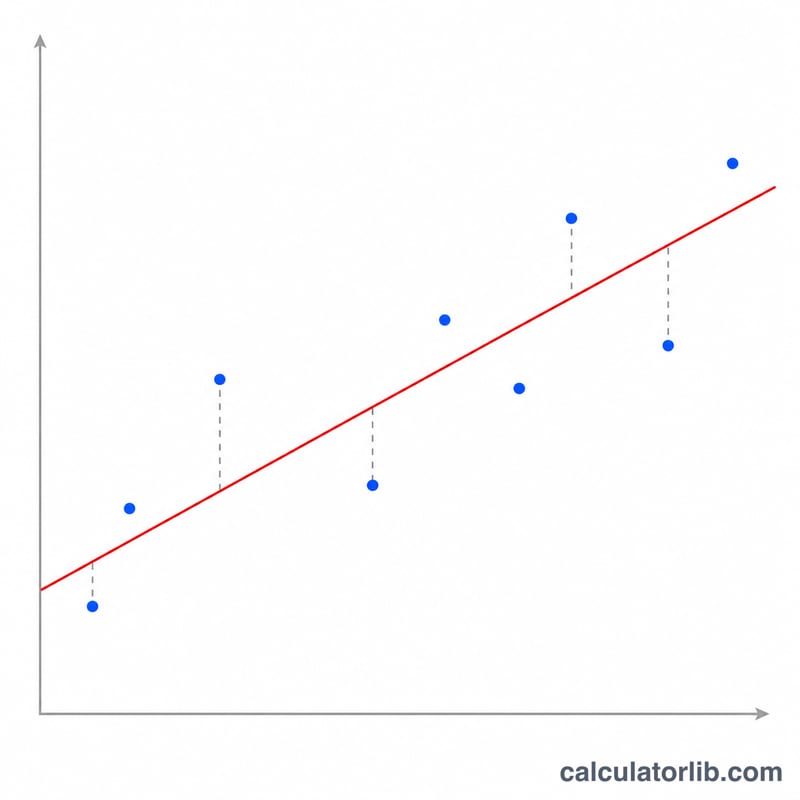
決定係数(R²、R2乗とも呼ばれます)は、モデルの予測値が実際に観測されたデータにどれだけ当てはまっているかを示す指標です。具体的には、目的変数(従属変数)の分散のうち、モデルによって説明できる割合を表します。R²は最大で1(予測値が実測値と完全に一致する理想的な当てはまり)、0(平均値をそのまま予測するのと変わらない)まで変化し、さらにモデルが平均値ベースラインよりも劣る場合にはマイナスの値になることもあります。
この計算ツールの使い方
実際に観測された値(y)のリストと、それに対応する予測値(ŷ)のリストを、同じ順番でカンマ区切りの数値として入力してください。本ツールが両者をペアにし、実測値の平均を求めたうえで、残差平方和(SSres)と全平方和(SStot)を計算し、R²と説明できた分散の割合(%)を返します。
計算式の解説
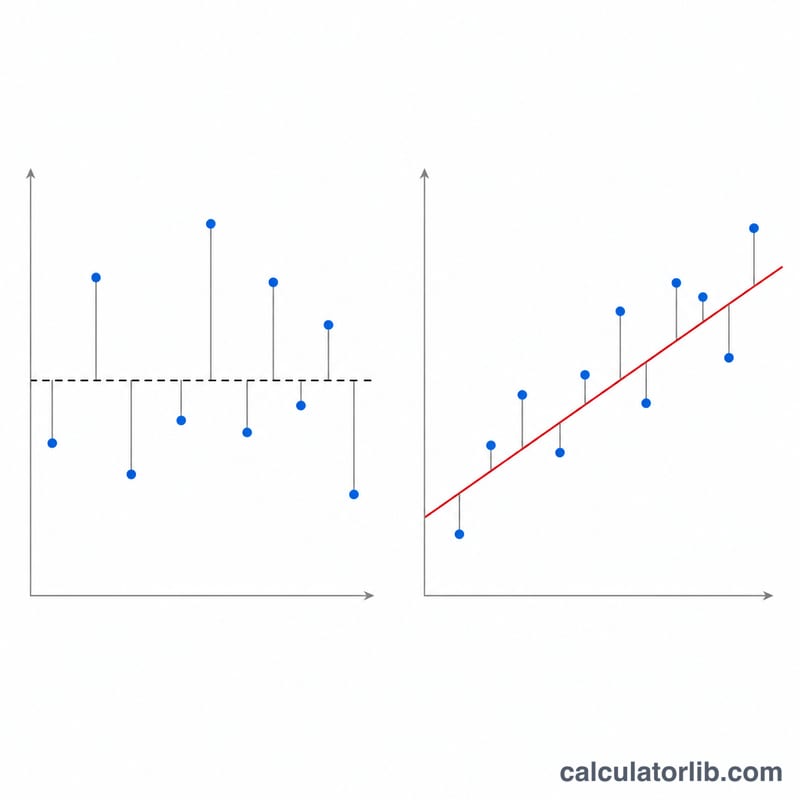
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$ です。ここで \(SS_{res} = \sum (y_i - \hat{y}_i)^2\) は、モデルの予測後に残る誤差(残差)を表し、\(SS_{tot} = \sum (y_i - \bar{y})^2\) は、データがその平均値の周りでどれだけばらついているか、つまり全体の変動量を表します。SSres を SStot で割ると、モデルが説明できなかった変動の割合がわかり、それを1から引くことで、モデルが説明できた変動の割合が求められます。
計算例
実測値 = [3, −0.5, 2, 7]、予測値 = [2.5, 0.0, 2, 8] の場合。実測値の平均 = 2.875。\(SS_{res} = 0.5^2 + 0.5^2 + 0^2 + 1^2 = 0.25 + 0.25 + 0 + 1 = 1.5\)。\(SS_{tot} = (0.125)^2 + (3.375)^2 + (0.875)^2 + (4.125)^2 \approx 0.0156 + 11.3906 + 0.7656 + 17.0156 = 29.1875\)。$$R^{2} = 1 - \frac{1.5}{29.1875} \approx 0.9486$$ となり、このモデルは分散の約94.9%を説明できていることになります。
R²値の解釈
R²(決定係数)は、モデルの二乗誤差を、実測値の平均を常に予測する単純な基準モデルの二乗誤差と比較します: \(R^2 = 1 - SS_{res}/SS_{tot}\)。100を掛けると、予測値によって説明される実測値の分散の割合になります。
| R² | 意味 |
|---|---|
| 1.0 | 予測値がすべての実測値と完全に一致します(SSres = 0)。分散の100%が説明されます。 |
| 0.9 | 分散の約90%が説明されます。適合度は高いといえます。 |
| 0.7 | 約70%が説明されます。適合度は十分ですが、説明できないばらつきも目立ちます。 |
| 0.5 | 分散の約半分が説明され、残り半分は説明されません。 |
| 0.3 | 約30%が説明されます。適合度は低いものの、ノイズの多い分野では依然として意味がある場合があります。 |
| 0.0 | モデルは毎回平均値を予測するのと同程度にしか当てはまりません(SSres = SStot)。 |
| 0未満 | モデルは平均を基準とするモデルより劣ります(SSres > SStot)。 |
良いR²とは何か?
普遍的な基準値はありません。測定が管理され、関係性がほぼ決定論的である物理科学や工学では、0.9を超える値が一般的に期待されます。社会科学、行動科学、経済学、多くの生物学研究では、結果は多くの未測定要因によって左右されるため、0.2〜0.5のR²でも有用な場合があります。値の評価は、その分野の慣行とモデルの目的に照らして行ってください。
重要な注意点
- 因果関係ではない: R²が高いことは、予測値がデータに沿っていることを示すだけで、入力が結果の原因であることを示すものではありません。
- 偏りがないとは限らない: R²が高くても、一部の範囲で系統的にずれている場合があります。残差プロットを確認してください。
- 過学習ではない: モデルの当てはめに使ったデータで計算したR²は、役に立たない予測変数を含め、予測変数を追加するほど上昇する傾向があります。可能な場合は、ホールドアウトデータで評価してください。
- 自由度調整済みR²は追加の予測変数にペナルティを与えるため、変数の数が異なるモデルを比較する際に適しています。
- 同じデータに対する最小二乗法以外の方法(例:新しいデータに適用したモデル)で予測値が得られた場合、負の値になることがあります。
異なる当てはめシナリオにおけるR²
4つのシナリオはすべて同じ実測値 y = 2, 4, 6, 8, 10 を使用します。その平均は \(\bar{y} = 30/5 = 6\) なので、どの場合も \(SS_{tot} = (2-6)^2 + (4-6)^2 + (6-6)^2 + (8-6)^2 + (10-6)^2 = 16 + 4 + 0 + 4 + 16 = 40\) になります。変わるのは予測値だけです。
| シナリオ | 実測値 y | 予測値 ŷ | SSres | SStot | R² | 説明 |
|---|---|---|---|---|---|---|
| 完全な適合 | 2, 4, 6, 8, 10 | 2, 4, 6, 8, 10 | 0 | 40 | 1 | すべての残差がゼロのため、分散はすべて説明されます。 |
| 良い適合 | 2, 4, 6, 8, 10 | 3, 4, 6, 7, 10 | 2 | 40 | 0.95 | 2点で±1の小さな誤差があります。分散の95%が説明されます。 |
| 平均のみ | 2, 4, 6, 8, 10 | 6, 6, 6, 6, 6 | 40 | 40 | 0 | 常に平均を予測すると基準モデルとちょうど一致するため、R² = 0 になります。 |
| 平均より悪い | 2, 4, 6, 8, 10 | 10, 8, 6, 4, 2 | 160 | 40 | -3 | 予測値が逆方向に動いているため、誤差は基準モデルの誤差より大きくなります。 |
計算の確認
- 良い適合:残差は -1, 0, 0, 1, 0 なので、\(SS_{res} = 1 + 0 + 0 + 1 + 0 = 2\) かつ \(R^2 = 1 - 2/40 = 0.95\) です。
- 平均のみ:残差は -4, -2, 0, 2, 4 なので、\(SS_{res} = 16 + 4 + 0 + 4 + 16 = 40\) かつ \(R^2 = 1 - 40/40 = 0\) です。
- 平均より悪い:残差は -8, -4, 0, 4, 8 なので、\(SS_{res} = 64 + 16 + 0 + 16 + 64 = 160\) かつ \(R^2 = 1 - 160/40 = -3\) です。
主要な用語と記号
- R²(決定係数)
- 予測値によって説明される、実測値の分散の割合です。\(R^2 = 1 - SS_{res}/SS_{tot}\)。最大で1であり、負の値にもなります。
- SSres(残差平方和)
- 実測値と予測値の差の二乗和 \(\sum (y - \hat{y})^2\) です。モデルが説明できなかった誤差を表します。
- SStot(全平方和)
- 各実測値と平均との差の二乗和 \(\sum (y - \bar{y})^2\) です。データ全体のばらつきを表します。
- SSreg(説明平方和または回帰平方和)
- モデルが捉えたばらつき \(\sum (\hat{y} - \bar{y})^2\) です。切片を含む通常の最小二乗法による当てはめでは、\(SS_{tot} = SS_{reg} + SS_{res}\) となるため、\(R^2 = SS_{reg}/SS_{tot}\) です。この関係は任意の予測値には成り立ちません。
- 残差
- 1つの観測値に対する誤差 \(y - \hat{y}\)、すなわち実測値から予測値を引いたものです。
- 実測値の平均(ȳ)
- 実測値の平均 \(\bar{y} = \frac{1}{n}\sum y\) です。R²を測定する際の基準となる予測値です。
- 予測値(ŷ)
- 観測値に対してモデルが出力する値です。
- 自由度調整済みR²
- 標本サイズ n に対して予測変数の数 p にペナルティを与えるR²の一種です:$$R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}$$ 追加した予測変数が当てはまりを十分に改善しない場合、値が低下することがあります。
- R²とピアソンのr
- ピアソンのr は、2つの変数間の線形関係の強さと方向(-1〜1)を測定します。切片を含む単回帰では、R² は r² に等しくなります。ここで計算されるR²は、任意の予測値の集合と実測値を比較するため負の値になりえますが、r² は負になりません。
よくある質問(FAQ)
R²はマイナスになることがありますか? はい、あります。予測値が、毎回ただ平均値を当てる場合よりも悪い結果になると、SSres が SStot を上回り、R²はマイナスの値になります。
R²が高ければ良いモデルと言えますか? 必ずしもそうとは限りません。R²は過学習(オーバーフィッティング)や無関係な説明変数の追加によって、見かけ上高くなることがあります。残差プロットや未知データ(テストデータ)での性能と合わせて、必ず総合的に判断しましょう。
R²と相関係数の違いは何ですか? 単回帰分析の場合、R²は実測値と予測値の間のピアソン相関係数(r)の2乗に等しくなります。