결정계수(R²)란?
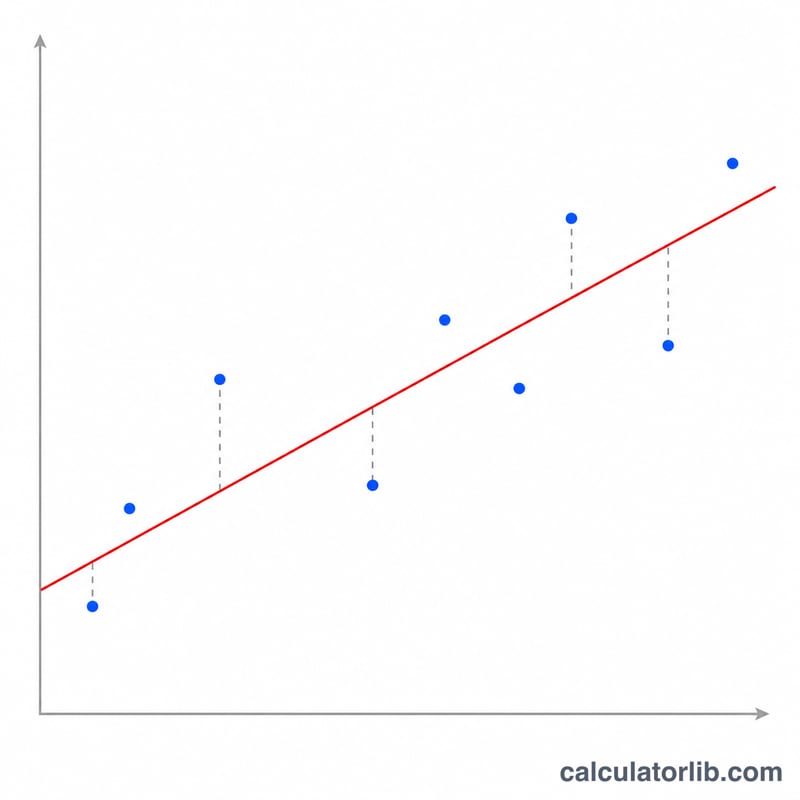
결정계수는 보통 \(R^{2}\)로 표기하며, 모델의 예측값이 실제 관측 데이터를 얼마나 잘 설명하는지를 나타내는 지표입니다. 다시 말해, 종속변수의 전체 분산 중에서 모델이 설명해 내는 비율을 뜻합니다. \(R^{2}\)는 예측값이 실제값과 완벽하게 일치하는 1(완벽한 적합)에서 시작해, 단순히 평균만 예측하는 수준과 다를 바 없는 0까지 이어지며, 모델이 평균을 그대로 쓰는 것보다 더 나쁠 경우에는 음수가 될 수도 있습니다.
계산기 사용법
실제 관측값(y) 목록과 그에 대응하는 예측값(ŷ) 목록을 입력하세요. 두 목록 모두 같은 순서로, 쉼표로 구분한 숫자로 넣어주면 됩니다. 계산기는 두 값을 짝지어 실제값의 평균을 구한 뒤, 잔차제곱합(\(SS_{res}\))과 총제곱합(\(SS_{tot}\))을 산출해 \(R^{2}\)와 설명된 분산 비율(%)을 돌려줍니다.
공식 풀어보기
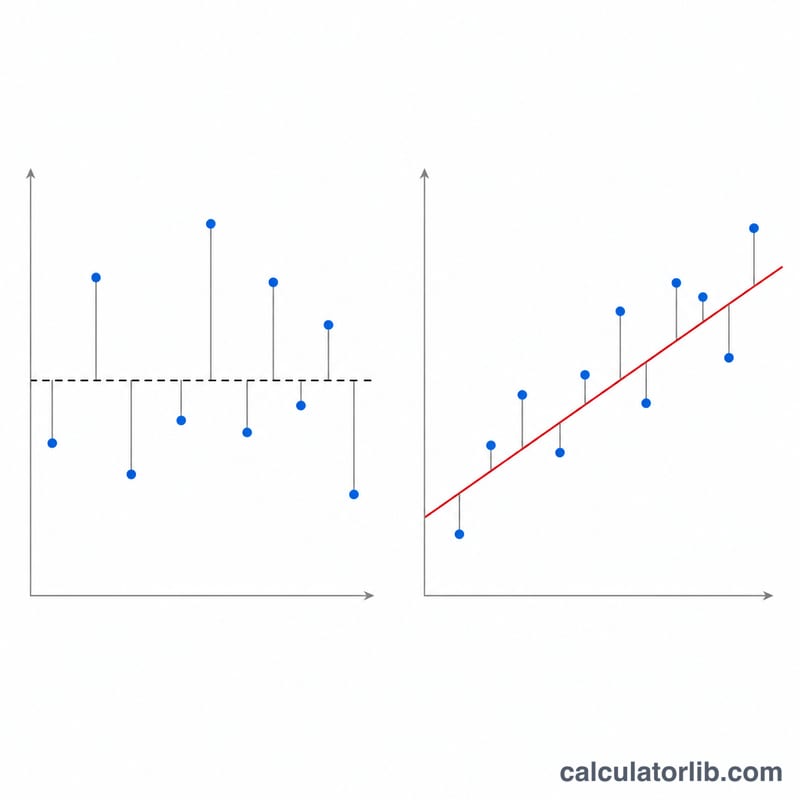
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$ 입니다. 여기서 \(SS_{res} = \sum (y_{i} - \hat{y}_{i})^{2}\) 는 모델 예측 이후에도 남아 있는 오차를 나타내고, \(SS_{tot} = \sum (y_{i} - \bar{y})^{2}\) 는 데이터가 자기 평균을 중심으로 얼마나 흩어져 있는지(전체 변동)를 나타냅니다. \(SS_{res}\)를 \(SS_{tot}\)로 나누면 모델이 설명하지 못한 변동의 비율이 나오고, 이를 1에서 빼면 모델이 설명해 낸 비율이 됩니다.
예제로 살펴보기
실제값 = [3, −0.5, 2, 7], 예측값 = [2.5, 0.0, 2, 8]. 실제값의 평균 = 2.875. $$SS_{res} = 0.5^{2} + 0.5^{2} + 0^{2} + 1^{2} = 0.25 + 0.25 + 0 + 1 = 1.5$$ $$SS_{tot} = (0.125)^{2} + (3.375)^{2} + (0.875)^{2} + (4.125)^{2} \approx 0.0156 + 11.3906 + 0.7656 + 17.0156 = 29.1875$$ 따라서 $$R^{2} = 1 - \frac{1.5}{29.1875} \approx 0.9486$$ 이며, 이 모델은 전체 분산의 약 94.9%를 설명한다고 볼 수 있습니다.
R² 값 해석하기
R²(결정계수)은 모델의 제곱 오차를, 실제 값의 평균을 항상 예측하는 단순 기준 모델의 제곱 오차와 비교합니다: \(R^2 = 1 - SS_{res}/SS_{tot}\). 여기에 100을 곱하면 예측값이 설명하는 실제 값 분산의 비율이 됩니다.
| R² | 의미 |
|---|---|
| 1.0 | 예측값이 모든 실제 값과 정확히 일치합니다(SSres = 0). 분산의 100%가 설명됩니다. |
| 0.9 | 분산의 약 90%가 설명됩니다. 적합도가 높습니다. |
| 0.7 | 약 70%가 설명됩니다. 설명되지 않는 산포가 뚜렷하지만 상당히 잘 맞는 적합입니다. |
| 0.5 | 분산의 약 절반은 설명되고 나머지 절반은 설명되지 않습니다. |
| 0.3 | 약 30%가 설명됩니다. 적합도가 약하지만, 잡음이 많은 분야에서는 여전히 의미가 있을 수 있습니다. |
| 0.0 | 모델이 매번 평균을 예측하는 것보다 나을 것이 없습니다(SSres = SStot). |
| 0 미만 | 모델이 평균 기준 모델보다 나쁩니다(SSres > SStot). |
좋은 R²는 무엇인가요?
보편적인 기준값은 없습니다. 측정이 통제되고 관계가 거의 결정론적인 물리학과 공학에서는 0.9를 넘는 값이 흔히 기대됩니다. 사회과학, 행동 연구, 경제학 및 많은 생물학 연구에서는 측정되지 않은 많은 요인이 결과를 좌우하므로, R²가 0.2~0.5여도 유용할 수 있습니다. 값은 해당 분야의 관행과 모델의 목적에 비추어 판단하십시오.
중요한 유의사항
- 인과관계 아님: R²가 높다는 것은 예측값이 데이터를 잘 따른다는 뜻이지, 입력값이 결과를 일으킨다는 뜻이 아닙니다.
- 편향 아님: 모델의 R²가 높아도 일부 구간에서는 체계적으로 어긋날 수 있습니다. 잔차 도표를 확인하십시오.
- 과적합 아님: 모델을 적합하는 데 사용한 데이터로 계산한 R²는, 쓸모없는 예측변수라도 추가할수록 높아지는 경향이 있습니다. 가능하면 별도로 떼어 둔 데이터로 평가하십시오.
- 수정된 R²(Adjusted R²)는 추가된 예측변수에 패널티를 주므로, 변수 개수가 다른 모델을 비교할 때 더 적합합니다.
- 같은 데이터에 대한 최소제곱 적합이 아닌 다른 방식으로 예측값을 만든 경우, 예를 들어 새 데이터에 적용한 모델에서는 음수 값이 나올 수 있습니다.
서로 다른 적합 시나리오의 R²
네 가지 시나리오는 모두 같은 실제 값 y = 2, 4, 6, 8, 10을 사용합니다. 평균은 \(\bar{y} = 30/5 = 6\)이므로, 모든 경우에 \(SS_{tot} = (2-6)^2 + (4-6)^2 + (6-6)^2 + (8-6)^2 + (10-6)^2 = 16 + 4 + 0 + 4 + 16 = 40\)입니다. 바뀌는 것은 예측값뿐입니다.
| 시나리오 | 실제 y | 예측값 ŷ | SSres | SStot | R² | 설명 |
|---|---|---|---|---|---|---|
| 완벽한 적합 | 2, 4, 6, 8, 10 | 2, 4, 6, 8, 10 | 0 | 40 | 1 | 모든 잔차가 0이므로 분산이 전부 설명됩니다. |
| 좋은 적합 | 2, 4, 6, 8, 10 | 3, 4, 6, 7, 10 | 2 | 40 | 0.95 | 두 점에서 ±1의 작은 오차가 나타납니다. 분산의 95%가 설명됩니다. |
| 평균만 사용 | 2, 4, 6, 8, 10 | 6, 6, 6, 6, 6 | 40 | 40 | 0 | 항상 평균을 예측하면 기준 모델과 정확히 같으므로 R² = 0입니다. |
| 평균보다 나쁨 | 2, 4, 6, 8, 10 | 10, 8, 6, 4, 2 | 160 | 40 | -3 | 예측 방향이 실제와 반대이므로, 오차가 기준 모델의 오차보다 큽니다. |
산술 검산
- 좋은 적합: 잔차는 -1, 0, 0, 1, 0이므로 \(SS_{res} = 1 + 0 + 0 + 1 + 0 = 2\)이고 \(R^2 = 1 - 2/40 = 0.95\)입니다.
- 평균만 사용: 잔차는 -4, -2, 0, 2, 4이므로 \(SS_{res} = 16 + 4 + 0 + 4 + 16 = 40\)이고 \(R^2 = 1 - 40/40 = 0\)입니다.
- 평균보다 나쁨: 잔차는 -8, -4, 0, 4, 8이므로 \(SS_{res} = 64 + 16 + 0 + 16 + 64 = 160\)이고 \(R^2 = 1 - 160/40 = -3\)입니다.
핵심 용어와 기호
- R² (결정계수)
- 실제 값의 분산 중 예측값이 설명하는 비율이며, \(R^2 = 1 - SS_{res}/SS_{tot}\)입니다. 최대 1이며 음수가 될 수 있습니다.
- SSres (잔차 제곱합)
- 실제 값과 예측값 차이의 제곱합, \(\sum (y - \hat{y})^2\)입니다. 모델이 설명하지 못하고 남긴 오차를 측정합니다.
- SStot (총 제곱합)
- 각 실제 값과 평균 차이의 제곱합, \(\sum (y - \bar{y})^2\)입니다. 데이터 전체의 변동을 측정합니다.
- SSreg (설명 제곱합 또는 회귀 제곱합)
- 모델이 포착한 변동, \(\sum (\hat{y} - \bar{y})^2\)입니다. 절편이 있는 최소제곱 적합에서는 \(SS_{tot} = SS_{reg} + SS_{res}\)이므로 \(R^2 = SS_{reg}/SS_{tot}\)입니다. 이 관계는 임의의 예측값에는 성립하지 않습니다.
- 잔차
- 관측치 하나의 오차, \(y - \hat{y}\): 실제 값에서 예측값을 뺀 값입니다.
- 실제 값의 평균 (ȳ)
- 실제 값들의 평균, \(\bar{y} = \frac{1}{n}\sum y\)입니다. R²를 측정하는 기준이 되는 기준 예측값입니다.
- 예측값 (ŷ)
- 모델이 관측치 하나에 대해 출력하는 값입니다.
- 수정된 R² (Adjusted R²)
- 표본 크기 n에 대해 예측변수 개수 p에 패널티를 주는 R²의 변형입니다: $$R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}$$ 추가한 예측변수가 적합도를 충분히 높이지 못하면 값이 떨어질 수 있습니다.
- R²와 피어슨 r의 관계
- 피어슨 r은 두 변수 사이 선형 관계의 강도와 방향(-1~1)을 측정합니다. 절편이 있는 단순 선형 회귀에서는 R²가 r²와 같습니다. 여기서 계산한 R²는 어떤 예측값 집합이든 실제 값과 비교하므로 음수가 될 수 있지만, r²는 그렇지 않습니다.
자주 묻는 질문
\(R^{2}\)가 음수가 될 수도 있나요? 네, 가능합니다. 예측값이 매번 평균을 그대로 찍는 것보다도 못한 경우, \(SS_{res}\)가 \(SS_{tot}\)보다 커지면서 \(R^{2}\)가 음수가 됩니다.
\(R^{2}\)가 높으면 무조건 좋은 모델인가요? 꼭 그렇지는 않습니다. 과적합(overfitting)이나 의미 없는 변수를 추가하는 것만으로도 \(R^{2}\)가 부풀려질 수 있습니다. 잔차 그래프나 표본 외(out-of-sample) 성능과 함께 종합적으로 확인하는 것이 좋습니다.
\(R^{2}\)와 상관계수는 어떻게 다른가요? 단순 선형 회귀에서는 \(R^{2}\)가 실제값과 예측값 사이의 피어슨 상관계수(\(r\))를 제곱한 값과 같습니다.