¿Qué es el coeficiente de determinación (R²)?
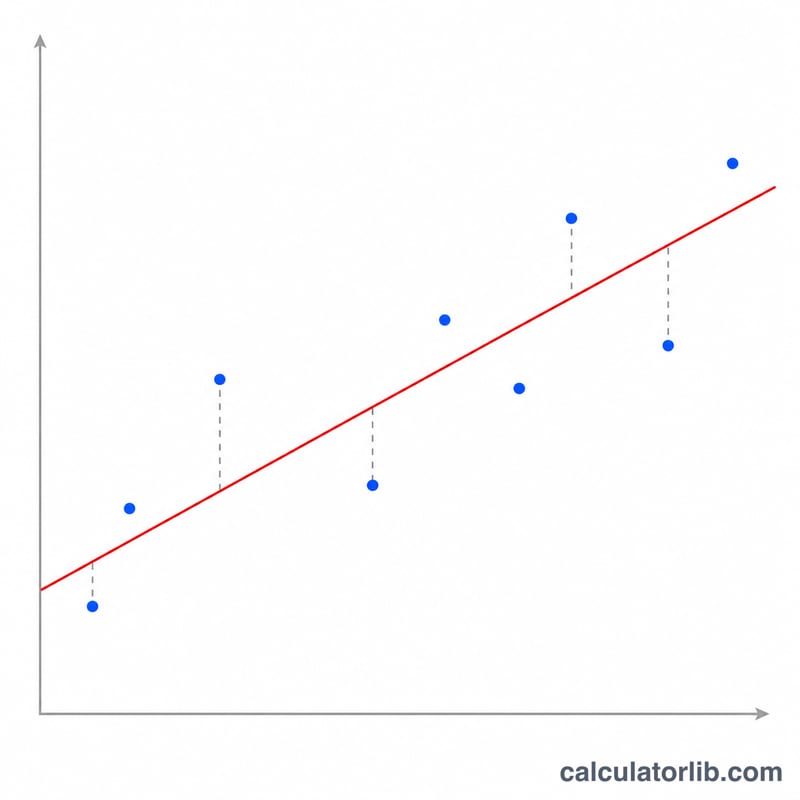
El coeficiente de determinación, que se escribe \(R^{2}\), mide hasta qué punto las predicciones de un modelo coinciden con los datos realmente observados. Representa la proporción de la varianza de la variable dependiente que el modelo logra explicar. El \(R^{2}\) va desde 1 (un ajuste perfecto, en el que las predicciones coinciden exactamente con los valores reales) hasta 0 (el modelo no es mejor que predecir simplemente la media) e incluso puede ser negativo cuando el modelo rinde peor que esa media de referencia.
Cómo usar esta calculadora
Introduce la lista de valores reales observados (y) y la lista correspondiente de valores predichos (ŷ), cada una como números separados por comas y en el mismo orden. La calculadora empareja los valores, calcula la media de los valores reales y, a partir de ahí, obtiene la suma de cuadrados de los residuos (SSres) y la suma total de cuadrados (SStot) para devolverte el \(R^{2}\) y el porcentaje de varianza explicada.
La fórmula, paso a paso
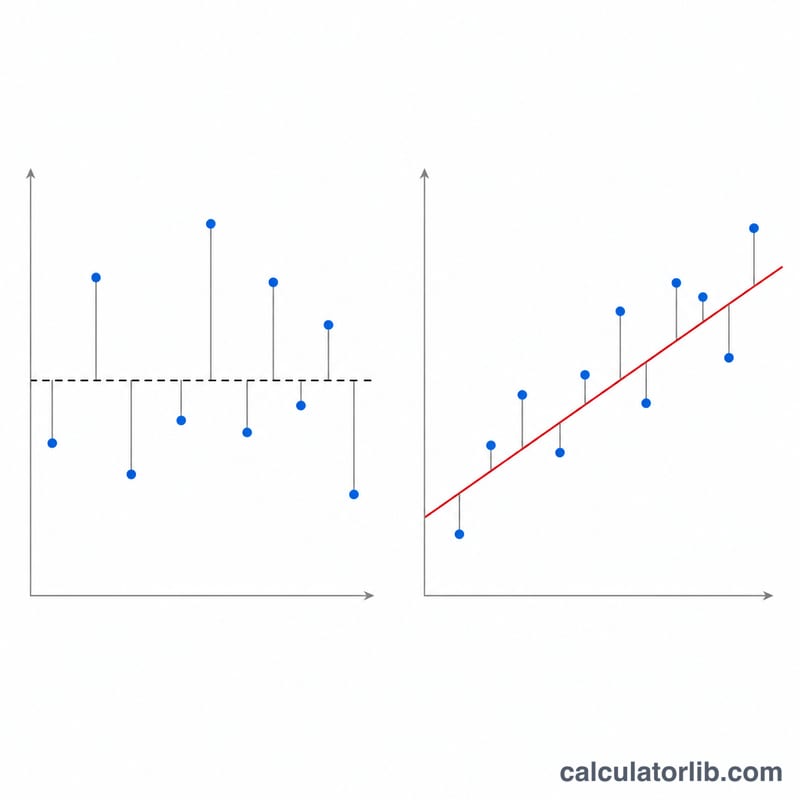
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$ Aquí, \(SS_{res} = \sum (y_i - \hat{y}_i)^2\) recoge el error que queda tras las predicciones del modelo, mientras que \(SS_{tot} = \sum (y_i - \bar{y})^2\) recoge la variabilidad total de los datos respecto a su propia media. Al dividir una entre otra obtienes qué fracción de la variabilidad no logró explicar el modelo; al restar ese cociente de 1, obtienes la fracción que sí explicó.
Ejemplo resuelto
Reales = [3, −0,5, 2, 7], Predichos = [2,5, 0,0, 2, 8]. Media de los reales = 2,875. $$SS_{res} = 0{,}5^2 + 0{,}5^2 + 0^2 + 1^2 = 0{,}25 + 0{,}25 + 0 + 1 = 1{,}5$$ $$SS_{tot} = (0{,}125)^2 + (3{,}375)^2 + (0{,}875)^2 + (4{,}125)^2 \approx 0{,}0156 + 11{,}3906 + 0{,}7656 + 17{,}0156 = 29{,}1875$$ $$R^{2} = 1 - \frac{1{,}5}{29{,}1875} \approx 0{,}9486$$ así que el modelo explica alrededor del 94,9 % de la varianza.
Interpretación de tu valor de R²
R² (el coeficiente de determinación) compara los errores al cuadrado de tu modelo con los errores al cuadrado de una línea base simple que siempre predice la media de los valores reales: \(R^2 = 1 - SS_{res}/SS_{tot}\). Multiplicado por 100, es la proporción de la varianza de los valores reales que explican las predicciones.
| R² | Qué indica |
|---|---|
| 1.0 | Las predicciones coinciden exactamente con cada valor real (SSres = 0). Se explica el 100% de la varianza. |
| 0.9 | Se explica aproximadamente el 90% de la varianza. Es un ajuste sólido. |
| 0.7 | Aproximadamente el 70% explicado. Es un ajuste considerable, con dispersión no explicada notable. |
| 0.5 | Aproximadamente la mitad de la varianza está explicada y la otra mitad no. |
| 0.3 | Aproximadamente el 30% explicado. Es un ajuste débil, aunque puede seguir siendo significativo en campos con mucho ruido. |
| 0.0 | El modelo no hace nada mejor que predecir la media en todos los casos (SSres = SStot). |
| Por debajo de 0 | El modelo es peor que la línea base de la media (SSres > SStot). |
¿Qué se considera un buen R²?
No existe un umbral universal. En las ciencias físicas y la ingeniería, donde las mediciones están controladas y las relaciones son casi determinísticas, a menudo se esperan valores superiores a 0.9. En las ciencias sociales, la investigación del comportamiento, la economía y muchos estudios biológicos, los resultados están impulsados por numerosos factores no medidos, por lo que un R² de 0.2 a 0.5 aún puede ser útil. Evalúa el valor según las normas de tu campo y el propósito del modelo.
Advertencias importantes
- No es causalidad: un R² alto muestra que las predicciones siguen los datos, no que las entradas causen el resultado.
- No es sesgo: un modelo puede tener un R² alto y, aun así, desviarse sistemáticamente en algunos rangos. Revisa los gráficos de residuos.
- No es sobreajuste: el R² calculado con los datos usados para ajustar un modelo tiende a aumentar al añadir predictores, incluso inútiles. Evalúa con datos de prueba reservados siempre que sea posible.
- El R² ajustado penaliza los predictores adicionales, por lo que es más adecuado para comparar modelos con distinto número de variables.
- Los valores negativos son posibles siempre que las predicciones provengan de algo distinto de un ajuste de mínimos cuadrados a los mismos datos, por ejemplo, un modelo aplicado a datos nuevos.
R² en distintos escenarios de ajuste
Los cuatro escenarios usan los mismos valores reales, y = 2, 4, 6, 8, 10. Su media es \(\bar{y} = 30/5 = 6\), por lo que \(SS_{tot} = (2-6)^2 + (4-6)^2 + (6-6)^2 + (8-6)^2 + (10-6)^2 = 16 + 4 + 0 + 4 + 16 = 40\) en todos los casos. Solo cambian las predicciones.
| Escenario | y real | ŷ predicho | SSres | SStot | R² | Descripción |
|---|---|---|---|---|---|---|
| Ajuste perfecto | 2, 4, 6, 8, 10 | 2, 4, 6, 8, 10 | 0 | 40 | 1 | Todos los residuos son cero, por lo que se explica toda la varianza. |
| Buen ajuste | 2, 4, 6, 8, 10 | 3, 4, 6, 7, 10 | 2 | 40 | 0.95 | Pequeños errores de ±1 en dos puntos. Se explica el 95% de la varianza. |
| Solo la media | 2, 4, 6, 8, 10 | 6, 6, 6, 6, 6 | 40 | 40 | 0 | Predecir siempre la media da exactamente la línea base, por lo que R² = 0. |
| Peor que la media | 2, 4, 6, 8, 10 | 10, 8, 6, 4, 2 | 160 | 40 | -3 | Las predicciones van en la dirección opuesta, por lo que los errores son mayores que los de la línea base. |
Comprobación aritmética
- Buen ajuste: los residuos son -1, 0, 0, 1, 0, por lo que \(SS_{res} = 1 + 0 + 0 + 1 + 0 = 2\) y \(R^2 = 1 - 2/40 = 0.95\).
- Solo la media: los residuos son -4, -2, 0, 2, 4, por lo que \(SS_{res} = 16 + 4 + 0 + 4 + 16 = 40\) y \(R^2 = 1 - 40/40 = 0\).
- Peor que la media: los residuos son -8, -4, 0, 4, 8, por lo que \(SS_{res} = 64 + 16 + 0 + 16 + 64 = 160\) y \(R^2 = 1 - 160/40 = -3\).
Términos y símbolos clave
- R² (coeficiente de determinación)
- La proporción de la varianza de los valores reales que explican las predicciones, \(R^2 = 1 - SS_{res}/SS_{tot}\). Es como máximo 1 y puede ser negativo.
- SSres (suma residual de cuadrados)
- La suma de las diferencias al cuadrado entre los valores reales y los predichos, \(\sum (y - \hat{y})^2\). Mide el error que el modelo deja sin explicar.
- SStot (suma total de cuadrados)
- La suma de las diferencias al cuadrado entre cada valor real y la media, \(\sum (y - \bar{y})^2\). Mide la variación total de los datos.
- SSreg (suma de cuadrados explicada o de la regresión)
- La variación que captura el modelo, \(\sum (\hat{y} - \bar{y})^2\). En un ajuste de mínimos cuadrados ordinarios con intercepto, \(SS_{tot} = SS_{reg} + SS_{res}\), por lo que \(R^2 = SS_{reg}/SS_{tot}\). Esta identidad no se cumple para predicciones arbitrarias.
- Residuo
- El error de una observación, \(y - \hat{y}\): valor real menos valor predicho.
- Media de los valores reales (ȳ)
- El promedio de los valores reales, \(\bar{y} = \frac{1}{n}\sum y\). Es la predicción de referencia con la que se mide el R².
- Valor predicho (ŷ)
- El valor que tu modelo genera para una observación.
- R² ajustado
- Una versión del R² que penaliza el número de predictores p para una muestra de tamaño n: $$R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}$$ Puede disminuir cuando un predictor añadido no mejora lo suficiente el ajuste.
- R² frente a r de Pearson
- La r de Pearson mide la intensidad y la dirección (de -1 a 1) de la asociación lineal entre dos variables. En la regresión lineal simple con intercepto, R² es igual a r². El R² tal como se calcula aquí compara cualquier conjunto de predicciones con los valores reales, por lo que puede ser negativo, mientras que r² no puede serlo.
Preguntas frecuentes
¿Puede el \(R^{2}\) ser negativo? Sí. Si tus predicciones son peores que limitarse a adivinar la media en cada caso, el \(SS_{res}\) supera al \(SS_{tot}\) y el \(R^{2}\) se vuelve negativo.
¿Un \(R^{2}\) alto significa que el modelo es bueno? No siempre. El \(R^{2}\) puede inflarse por sobreajuste (overfitting) o al añadir predictores irrelevantes. Conviene revisarlo siempre junto con los gráficos de residuos y el rendimiento con datos fuera de la muestra.
¿Cuál es la diferencia entre el \(R^{2}\) y la correlación? En la regresión lineal simple, el \(R^{2}\) es igual al cuadrado del coeficiente de correlación de Pearson (\(r\)) entre los valores reales y los predichos.