Belirleme Katsayısı (R²) Nedir?
R² olarak gösterilen belirleme katsayısı, bir modelin tahminlerinin gerçek gözlem verileriyle ne kadar uyumlu olduğunu ölçer. Bağımlı değişkendeki varyansın model tarafından açıklanan oranını ifade eder. R² değeri, tahminlerin gerçek değerlerle birebir örtüştüğü mükemmel uyumu gösteren 1'den, modelin yalnızca ortalamayı tahmin etmekten daha iyi olmadığını gösteren 0'a kadar uzanır; model, ortalama temel çizgisinden daha kötü performans gösterdiğinde negatif değerler bile alabilir.
Bu Aracı Nasıl Kullanırsınız?
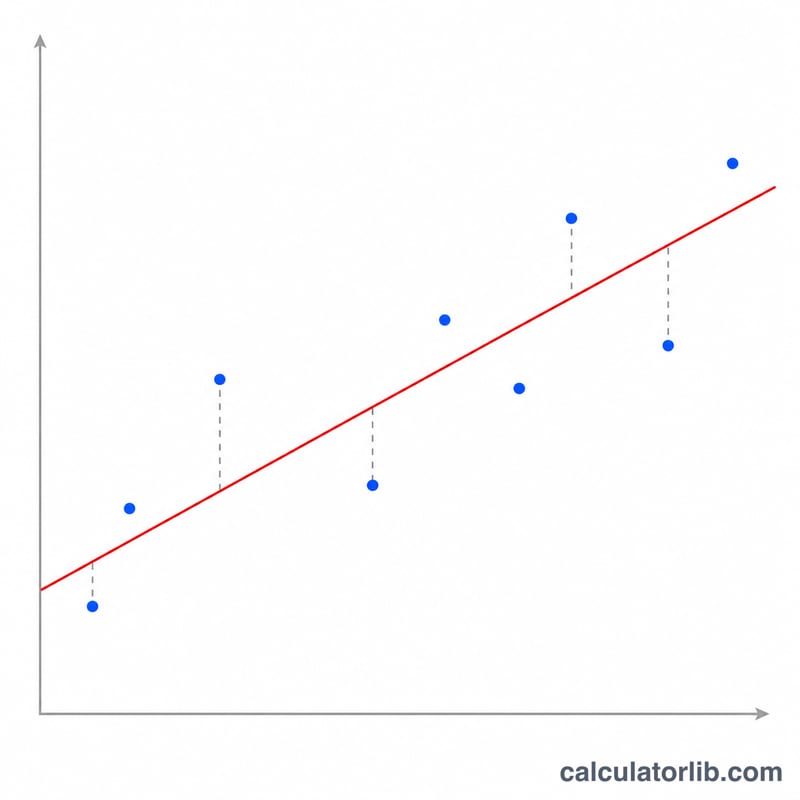
Gerçek gözlem değerlerinizi (\(y\)) ve bunlara karşılık gelen tahmini değerleri (\(\hat{y}\)) aynı sırada, virgülle ayrılmış sayılar olarak girin. Araç, bu değerleri eşleştirir, gerçek değerlerin ortalamasını hesaplar ve ardından kalıntı kareler toplamı (\(SS_{res}\)) ile toplam kareler toplamını (\(SS_{tot}\)) elde ederek R² değerini ve açıklanan varyans yüzdesini döndürür.
Formülün Açıklaması
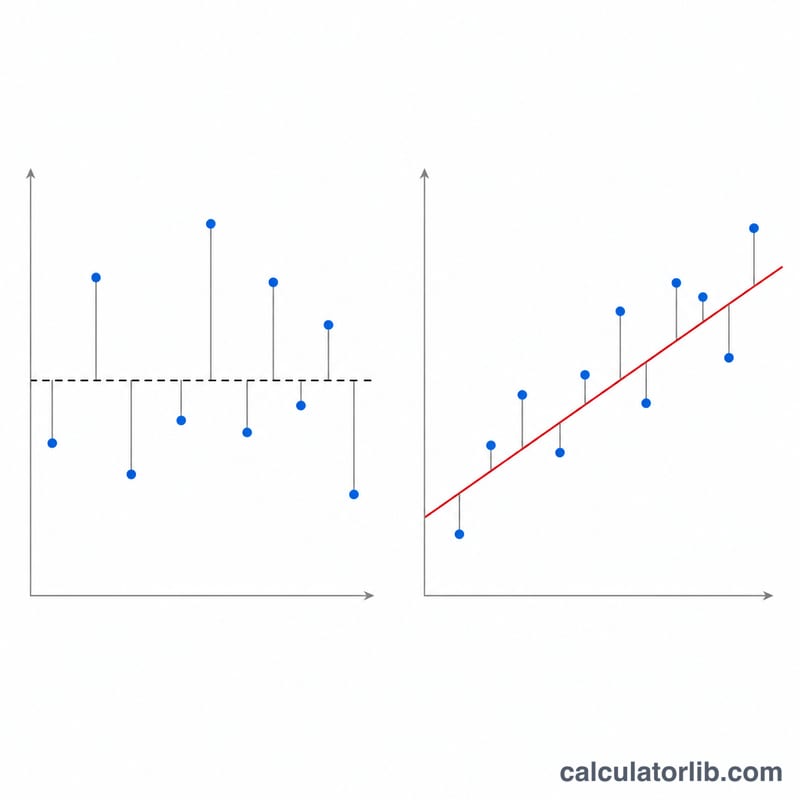
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$ Burada \(SS_{res} = \sum (y_i - \hat{y}_i)^2\), modelin tahminlerinden sonra geriye kalan hatayı; \(SS_{tot} = \sum (y_i - \bar{y})^2\) ise verilerin kendi ortalaması etrafındaki toplam değişkenliğini ifade eder. Birinin diğerine bölünmesi, modelin açıklayamadığı değişkenlik oranını gösterir; bunu 1'den çıkarmak ise açıkladığı oranı verir.
Çözümlü Örnek
Gerçek = [3, −0,5, 2, 7], Tahmini = [2,5, 0,0, 2, 8]. Gerçek değerlerin ortalaması = \(2{,}875\). $$SS_{res} = 0{,}5^2 + 0{,}5^2 + 0^2 + 1^2 = 0{,}25 + 0{,}25 + 0 + 1 = 1{,}5$$ $$SS_{tot} = (0{,}125)^2 + (3{,}375)^2 + (0{,}875)^2 + (4{,}125)^2 \approx 0{,}0156 + 11{,}3906 + 0{,}7656 + 17{,}0156 = 29{,}1875$$ $$R^{2} = 1 - \frac{1{,}5}{29{,}1875} \approx 0{,}9486$$ yani model varyansın yaklaşık %94,9'unu açıklar.
R² Değerinizi Yorumlama
R² (belirleyicilik katsayısı), modelinizin kare hatalarını, gerçek değerlerin ortalamasını her zaman tahmin eden basit bir temel modelin kare hatalarıyla karşılaştırır: \(R^2 = 1 - SS_{res}/SS_{tot}\). 100 ile çarpıldığında, tahminlerin açıkladığı, gerçek değerlerdeki varyansın payını verir.
| R² | Neyi gösterir |
|---|---|
| 1.0 | Tahminler her gerçek değerle tam olarak eşleşir (SSres = 0). Varyansın %100'ü açıklanmıştır. |
| 0.9 | Varyansın yaklaşık %90'ı açıklanmıştır. Bu güçlü bir uyumdur. |
| 0.7 | Yaklaşık %70 açıklanmıştır. Bu, belirgin açıklanamayan dağılımın olduğu önemli bir uyumdur. |
| 0.5 | Varyansın yaklaşık yarısı açıklanmış, yarısı açıklanamamıştır. |
| 0.3 | Yaklaşık %30 açıklanmıştır. Bu zayıf bir uyumdur, ancak gürültülü alanlarda yine de anlamlı olabilir. |
| 0.0 | Model, her seferinde ortalamayı tahmin etmekten daha iyi bir sonuç vermez (SSres = SStot). |
| 0 altı | Model, ortalama temel modelinden daha kötüdür (SSres > SStot). |
İyi bir R² neyi ifade eder?
Evrensel bir eşik yoktur. Ölçümlerin kontrollü olduğu ve ilişkilerin neredeyse deterministik olduğu fizik bilimlerinde ve mühendislikte 0,9'un üzerindeki değerler genellikle beklenir. Sosyal bilimlerde, davranış araştırmalarında, ekonomide ve birçok biyolojik çalışmada sonuçlar çok sayıda ölçülmemiş faktörden etkilendiğinden, 0,2 ile 0,5 arasındaki bir R² yine de faydalı olabilir. Değeri, alanınızın normlarına ve modelin amacına göre değerlendirin.
Önemli uyarılar
- Nedensellik değildir: yüksek bir R², tahminlerin verileri izlediğini gösterir; girdilerin sonucu neden olduğunu göstermez.
- Yanlılık değildir: bir model yüksek R²'ye sahip olabilir ve yine de bazı aralıklarda sistematik olarak sapabilir. Artık grafiklerini kontrol edin.
- Aşırı uyum değildir: modeli uydurmak için kullanılan veri üzerinde hesaplanan R², işe yaramaz olanlar dahil, değişken eklendikçe artma eğilimindedir. Mümkünse ayrılmış veriler üzerinde değerlendirin.
- Düzeltilmiş R², ek tahmin edicileri cezalandırır; bu nedenle farklı sayıda değişkene sahip modelleri karşılaştırmak için daha uygundur.
- Tahminler, aynı verilere yapılan en küçük kareler uyumu dışındaki bir yöntemden geldiğinde negatif değerler mümkündür; örneğin yeni verilere uygulanan bir model.
Farklı Uyum Senaryolarında R²
Dört senaryonun tamamı aynı gerçek değerleri kullanır: y = 2, 4, 6, 8, 10. Ortalamaları \(\bar{y} = 30/5 = 6\) olduğundan, her durumda \(SS_{tot} = (2-6)^2 + (4-6)^2 + (6-6)^2 + (8-6)^2 + (10-6)^2 = 16 + 4 + 0 + 4 + 16 = 40\) olur. Yalnızca tahminler değişir.
| Senaryo | Gerçek y | Tahmin ŷ | SSres | SStot | R² | Açıklama |
|---|---|---|---|---|---|---|
| Mükemmel uyum | 2, 4, 6, 8, 10 | 2, 4, 6, 8, 10 | 0 | 40 | 1 | Her artık sıfırdır, dolayısıyla varyansın tamamı açıklanmıştır. |
| İyi uyum | 2, 4, 6, 8, 10 | 3, 4, 6, 7, 10 | 2 | 40 | 0.95 | İki noktada ±1'lik küçük hatalar. Varyansın %95'i açıklanmıştır. |
| Yalnızca ortalama | 2, 4, 6, 8, 10 | 6, 6, 6, 6, 6 | 40 | 40 | 0 | Her zaman ortalamayı tahmin etmek tam olarak temel modeli verir, dolayısıyla R² = 0'dır. |
| Ortalamadan daha kötü | 2, 4, 6, 8, 10 | 10, 8, 6, 4, 2 | 160 | 40 | -3 | Tahminler ters yönde ilerler, dolayısıyla hatalar temel modelin hatalarından daha büyüktür. |
Aritmetik kontrolü
- İyi uyum: artıklar -1, 0, 0, 1, 0'dır, dolayısıyla \(SS_{res} = 1 + 0 + 0 + 1 + 0 = 2\) ve \(R^2 = 1 - 2/40 = 0.95\).
- Yalnızca ortalama: artıklar -4, -2, 0, 2, 4'tür, dolayısıyla \(SS_{res} = 16 + 4 + 0 + 4 + 16 = 40\) ve \(R^2 = 1 - 40/40 = 0\).
- Ortalamadan daha kötü: artıklar -8, -4, 0, 4, 8'dir, dolayısıyla \(SS_{res} = 64 + 16 + 0 + 16 + 64 = 160\) ve \(R^2 = 1 - 160/40 = -3\).
Temel Terimler ve Semboller
- R² (belirleyicilik katsayısı)
- Gerçek değerlerdeki varyansın, tahminler tarafından açıklanan oranı, \(R^2 = 1 - SS_{res}/SS_{tot}\). En fazla 1'dir ve negatif olabilir.
- SSres (artık kareler toplamı)
- Gerçek ve tahmin edilen değerler arasındaki farkların karelerinin toplamı, \(\sum (y - \hat{y})^2\). Modelin açıklayamadığı hatayı ölçer.
- SStot (toplam kareler toplamı)
- Her gerçek değer ile ortalama arasındaki farkların karelerinin toplamı, \(\sum (y - \bar{y})^2\). Verideki toplam değişimi ölçer.
- SSreg (açıklanan veya regresyon kareler toplamı)
- Modelin yakaladığı değişim, \(\sum (\hat{y} - \bar{y})^2\). Sabit terimli sıradan en küçük kareler uyumunda \(SS_{tot} = SS_{reg} + SS_{res}\) olduğundan \(R^2 = SS_{reg}/SS_{tot}\)'dir. Bu özdeşlik rastgele tahminler için geçerli değildir.
- Artık
- Tek bir gözlem için hata, \(y - \hat{y}\): gerçek eksi tahmin edilen.
- Gerçek değerlerin ortalaması (ȳ)
- Gerçek değerlerin ortalaması, \(\bar{y} = \frac{1}{n}\sum y\). R²'nin ölçüldüğü temel tahmindir.
- Tahmin edilen değer (ŷ)
- Modelinizin bir gözlem için ürettiği değer.
- Düzeltilmiş R²
- n büyüklüğündeki bir örnek için p tahmin edici sayısını cezalandıran R² sürümü: $$R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}$$ Eklenen bir tahmin edici uyumu yeterince iyileştirmediğinde düşebilir.
- R² ile Pearson r karşılaştırması
- Pearson r, iki değişken arasındaki doğrusal ilişkinin gücünü ve yönünü (-1 ile 1 arası) ölçer. Sabit terimli basit doğrusal regresyonda R², r²'ye eşittir. Burada hesaplanan R², herhangi bir tahmin kümesini gerçek değerlerle karşılaştırdığı için negatif olabilir; r² ise negatif olamaz.
Sıkça Sorulan Sorular
R² negatif olabilir mi? Evet. Tahminleriniz her seferinde ortalamayı tahmin etmekten daha kötüyse, \(SS_{res}\) değeri \(SS_{tot}\)'u aşar ve R² negatif olur.
Yüksek R² iyi bir model anlamına gelir mi? Her zaman değil. R², aşırı uyum (overfitting) nedeniyle ya da ilgisiz değişkenler eklenerek yapay olarak yükseltilebilir. R² değerini daima kalıntı grafikleri ve örneklem dışı performansla birlikte değerlendirin.
R² ile korelasyon arasındaki fark nedir? Basit doğrusal regresyonda R², gerçek ve tahmini değerler arasındaki Pearson korelasyon katsayısının (\(r\)) karesine eşittir.