Что такое коэффициент детерминации (R²)?
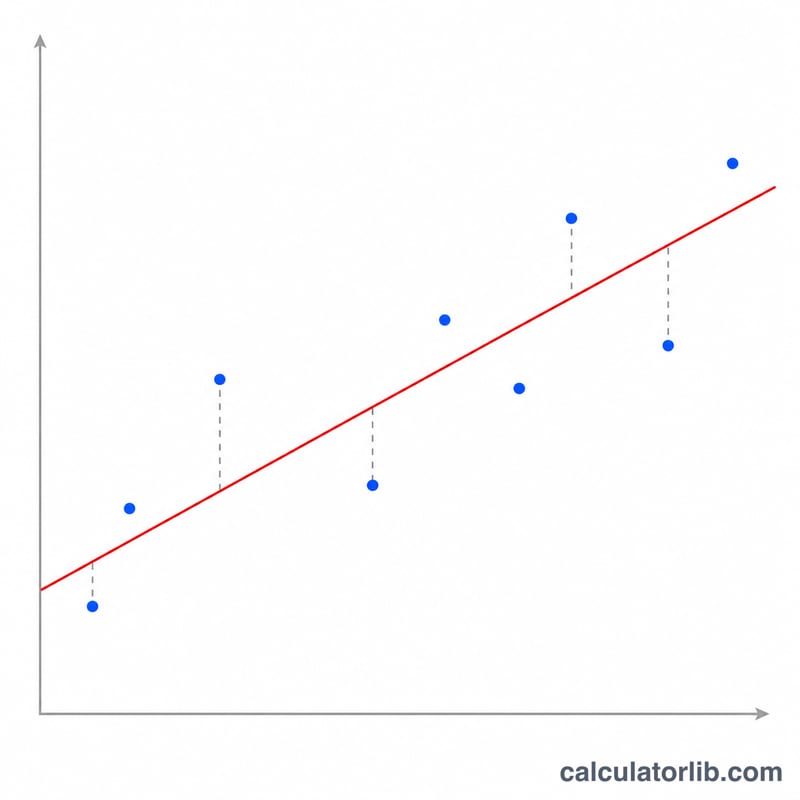
Коэффициент детерминации, который обозначают как \(R^{2}\), показывает, насколько хорошо прогнозы модели соответствуют реальным наблюдаемым данным. Это доля дисперсии зависимой переменной, которую объясняет модель. Значение \(R^{2}\) находится в диапазоне от 1 (идеальное совпадение, когда прогнозы в точности равны фактическим значениям) до 0 (модель работает не лучше, чем простое предсказание среднего) и может даже стать отрицательным, если модель проигрывает базовому прогнозу по среднему.
Как пользоваться калькулятором
Введите список фактических наблюдаемых значений (y) и соответствующий список прогнозных значений (ŷ) — каждый набор как числа через запятую и в одном и том же порядке. Калькулятор сопоставит пары, вычислит среднее фактических значений, а затем найдёт остаточную сумму квадратов (\(SS_{res}\)) и общую сумму квадратов (\(SS_{tot}\)), чтобы выдать \(R^{2}\) и процент объяснённой дисперсии.
Разбор формулы
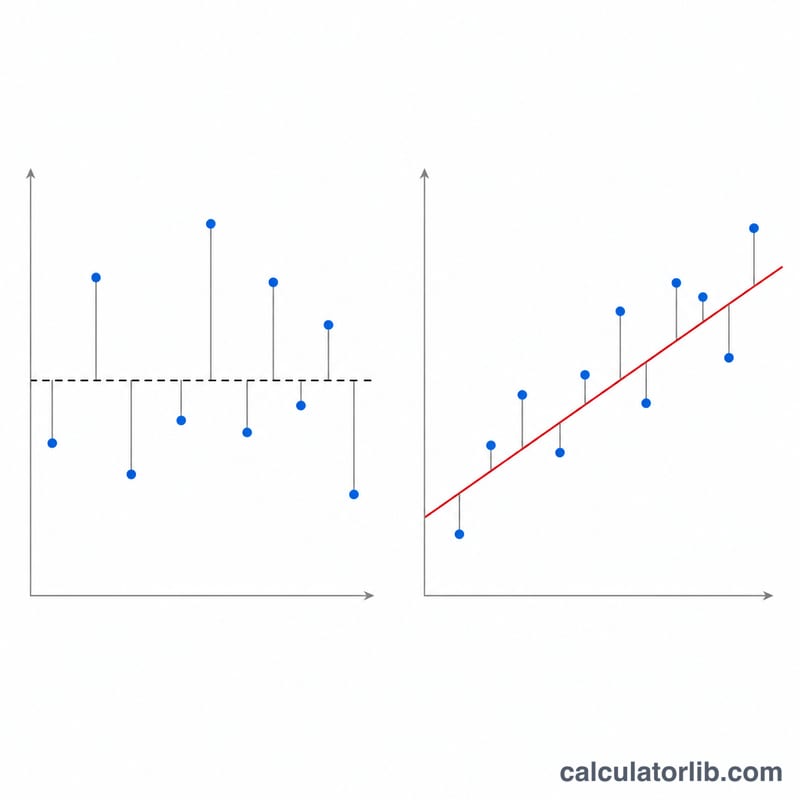
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$ Здесь \(SS_{res} = \sum (y_i - \hat{y}_i)^{2}\) отражает ошибку, которая остаётся после прогнозов модели, а \(SS_{tot} = \sum (y_i - \bar{y})^{2}\) — общий разброс данных вокруг их собственного среднего. Деление одного на другое показывает, какую часть изменчивости модель объяснить не смогла; вычитание из единицы даёт ту долю, которую она всё-таки объяснила.
Пример расчёта
Фактические = [3, −0,5, 2, 7], прогнозные = [2,5, 0,0, 2, 8]. Среднее фактических = 2,875. $$SS_{res} = 0{,}5^{2} + 0{,}5^{2} + 0^{2} + 1^{2} = 0{,}25 + 0{,}25 + 0 + 1 = 1{,}5$$ $$SS_{tot} = (0{,}125)^{2} + (3{,}375)^{2} + (0{,}875)^{2} + (4{,}125)^{2} \approx 0{,}0156 + 11{,}3906 + 0{,}7656 + 17{,}0156 = 29{,}1875$$ $$R^{2} = 1 - \frac{1{,}5}{29{,}1875} \approx 0{,}9486$$ то есть модель объясняет примерно 94,9 % дисперсии.
Частые вопросы
Может ли \(R^{2}\) быть отрицательным? Да. Если прогнозы хуже, чем если бы вы каждый раз просто угадывали среднее, то \(SS_{res}\) превышает \(SS_{tot}\), и \(R^{2}\) становится отрицательным.
Высокий \(R^{2}\) всегда означает хорошую модель? Не всегда — \(R^{2}\) можно «раздуть» переобучением или добавлением лишних предикторов. Оценивайте его вместе с графиками остатков и качеством на новых данных вне выборки.
Чем \(R^{2}\) отличается от корреляции? Для простой линейной регрессии \(R^{2}\) равен квадрату коэффициента корреляции Пирсона (\(r\)) между фактическими и прогнозными значениями.