निर्धारण गुणांक (R²) क्या है?
निर्धारण गुणांक, जिसे R² लिखा जाता है, यह मापता है कि किसी मॉडल के पूर्वानुमान असल में देखे गए डेटा से कितनी अच्छी तरह मेल खाते हैं। आसान शब्दों में, यह आश्रित चर (dependent variable) के उस विचरण (variance) का अनुपात बताता है जिसे मॉडल समझा पाता है। R² का मान 1 (एकदम सटीक फ़िट, जहाँ पूर्वानुमान बिल्कुल वास्तविक मानों के बराबर हों) से लेकर 0 (जहाँ मॉडल केवल औसत का अनुमान लगाने से बेहतर नहीं) तक होता है। जब कोई मॉडल औसत (mean) के आधार बिंदु से भी ख़राब प्रदर्शन करता है, तो यह ऋणात्मक (negative) तक हो सकता है।
इस कैलकुलेटर का उपयोग कैसे करें
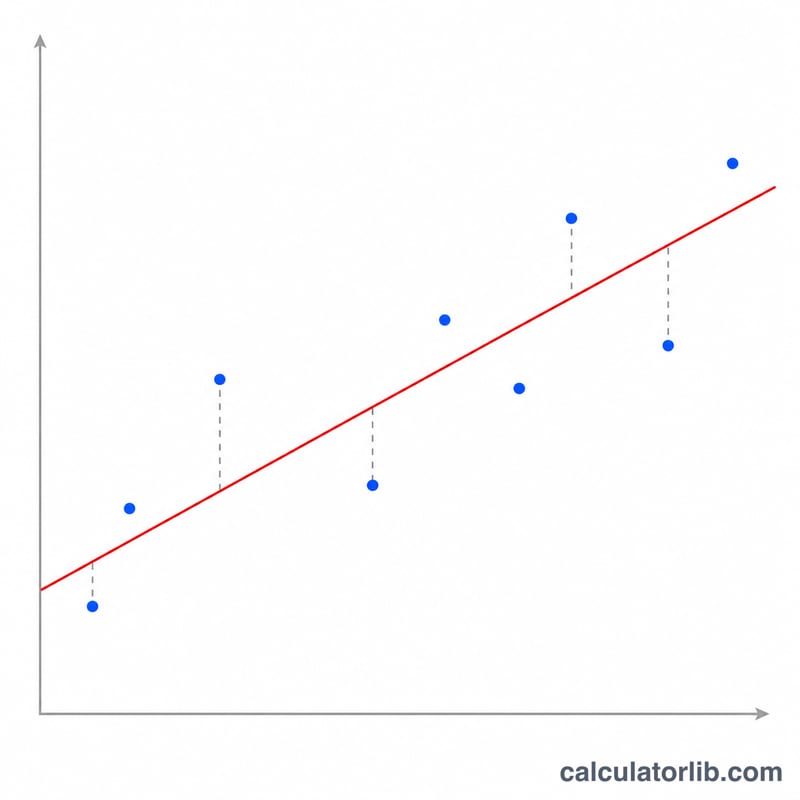
अपने वास्तविक देखे गए मानों (y) की सूची और उनसे मेल खाते पूर्वानुमानित मानों (ŷ) की सूची दर्ज करें — दोनों को एक ही क्रम में, कॉमा से अलग की गई संख्याओं के रूप में लिखें। कैलकुलेटर इन्हें आपस में जोड़ता है, वास्तविक मानों का औसत निकालता है, फिर अवशिष्ट वर्ग योग (SSres) और कुल वर्ग योग (SStot) की गणना करके R² और समझाए गए विचरण का प्रतिशत लौटाता है।
सूत्र को समझें
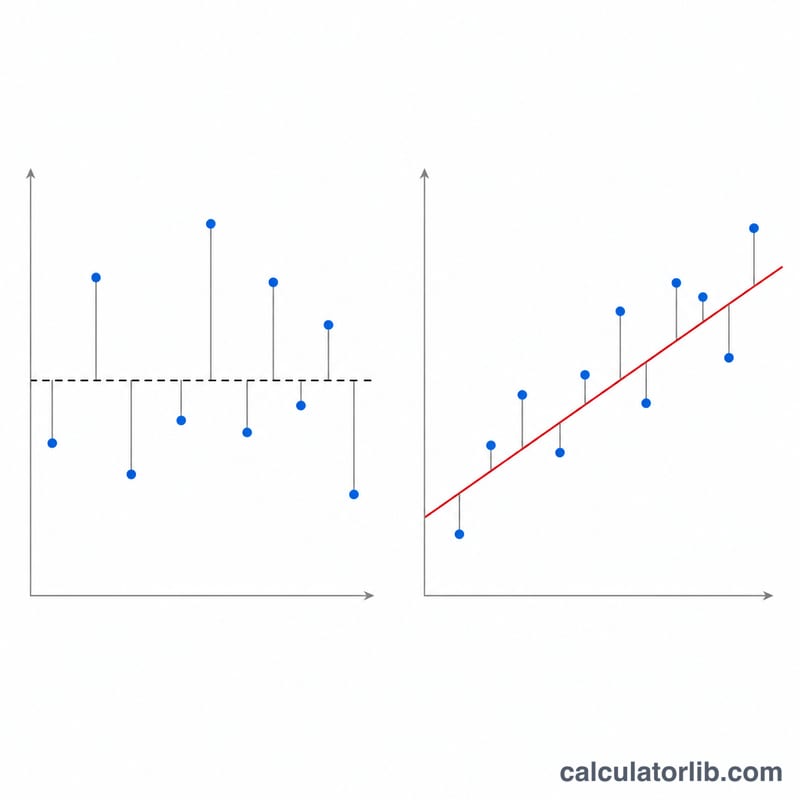
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$ यहाँ \(SS_{res} = \sum (y_i - \hat{y}_i)^2\) मॉडल के पूर्वानुमानों के बाद बची हुई त्रुटि को दर्शाता है, जबकि \(SS_{tot} = \sum (y_i - \bar{y})^2\) डेटा की अपने ही औसत के इर्द-गिर्द कुल परिवर्तनशीलता को दर्शाता है। एक को दूसरे से भाग देने पर पता चलता है कि मॉडल परिवर्तनशीलता का कितना हिस्सा समझा नहीं पाया; इसे 1 से घटाने पर वह हिस्सा मिलता है जो मॉडल ने समझाया।
हल किया हुआ उदाहरण
वास्तविक = [3, −0.5, 2, 7], पूर्वानुमानित = [2.5, 0.0, 2, 8]। वास्तविक का औसत = 2.875। $$SS_{res} = 0.5^2 + 0.5^2 + 0^2 + 1^2 = 0.25 + 0.25 + 0 + 1 = 1.5$$ $$SS_{tot} = (0.125)^2 + (3.375)^2 + (0.875)^2 + (4.125)^2 \approx 0.0156 + 11.3906 + 0.7656 + 17.0156 = 29.1875$$ $$R^{2} = 1 - \frac{1.5}{29.1875} \approx 0.9486$$ यानी मॉडल लगभग 94.9% विचरण को समझाता है।
आपके R² मान की व्याख्या
R² (निर्धारण गुणांक) आपके मॉडल की वर्ग त्रुटियों की तुलना एक सरल आधार रेखा की वर्ग त्रुटियों से करता है, जो हमेशा वास्तविक मानों के माध्य का अनुमान लगाती है: \(R^2 = 1 - SS_{res}/SS_{tot}\)। इसे 100 से गुणा करने पर यह वास्तविक मानों के प्रसरण का वह हिस्सा मिलता है जिसे अनुमान समझाते हैं।
| R² | यह क्या दर्शाता है |
|---|---|
| 1.0 | अनुमान हर वास्तविक मान से बिल्कुल मेल खाते हैं (SSres = 0)। 100% प्रसरण समझाया गया है। |
| 0.9 | लगभग 90% प्रसरण समझाया गया है। यह एक मजबूत फिट है। |
| 0.7 | लगभग 70% समझाया गया। यह एक पर्याप्त फिट है, जिसमें ध्यान देने योग्य अव्याख्यात बिखराव है। |
| 0.5 | लगभग आधा प्रसरण समझाया गया है और आधा नहीं। |
| 0.3 | लगभग 30% समझाया गया। यह एक कमजोर फिट है, फिर भी शोरगुल वाले क्षेत्रों में यह सार्थक हो सकता है। |
| 0.0 | मॉडल हर बार माध्य का अनुमान लगाने से बेहतर प्रदर्शन नहीं करता (SSres = SStot)। |
| 0 से नीचे | मॉडल माध्य आधार रेखा से खराब है (SSres > SStot)। |
अच्छा R² किसे माना जाए?
कोई सार्वभौमिक सीमा नहीं है। भौतिक विज्ञान और इंजीनियरिंग में, जहाँ माप नियंत्रित होते हैं और संबंध लगभग निश्चित होते हैं, 0.9 से ऊपर के मान अक्सर अपेक्षित होते हैं। सामाजिक विज्ञान, व्यवहार अनुसंधान, अर्थशास्त्र और कई जैविक अध्ययनों में परिणाम कई अमापित कारकों से प्रभावित होते हैं, इसलिए 0.2 से 0.5 का R² भी उपयोगी हो सकता है। मान का मूल्यांकन अपने क्षेत्र के मानकों और मॉडल के उद्देश्य के आधार पर करें।
महत्वपूर्ण सावधानियाँ
- कारण नहीं: उच्च R² दर्शाता है कि अनुमान डेटा का अनुसरण करते हैं, यह नहीं कि इनपुट परिणाम का कारण हैं।
- पूर्वाग्रह नहीं: किसी मॉडल का R² उच्च हो सकता है और फिर भी कुछ सीमाओं में वह व्यवस्थित रूप से गलत हो सकता है। अवशेष (residual) ग्राफ़ जाँचें।
- ओवरफिटिंग नहीं: जिस डेटा पर मॉडल फिट किया गया है, उस पर निकाला गया R² नए चर जोड़ने पर बढ़ने लगता है, भले ही वे बेकार हों। जहाँ संभव हो, रोके गए (held-out) डेटा पर मूल्यांकन करें।
- समायोजित R² अतिरिक्त चरों पर दंड लगाता है, इसलिए अलग-अलग संख्या वाले चरों के मॉडलों की तुलना के लिए यह बेहतर है।
- नकारात्मक मान तब संभव हैं जब अनुमान उसी डेटा पर न्यूनतम-वर्ग फिट के अलावा किसी अन्य तरीके से आते हों, उदाहरण के लिए, नए डेटा पर लागू किया गया मॉडल।
विभिन्न फिट परिदृश्यों में R²
चारों परिदृश्य एक ही वास्तविक मानों का उपयोग करते हैं, y = 2, 4, 6, 8, 10। उनका माध्य \(\bar{y} = 30/5 = 6\) है, इसलिए हर स्थिति में \(SS_{tot} = (2-6)^2 + (4-6)^2 + (6-6)^2 + (8-6)^2 + (10-6)^2 = 16 + 4 + 0 + 4 + 16 = 40\) होता है। केवल अनुमान बदलते हैं।
| परिदृश्य | वास्तविक y | अनुमानित ŷ | SSres | SStot | R² | विवरण |
|---|---|---|---|---|---|---|
| पूर्ण फिट | 2, 4, 6, 8, 10 | 2, 4, 6, 8, 10 | 0 | 40 | 1 | हर अवशेष शून्य है, इसलिए सारा प्रसरण समझाया गया है। |
| अच्छा फिट | 2, 4, 6, 8, 10 | 3, 4, 6, 7, 10 | 2 | 40 | 0.95 | दो बिंदुओं पर ±1 की छोटी त्रुटियाँ। 95% प्रसरण समझाया गया है। |
| केवल माध्य | 2, 4, 6, 8, 10 | 6, 6, 6, 6, 6 | 40 | 40 | 0 | हमेशा माध्य का अनुमान लगाने से बिल्कुल आधार रेखा मिलती है, इसलिए R² = 0। |
| माध्य से खराब | 2, 4, 6, 8, 10 | 10, 8, 6, 4, 2 | 160 | 40 | -3 | अनुमान विपरीत दिशा में चलते हैं, इसलिए त्रुटियाँ आधार रेखा की त्रुटियों से बड़ी हैं। |
अंकगणितीय जाँच
- अच्छा फिट: अवशेष -1, 0, 0, 1, 0 हैं, इसलिए \(SS_{res} = 1 + 0 + 0 + 1 + 0 = 2\) और \(R^2 = 1 - 2/40 = 0.95\)।
- केवल माध्य: अवशेष -4, -2, 0, 2, 4 हैं, इसलिए \(SS_{res} = 16 + 4 + 0 + 4 + 16 = 40\) और \(R^2 = 1 - 40/40 = 0\)।
- माध्य से खराब: अवशेष -8, -4, 0, 4, 8 हैं, इसलिए \(SS_{res} = 64 + 16 + 0 + 16 + 64 = 160\) और \(R^2 = 1 - 160/40 = -3\)।
मुख्य शब्द और प्रतीक
- R² (निर्धारण गुणांक)
- वास्तविक मानों के प्रसरण का वह अनुपात जो अनुमानों द्वारा समझाया जाता है, \(R^2 = 1 - SS_{res}/SS_{tot}\)। यह अधिकतम 1 हो सकता है और नकारात्मक भी हो सकता है।
- SSres (अवशेष वर्ग योग)
- वास्तविक और अनुमानित मानों के बीच के अंतरों के वर्गों का योग, \(\sum (y - \hat{y})^2\)। यह मापता है कि मॉडल कितनी त्रुटि अव्याख्यात छोड़ता है।
- SStot (कुल वर्ग योग)
- हर वास्तविक मान और माध्य के बीच के अंतरों के वर्गों का योग, \(\sum (y - \bar{y})^2\)। यह डेटा में कुल भिन्नता मापता है।
- SSreg (समझाया गया या प्रतिगमन वर्ग योग)
- मॉडल द्वारा पकड़ी गई भिन्नता, \(\sum (\hat{y} - \bar{y})^2\)। अंतर्खंड (intercept) वाले साधारण न्यूनतम-वर्ग फिट के लिए, \(SS_{tot} = SS_{reg} + SS_{res}\), इसलिए \(R^2 = SS_{reg}/SS_{tot}\)। यह सर्वसमिका मनमाने अनुमानों के लिए लागू नहीं होती।
- अवशेष (Residual)
- एक प्रेक्षण के लिए त्रुटि, \(y - \hat{y}\): वास्तविक घटा अनुमानित।
- वास्तविक मानों का माध्य (ȳ)
- वास्तविक मानों का औसत, \(\bar{y} = \frac{1}{n}\sum y\)। यह वह आधार रेखा अनुमान है जिससे R² की तुलना की जाती है।
- अनुमानित मान (ŷ)
- किसी प्रेक्षण के लिए आपके मॉडल द्वारा दिया गया मान।
- समायोजित R² (Adjusted R²)
- R² का एक रूप जो नमूना आकार n के लिए प्रेडिक्टरों की संख्या p पर दंड लगाता है: $$R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}$$ जब कोई जोड़ा गया प्रेडिक्टर फिट में पर्याप्त सुधार नहीं करता, तो यह घट सकता है।
- R² बनाम पियर्सन r
- पियर्सन r दो चरों के बीच रैखिक संबंध की शक्ति और दिशा (-1 से 1) मापता है। अंतर्खंड वाले सरल रैखिक प्रतिगमन में, R² बराबर होता है r² के। यहाँ गणना किया गया R² किसी भी अनुमान समूह की वास्तविक मानों से तुलना करता है, इसलिए यह नकारात्मक हो सकता है, जबकि r² नहीं हो सकता।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
क्या R² ऋणात्मक हो सकता है? हाँ। अगर आपके पूर्वानुमान हर बार सिर्फ़ औसत का अनुमान लगाने से भी ख़राब हों, तो SSres, SStot से बड़ा हो जाता है और R² ऋणात्मक हो जाता है।
क्या ऊँचा R² अच्छे मॉडल का संकेत है? हमेशा नहीं — ओवरफिटिंग या ग़ैर-ज़रूरी पूर्वानुमानकर्ता (predictors) जोड़ने से R² बढ़ा-चढ़ा दिख सकता है। इसे हमेशा अवशिष्ट प्लॉट (residual plots) और सैंपल से बाहर के प्रदर्शन के साथ मिलाकर जाँचें।
R² और सहसंबंध (correlation) में क्या अंतर है? सरल रैखिक प्रतिगमन (simple linear regression) में, R² वास्तविक और पूर्वानुमानित मानों के बीच पियर्सन सहसंबंध गुणांक (r) के वर्ग के बराबर होता है।