什么是决定系数(R²)?
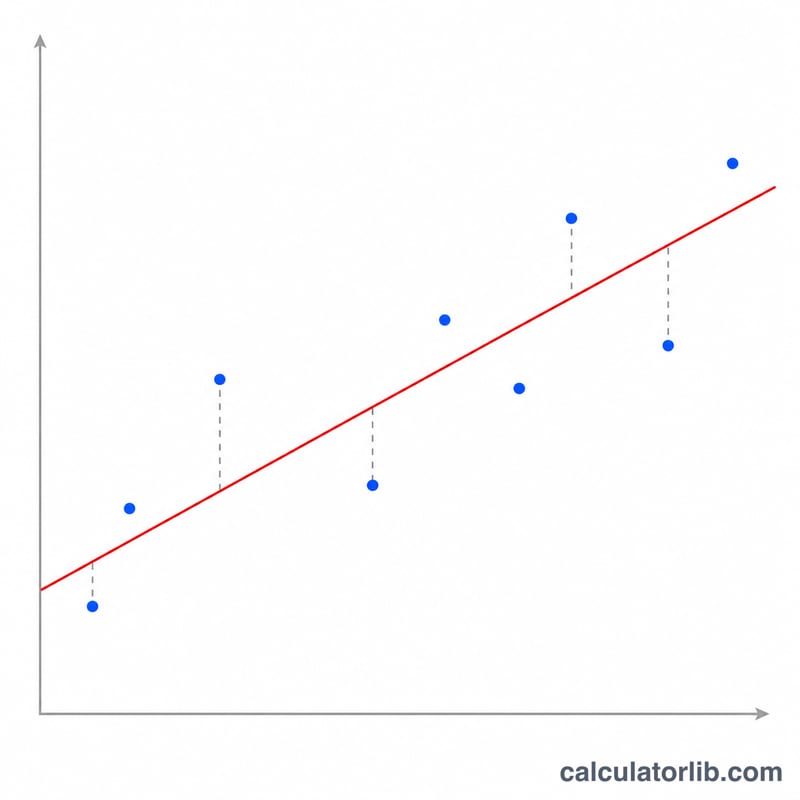
决定系数通常记作R²,用来衡量模型的预测值与实际观测数据的吻合程度。它表示因变量的方差中,能够被模型解释的那一部分所占的比例。R²的取值范围从1(完美拟合,即预测值与实际值完全一致)一直到0(此时模型并不比直接用均值预测更高明);当模型的表现比"用均值作基准"还要差时,R²甚至可能变为负数。
如何使用本计算器
请输入一组实际观测值(y)以及与之一一对应的预测值(ŷ),两者都用英文逗号分隔,且顺序必须保持一致。计算器会将它们逐一配对,先算出实际值的均值,再推导出残差平方和(SSres)与总平方和(SStot),最终给出R²以及模型所解释的方差百分比。
公式详解
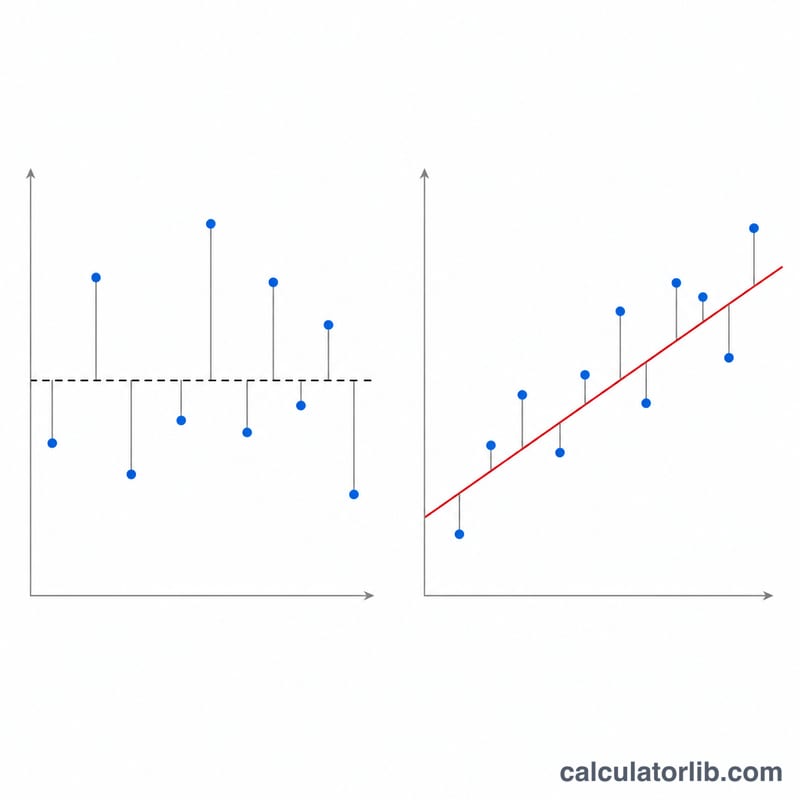
$$R^{2} = 1 - \frac{SS_{res}}{SS_{tot}}$$ 其中 \(SS_{res} = \sum (y_i - \hat{y}_i)^2\),代表模型预测之后仍然残留的误差;而 \(SS_{tot} = \sum (y_i - \bar{y})^2\),代表数据围绕自身均值的总体波动程度。用前者除以后者,得到的是模型"未能解释"的波动比例;再用1减去它,就得到了模型"成功解释"的波动比例。
实例演算
实际值 = [3, −0.5, 2, 7],预测值 = [2.5, 0.0, 2, 8]。实际值的均值 = 2.875。$$SS_{res} = 0.5^2 + 0.5^2 + 0^2 + 1^2 = 0.25 + 0.25 + 0 + 1 = 1.5$$ $$SS_{tot} = (0.125)^2 + (3.375)^2 + (0.875)^2 + (4.125)^2 \approx 0.0156 + 11.3906 + 0.7656 + 17.0156 = 29.1875$$ $$R^{2} = 1 - \frac{1.5}{29.1875} \approx 0.9486$$ 也就是说该模型解释了大约94.9%的方差。
解读你的 R² 值
R²(决定系数)将你的模型的平方误差与一个简单基线的平方误差进行比较,该基线始终预测实际值的均值:\(R^2 = 1 - SS_{res}/SS_{tot}\)。乘以 100 后,它表示预测结果所解释的实际值方差占比。
| R² | 含义 |
|---|---|
| 1.0 | 预测值与每个实际值完全一致(SSres = 0)。100% 的方差得到解释。 |
| 0.9 | 约 90% 的方差得到解释。拟合效果很好。 |
| 0.7 | 约 70% 得到解释。拟合效果较好,但仍存在明显的未解释离散。 |
| 0.5 | 约一半的方差得到解释,另一半未得到解释。 |
| 0.3 | 约 30% 得到解释。拟合效果较弱,但在噪声较大的领域仍可能有意义。 |
| 0.0 | 模型每次都预测均值,并不比这样做更好(SSres = SStot)。 |
| 低于 0 | 模型比均值基线更差(SSres > SStot)。 |
多大的 R² 才算好?
没有普遍适用的阈值。在物理科学和工程领域,测量受到严格控制,变量关系接近确定性,因此通常期望数值高于 0.9。在社会科学、行为研究、经济学以及许多生物学研究中,结果受大量未测量因素影响,因此 0.2 到 0.5 的 R² 仍可能有用。应结合你所在领域的惯例以及模型的用途来判断该数值。
重要注意事项
- 不等于因果关系:高 R² 只说明预测结果与数据吻合,并不说明输入变量导致了结果。
- 不等于无偏:模型的 R² 可能很高,但在某些取值范围内仍系统性地偏离。应检查残差图。
- 不等于没有过拟合:在拟合模型所用的数据上计算的 R² 往往会随着预测变量的增加而上升,即使这些变量毫无用处。如有可能,应在留出的数据上进行评估。
- 调整后 R²会对额外的预测变量进行惩罚,因此更适合比较变量数量不同的模型。
- 当预测结果来自与同一数据无关的最小二乘拟合之外的方法时(例如将模型应用于新数据),R² 可能为负值。
不同拟合情景下的 R²
四种情景使用相同的实际值 y = 2, 4, 6, 8, 10。它们的均值为 \(\bar{y} = 30/5 = 6\),因此在每种情况下 \(SS_{tot} = (2-6)^2 + (4-6)^2 + (6-6)^2 + (8-6)^2 + (10-6)^2 = 16 + 4 + 0 + 4 + 16 = 40\)。只有预测值发生变化。
| 情景 | 实际 y | 预测 ŷ | SSres | SStot | R² | 描述 |
|---|---|---|---|---|---|---|
| 完美拟合 | 2, 4, 6, 8, 10 | 2, 4, 6, 8, 10 | 0 | 40 | 1 | 每个残差均为零,因此所有方差都得到解释。 |
| 良好拟合 | 2, 4, 6, 8, 10 | 3, 4, 6, 7, 10 | 2 | 40 | 0.95 | 两个点上有 ±1 的小误差。95% 的方差得到解释。 |
| 仅均值 | 2, 4, 6, 8, 10 | 6, 6, 6, 6, 6 | 40 | 40 | 0 | 始终预测均值恰好得到基线结果,因此 R² = 0。 |
| 比均值更差 | 2, 4, 6, 8, 10 | 10, 8, 6, 4, 2 | 160 | 40 | -3 | 预测的变化方向与实际相反,因此误差大于基线的误差。 |
算术检验
- 良好拟合:残差为 -1, 0, 0, 1, 0,因此 \(SS_{res} = 1 + 0 + 0 + 1 + 0 = 2\),且 \(R^2 = 1 - 2/40 = 0.95\)。
- 仅均值:残差为 -4, -2, 0, 2, 4,因此 \(SS_{res} = 16 + 4 + 0 + 4 + 16 = 40\),且 \(R^2 = 1 - 40/40 = 0\)。
- 比均值更差:残差为 -8, -4, 0, 4, 8,因此 \(SS_{res} = 64 + 16 + 0 + 16 + 64 = 160\),且 \(R^2 = 1 - 160/40 = -3\)。
关键术语与符号
- R²(决定系数)
- 预测结果所解释的实际值方差比例,\(R^2 = 1 - SS_{res}/SS_{tot}\)。它至多为 1,并且可以为负值。
- SSres(残差平方和)
- 实际值与预测值之差的平方和,\(\sum (y - \hat{y})^2\)。它衡量模型未能解释的误差。
- SStot(总平方和)
- 每个实际值与均值之差的平方和,\(\sum (y - \bar{y})^2\)。它衡量数据中的总变异。
- SSreg(解释平方和或回归平方和)
- 模型所捕获的变异,\(\sum (\hat{y} - \bar{y})^2\)。对于带截距项的普通最小二乘拟合,\(SS_{tot} = SS_{reg} + SS_{res}\),因此 \(R^2 = SS_{reg}/SS_{tot}\)。这一恒等式对任意预测值并不成立。
- 残差
- 单个观测的误差,\(y - \hat{y}\):实际值减去预测值。
- 实际值的均值(ȳ)
- 实际值的平均数,\(\bar{y} = \frac{1}{n}\sum y\)。它是 R² 所比较的基线预测。
- 预测值(ŷ)
- 你的模型针对某个观测输出的值。
- 调整后 R²
- 对样本量为 n、预测变量数为 p 的情况下 R² 进行惩罚后的版本:$$R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}$$ 当新增的预测变量没有充分改善拟合时,它可能下降。
- R² 与皮尔逊 r
- 皮尔逊 r 衡量两个变量之间线性关联的强度和方向(-1 到 1)。在带截距项的简单线性回归中,R² 等于 r²。本文计算的 R² 是将任意一组预测值与实际值进行比较,因此可以为负值,而 r² 不能。
常见问题
R²会出现负值吗?会的。如果你的预测比每次都直接猜均值还要差,那么SSres就会大于SStot,R²随之变为负数。
R²越高就代表模型越好吗?不一定。R²可能因为过拟合,或因为加入了无关的预测变量而被"虚高"。务必同时结合残差图和样本外(out-of-sample)表现一起判断。
R²和相关系数有什么区别?在一元线性回归中,R²等于实际值与预测值之间皮尔逊相关系数(r)的平方。