ソフトマックス関数とは
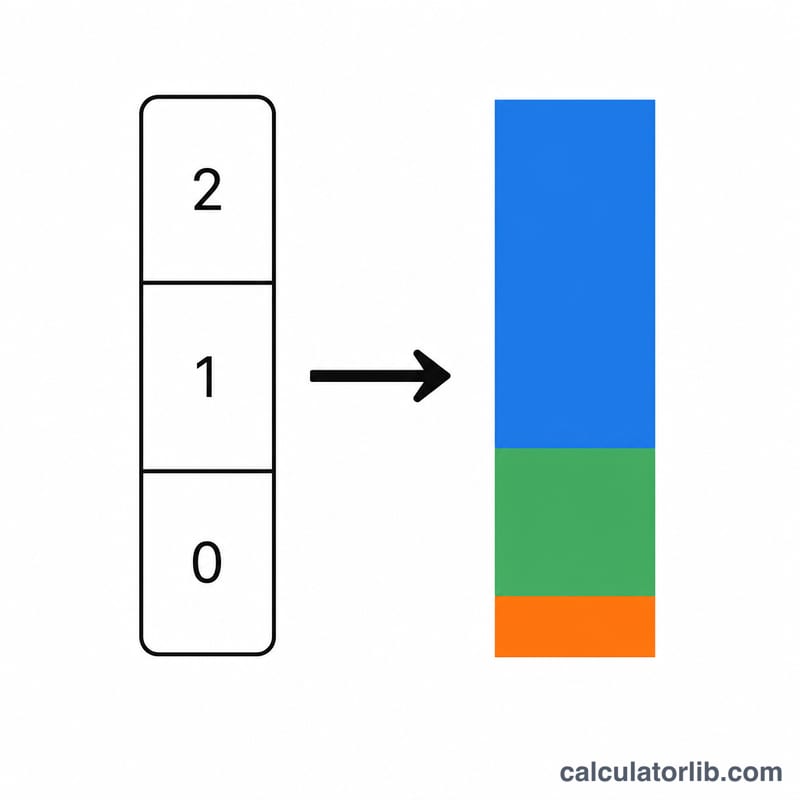
ソフトマックス関数は、K個の実数からなるベクトルを確率分布に変換する関数です。各出力値は必ず0より大きく1より小さい範囲に収まり、K個すべての出力の合計はちょうど1になります。ニューラルネットワークの分類モデルでは、出力層の標準的な活性化関数として用いられ、モデルの生のスコア(ロジット)をクラスごとの確率へと変換します。無次元の関数であるため、入力は単位を持たない純粋な数値です。
この計算機の使い方
入力欄に、カンマ・スペース・改行のいずれかで区切った数値のリストとして入力ベクトルを入力してください(例:1, 2, 3)。数値は正の数、負の数、ゼロ、小数のいずれでもかまいません。「計算」を押すと、各成分のソフトマックス確率、出力の合計(1になるはずです)、そしてargmax(最も確率が大きい成分の位置を示す1始まりのインデックス)が表示されます。
計算式の解説
各成分jについて、ソフトマックスは \(\sigma(z)_j = \dfrac{e^{z_j}}{\sum_k e^{z_k}}\) で定義されます。指数を取ることですべての項が正となり、合計で割って正規化することで総和が1になります。本計算機では数値的な安定性を確保するため、指数計算の前にすべての要素から最大値mを引いています:$$\sigma(z)_j = \frac{e^{\,z_j - m}}{\displaystyle\sum_{k} e^{\,z_k - m}}$$共通因子 \(e^{-m}\) は分子分母で打ち消し合うため、結果はまったく同じになりますが、大きな入力に対するオーバーフローを防ぐことができます。
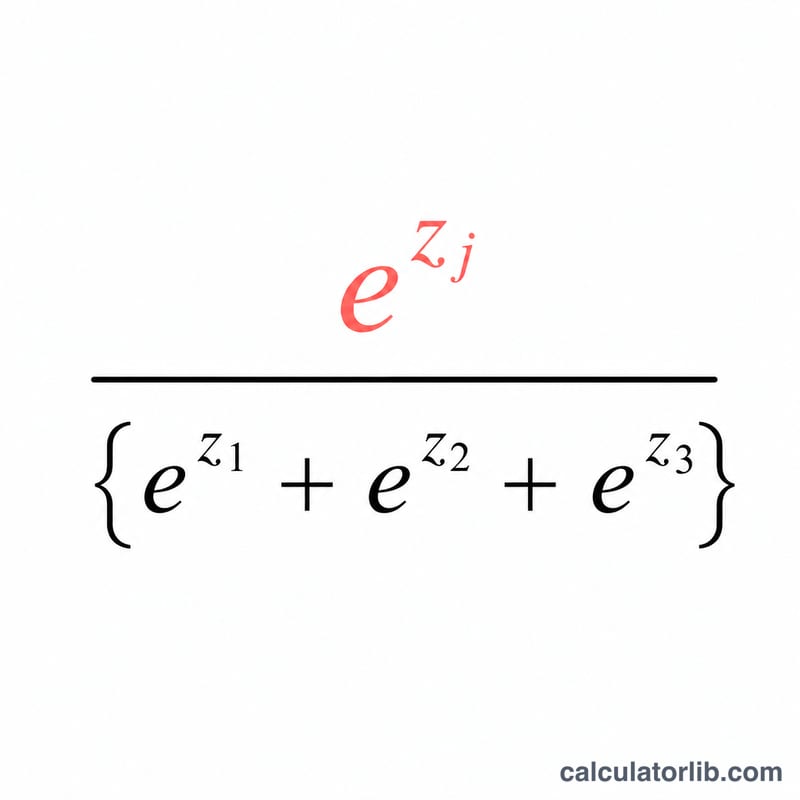
計算例
z = (1, 2, 3) の場合:\(e^{1} = 2.71828\)、\(e^{2} = 7.38906\)、\(e^{3} = 20.08554\) で、合計は \(30.19287\) となります。それぞれを合計で割ると \(\sigma = (0.09003, 0.24473, 0.66524)\) となり、足し合わせると1になります。argmaxはインデックス3で、これは最大の入力に対応し、確率は \(0.66524\) です。
異なる入力ベクトルに対するソフトマックス出力
この表は、次の式\(\sigma(\mathbf{x})_i = e^{x_i - \max(\mathbf{x})} / \sum_j e^{x_j - \max(\mathbf{x})}\)で計算したいくつかの入力ベクトルに対するソフトマックス出力を示しています。値は小数点以下4桁に丸めており、出力の合計は常に1になります。
| 入力ベクトル | ソフトマックス出力 | argmax(位置) | コメント |
|---|---|---|---|
| (1, 1, 1) | 0.3333, 0.3333, 0.3333 | 同順位(すべて等しい) | 入力がすべて等しいと、各1/3の一様分布になります。 |
| (1, 2, 3) | 0.0900, 0.2447, 0.6652 | 3番目 | 入力同士の差が1あるため、中程度に確信のある出力になります。 |
| (-1, 0, 1) | 0.0900, 0.2447, 0.6652 | 3番目 | 2だけ平行移動した同じベクトルなので、(1, 2, 3)と同一です。 |
| (0, 0, 5) | 0.0066, 0.0066, 0.9867 | 3番目 | 一つの大きな入力が支配的になり、等しい2つの入力が残りを均等に分け合います。 |
| (2, 4, 6) | 0.0159, 0.1173, 0.8668 | 3番目 | ベクトル (1, 2, 3) を2倍したものなので、より鋭い分布になります。 |
| (10, 20, 30) | ≈0.0000 (2.06×10⁻⁹), ≈0.0000 (4.54×10⁻⁵), 1.0000 (0.99995) | 3番目 | ほぼone-hot(1つだけが1となる分布)です。最大値を引く処理により、大きな入力でもオーバーフローを避けられます。 |
スケーリングの効果:すべての入力に1より大きい係数を掛けると、入力同士の差が広がるため、最大の要素の確率が増し、分布は鋭くなります。順位(argmax)は変わりません。0から1の間の係数を掛けると、分布は一様分布に近づく方向に平坦になります。
よくある質問
なぜ出力の合計は必ず1になるのですか? 各指数値をすべての指数値の合計で割っているため、この正規化により総和が必ず1になることが保証されます。
すべての入力が等しい場合はどうなりますか? 結果は一様分布となり、各出力はすべて \(1/K\) になります。
すべての入力に同じ定数を加えると結果は変わりますか? いいえ、変わりません。ソフトマックスはシフト不変です。すべての入力に同じ定数cを加えても出力は変化しません。これこそが、最大値を引く処理が安全である理由です。