Qu'est-ce que l'erreur quadratique moyenne ?
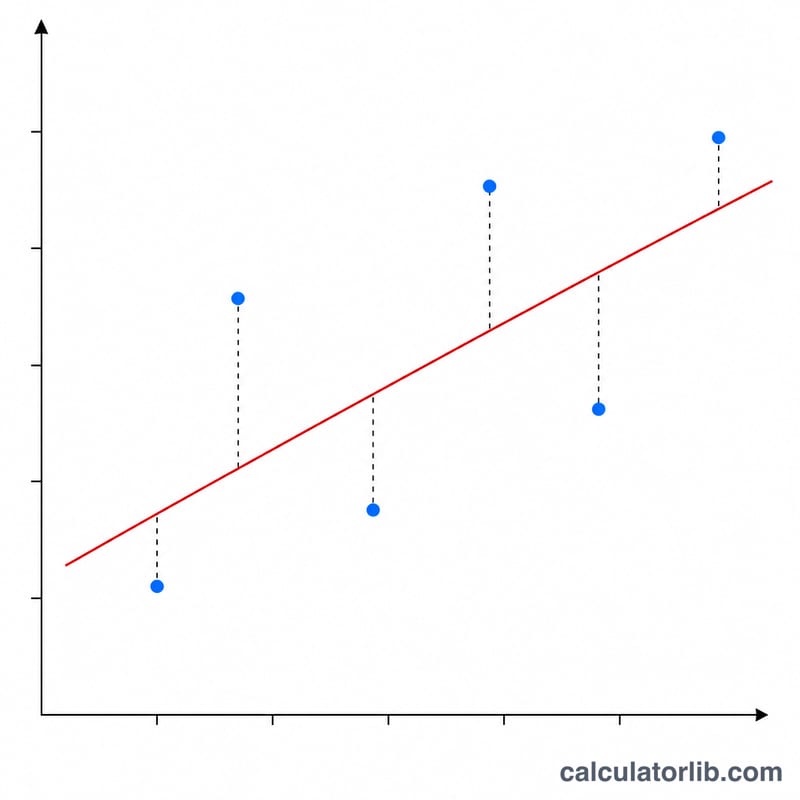
L'erreur quadratique moyenne (MSE, pour Erreur quadratique moyenne (MSE)) est l'une des métriques les plus utilisées pour mesurer à quel point un ensemble de prédictions se rapproche des valeurs réellement observées. Elle correspond à la moyenne des écarts au carré entre chaque valeur prédite (ŷ) et la valeur réelle (y) qui lui correspond. Comme les écarts sont élevés au carré, les grosses erreurs pèsent bien plus lourd que les petites, et le résultat reste toujours positif ou nul : un modèle parfait obtient exactement 0.
Comment utiliser ce calculateur
Saisissez vos valeurs réelles et vos valeurs prédites sous forme de deux listes séparées par des virgules. Les deux listes doivent avoir la même longueur, chaque valeur prédite étant alignée avec la valeur réelle qui occupe la même position. Le calculateur les associe dans l'ordre, calcule l'écart au carré pour chaque paire, puis renvoie le MSE accompagné du RMSE (racine de l'erreur quadratique moyenne) et du SSE (somme des écarts au carré). Si les deux listes n'ont pas la même longueur, seules les paires qui se chevauchent sont prises en compte.
La formule expliquée
La formule du MSE s'écrit $$\text{MSE} = \frac{1}{n}\sum_{i=1}^{n}\left(y_i - \hat{y}_i\right)^2$$. Pour chaque point de données, vous soustrayez la prédiction de la valeur réelle, vous élevez cet écart au carré, vous additionnez tous les écarts au carré (vous obtenez ainsi le SSE), puis vous divisez par le nombre de points \(n\). En prenant la racine carrée du MSE, vous obtenez le RMSE, particulièrement pratique car il s'exprime dans la même unité que vos données d'origine.
Exemple concret
Imaginons que les valeurs réelles soient 3, −0,5, 2, 7 et les prédictions 2,5, 0,0, 2, 8. Les écarts valent alors 0,5, −0,5, 0, −1. Élevés au carré, ils donnent 0,25, 0,25, 0, 1, dont la somme est 1,5 (le SSE). En divisant par \(n = 4\), on obtient un MSE de 0,375, et le RMSE vaut \(\sqrt{0{,}375} \approx 0{,}6124\).
Interpréter votre EQM et votre REQM
L'erreur quadratique moyenne (EQM) calcule la moyenne des carrés des écarts entre les valeurs réelles et les valeurs prédites. EQM = 0 signifie un ajustement parfait : chaque prédiction est égale à sa valeur réelle. Toute valeur plus élevée indique qu'une erreur existe, mais le fait qu'elle soit « grande » dépend du contexte.
- Échelle et unités : l'EQM s'exprime dans les unités au carré de la cible. Si vous prédisez des prix en dollars, l'EQM est exprimée en dollars². Changer l'échelle des données (par exemple des dollars en milliers de dollars) modifie l'EQM du carré du facteur d'échelle ; il n'existe donc pas d'EQM « bonne » universelle.
- La REQM est dans les unités d'origine : \(\text{RMSE} = \sqrt{\text{MSE}}\), donc elle peut être lue directement comme la taille typique d'une erreur, dans les mêmes unités que vos données (avec un poids plus important pour les grandes erreurs).
- Comparaison à une référence : un modèle qui prédit toujours la moyenne de la cible a une EQM égale à la variance (de population) de la cible. Pour les valeurs réelles 10, 12, 14, 16, 18, la moyenne est 14, et prédire 14 à chaque fois donne EQM = (16 + 4 + 0 + 4 + 16) / 5 = 8. Un modèle utile doit avoir une EQM nettement inférieure à cette référence.
- REQM et dispersion : comparez la REQM à l'écart type ou à l'étendue des données. Une REQM bien inférieure à l'écart type suggère que le modèle explique une grande partie de la variation ; une REQM proche de l'écart type ou supérieure indique une amélioration faible par rapport à une estimation par la moyenne.
- Sensibilité aux valeurs aberrantes : comme les erreurs sont élevées au carré, une seule erreur importante peut dominer l'EQM et la REQM. Si quelques points extrêmes ne sont pas représentatifs, vérifiez aussi l'EMA.
- Comparaisons valables : comparez uniquement des valeurs d'EQM calculées sur le même jeu de données et à la même échelle. Une EQM issue d'un autre jeu de données ou d'autres unités dit peu de choses sur la qualité relative.
- Entraînement vs test : calculez l'EQM sur les données d'entraînement et sur les données de test. Une EQM d'entraînement très faible associée à une EQM de test nettement plus élevée est un signe classique de surapprentissage.
EQM et REQM selon différents scénarios d'erreur
Tous les scénarios utilisent les mêmes valeurs réelles : 10, 12, 14, 16, 18 (n = 5). Les erreurs sont la prédiction moins la valeur réelle. Seules les prédictions changent.
| Scénario | Valeurs prédites | Erreurs | SSE | EQM | REQM | EMA |
|---|---|---|---|---|---|---|
| Prédiction parfaite | 10, 12, 14, 16, 18 | 0, 0, 0, 0, 0 | 0 | 0 | 0 | 0 |
| Petites erreurs uniformes | 11, 11, 15, 15, 19 | +1, −1, +1, −1, +1 | 5 | 1 | 1 | 1 |
| Une grande erreur aberrante | 10, 12, 14, 16, 23 | 0, 0, 0, 0, +5 | 25 | 5 | ≈ 2,236 | 1 |
| Biais constant (+2) | 12, 14, 16, 18, 20 | +2, +2, +2, +2, +2 | 20 | 4 | 2 | 2 |
Vérification détaillée pour la ligne aberrante : $$\text{SSE} = 0^2 + 0^2 + 0^2 + 0^2 + 5^2 = 25,\quad \text{EQM} = \frac{25}{5} = 5,\quad \text{REQM} = \sqrt{5} \approx 2{,}236,\quad \text{EMA} = \frac{5}{5} = 1$$
À retenir : les scénarios de petites erreurs uniformes et d'erreur aberrante ont la même EMA (1), pourtant la valeur aberrante fait passer l'EQM de 1 à 5, car l'erreur de 5 est élevée au carré et devient 25. Le scénario de biais constant montre qu'un décalage constant de 2 donne une REQM et une EMA égales à 2, puisque toutes les erreurs ont la même taille.
Termes clés et mesures associées
- n : le nombre de points de données (paires de valeurs réelles et prédites). L'EQM divise par n.
- Résidu : l'écart entre une valeur réelle et sa prédiction pour un point, \(e_i = y_i - \hat{y}_i\) (la convention de signe n'a pas d'importance pour l'EQM car les erreurs sont élevées au carré).
- SSE (somme des carrés des erreurs) : \(\sum e_i^2\). Elle est liée à l'EQM par \(\text{SSE} = n \times \text{MSE}\).
- EQM (erreur quadratique moyenne) : \(\text{SSE}/n\), le carré moyen des résidus, en unités au carré de la cible.
- REQM (racine de l'erreur quadratique moyenne) : \(\sqrt{\text{MSE}}\), dans les mêmes unités que la cible.
- EMA (erreur absolue moyenne) : \(\frac{1}{n}\sum |e_i|\). Elle pondère toutes les erreurs de façon linéaire, elle est donc moins sensible aux valeurs aberrantes que l'EQM. La REQM est toujours supérieure ou égale à l'EMA.
- R² (coefficient de détermination) : \(R^2 = 1 - \text{SSE}/\text{SST}\), où SST est la somme totale des carrés autour de la moyenne des valeurs réelles. De façon équivalente, \(R^2 = 1 - \text{MSE}/\text{Var}(y)\), il compare donc votre EQM à la référence de prédiction par la moyenne. Un R² de 1 correspond à une EQM de 0.
- Valeur aberrante : un point de données ou une erreur très éloigné du schéma habituel. Le carré donne un poids important aux valeurs aberrantes dans l'EQM et la REQM.
- Surapprentissage : situation où un modèle épouse de très près les données d'entraînement (EQM d'entraînement faible) mais performe moins bien sur de nouvelles données (EQM de test plus élevée).
Questions fréquentes
Qu'est-ce qu'une bonne valeur de MSE ? Il n'existe pas de seuil universel : le MSE dépend de l'échelle de vos données. Plus il est faible, mieux c'est, et une valeur de 0 traduit un ajustement parfait. Le mieux est de le comparer à d'autres modèles ou à la variance de la variable cible.
Quelle différence entre le MSE et le RMSE ? Le RMSE n'est rien d'autre que la racine carrée du MSE. On le privilégie souvent pour la communication des résultats, car il s'exprime dans la même unité que les données et se prête à une interprétation plus intuitive.
Pourquoi élever les écarts au carré plutôt que d'utiliser les valeurs absolues ? Élever au carré rend la fonction lisse et dérivable (un atout pour l'optimisation) et pénalise davantage les grandes erreurs. L'alternative, l'erreur absolue moyenne (MAE), traite quant à elle toutes les erreurs de façon linéaire.