मीन स्क्वेर्ड एरर क्या है?
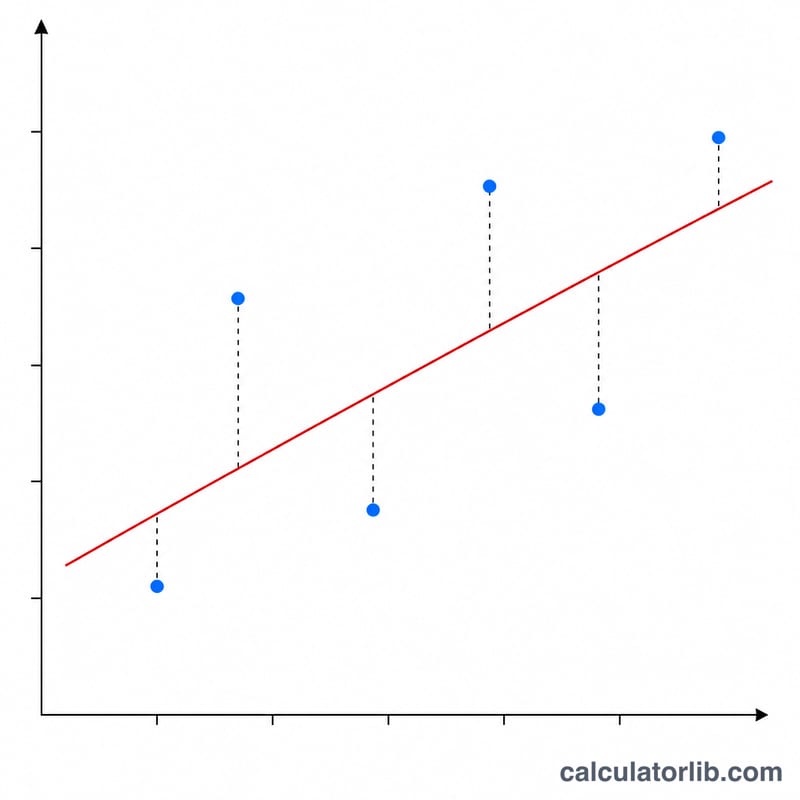
मीन स्क्वेर्ड एरर (MSE) यह मापने के लिए सबसे ज़्यादा इस्तेमाल होने वाले मेट्रिक्स में से एक है कि आपके अनुमान (predictions) वास्तविक देखे गए मानों के कितने करीब हैं। यह हर अनुमानित मान (\(\hat{y}\)) और उसके संगत वास्तविक मान (\(y\)) के बीच के अंतर के वर्ग का औसत निकालता है। चूँकि अंतर को वर्ग किया जाता है, इसलिए बड़ी गलतियों पर छोटी गलतियों की तुलना में ज़्यादा सख्ती से जुर्माना लगता है, और परिणाम हमेशा शून्य या उससे अधिक (non-negative) होता है — एक बिल्कुल सटीक मॉडल का स्कोर ठीक 0 होता है।
इस कैलकुलेटर का उपयोग कैसे करें
अपने वास्तविक मान और अनुमानित मान दो अलग-अलग सूचियों के रूप में दर्ज करें, जिनमें मान कॉमा से अलग किए गए हों। दोनों सूचियाँ समान लंबाई की होनी चाहिए, और हर अनुमानित मान उसी स्थान पर मौजूद वास्तविक मान के साथ मेल खाना चाहिए। कैलकुलेटर इन्हें क्रम के अनुसार जोड़ी (pair) बनाता है, हर जोड़ी के लिए वर्ग त्रुटि (squared error) निकालता है, और MSE के साथ-साथ संबंधित RMSE (रूट मीन स्क्वेर्ड एरर) और SSE (वर्ग त्रुटियों का योग) भी देता है। यदि दोनों सूचियों की लंबाई अलग है, तो केवल मेल खाने वाली (overlapping) जोड़ियों का ही उपयोग होगा।
फ़ॉर्मूला समझें
MSE का फ़ॉर्मूला है $$\text{MSE} = \frac{1}{n}\sum_{i=1}^{n}\left(y_i - \hat{y}_i\right)^2$$ हर डेटा बिंदु के लिए, वास्तविक मान में से अनुमान घटाएँ, उस अंतर का वर्ग करें, सभी वर्ग किए गए अंतरों को जोड़ें (यही SSE है), और अंत में बिंदुओं की संख्या \(n\) से भाग दें। MSE का वर्गमूल लेने पर RMSE मिलता है, जो इसलिए सुविधाजनक है क्योंकि इसकी इकाई मूल डेटा की इकाई जैसी ही रहती है।
हल किया हुआ उदाहरण
मान लीजिए वास्तविक मान 3, −0.5, 2, 7 हैं और अनुमान 2.5, 0.0, 2, 8 हैं। तो त्रुटियाँ होंगी 0.5, −0.5, 0, −1। इन्हें वर्ग करने पर मिलता है 0.25, 0.25, 0, 1, जिनका योग 1.5 है (यही SSE है)। इसे \(n = 4\) से भाग देने पर MSE आता है 0.375, और RMSE होता है \(\sqrt{0.375} \approx 0.6124\)।
आपके MSE और RMSE की व्याख्या
माध्य वर्ग त्रुटि (Mean Squared Error) वास्तविक और अनुमानित मानों के बीच के अंतरों के वर्गों का औसत है। MSE = 0 का अर्थ है एक सही फिट: हर अनुमान अपने वास्तविक मान के बराबर है। इससे बड़ा कोई भी मान बताता है कि कुछ त्रुटि मौजूद है, लेकिन यह कि वह "बड़ी" है या नहीं, यह संदर्भ पर निर्भर करता है।
- पैमाना और इकाइयाँ: MSE लक्ष्य की वर्ग इकाइयों में होता है। यदि आप कीमतों का अनुमान डॉलर में लगाते हैं, तो MSE डॉलर² में होगा। डेटा का पैमाना बदलने (उदाहरण के लिए डॉलर से हज़ार डॉलर) से MSE स्केलिंग कारक के वर्ग के अनुसार बदल जाता है, इसलिए कोई सार्वभौमिक "अच्छा" MSE नहीं होता।
- RMSE मूल इकाइयों में है: \(\text{RMSE} = \sqrt{\text{MSE}}\), इसलिए इसे सीधे आपके डेटा की उसी इकाई में एक विशिष्ट त्रुटि आकार के रूप में पढ़ा जा सकता है (बड़ी त्रुटियों की ओर भारित)।
- आधार रेखा तुलना: एक मॉडल जो हमेशा लक्ष्य का माध्य अनुमान लगाता है, उसका MSE लक्ष्य के (जनसंख्या) प्रसरण के बराबर होता है। वास्तविक मानों 10, 12, 14, 16, 18 के लिए माध्य 14 है, और हर बार 14 का अनुमान लगाने पर MSE = (16 + 4 + 0 + 4 + 16) / 5 = 8 आता है। एक उपयोगी मॉडल का MSE इस आधार रेखा से स्पष्ट रूप से कम होना चाहिए।
- RMSE बनाम प्रसार: RMSE की तुलना डेटा के मानक विचलन या परिसर (range) से करें। मानक विचलन से बहुत छोटा RMSE बताता है कि मॉडल भिन्नता का बड़ा हिस्सा समझाता है; मानक विचलन के निकट या उससे अधिक RMSE बताता है कि माध्य का अनुमान लगाने की तुलना में सुधार बहुत कम है।
- बाहरी मानों के प्रति संवेदनशीलता: चूँकि त्रुटियों का वर्ग किया जाता है, एक ही बड़ी चूक MSE और RMSE पर हावी हो सकती है। यदि कुछ चरम बिंदु प्रतिनिधि नहीं हैं, तो MAE भी जाँचें।
- वैध तुलनाएँ: केवल एक ही डेटासेट और एक ही पैमाने पर गणना किए गए MSE मानों की तुलना करें। किसी अलग डेटासेट या अलग इकाइयों के MSE से सापेक्ष गुणवत्ता के बारे में बहुत कम पता चलता है।
- प्रशिक्षण बनाम परीक्षण: प्रशिक्षण और परीक्षण दोनों डेटा पर MSE निकालें। प्रशिक्षण MSE बहुत कम और परीक्षण MSE कहीं अधिक होना ओवरफिटिंग का एक क्लासिक संकेत है।
विभिन्न त्रुटि परिदृश्यों में MSE बनाम RMSE
सभी परिदृश्य एक ही वास्तविक मानों का उपयोग करते हैं: 10, 12, 14, 16, 18 (n = 5)। त्रुटियाँ अनुमानित घटा वास्तविक हैं। केवल अनुमान बदलते हैं।
| परिदृश्य | अनुमानित मान | त्रुटियाँ | SSE | MSE | RMSE | MAE |
|---|---|---|---|---|---|---|
| सही अनुमान | 10, 12, 14, 16, 18 | 0, 0, 0, 0, 0 | 0 | 0 | 0 | 0 |
| छोटी समान त्रुटियाँ | 11, 11, 15, 15, 19 | +1, −1, +1, −1, +1 | 5 | 1 | 1 | 1 |
| एक बड़ी बाहरी त्रुटि | 10, 12, 14, 16, 23 | 0, 0, 0, 0, +5 | 25 | 5 | ≈ 2.236 | 1 |
| स्थिर पूर्वाग्रह (+2) | 12, 14, 16, 18, 20 | +2, +2, +2, +2, +2 | 20 | 4 | 2 | 2 |
बाहरी मान वाली पंक्ति की जाँच: $$\text{SSE} = 0^2 + 0^2 + 0^2 + 0^2 + 5^2 = 25,\quad \text{MSE} = \frac{25}{5} = 5,\quad \text{RMSE} = \sqrt{5} \approx 2.236,\quad \text{MAE} = \frac{5}{5} = 1$$
सार: छोटी-समान-त्रुटि और बाहरी-मान परिदृश्यों का MAE समान (1) है, फिर भी बाहरी मान MSE को 1 से 5 तक बढ़ा देता है, क्योंकि 5 की एकल त्रुटि का वर्ग 25 हो जाता है। स्थिर-पूर्वाग्रह परिदृश्य दिखाता है कि 2 का लगातार विचलन RMSE और MAE दोनों को 2 के बराबर बना देता है, क्योंकि सभी त्रुटियों का आकार समान है।
मुख्य शब्द और संबंधित मेट्रिक्स
- n: डेटा बिंदुओं की संख्या (वास्तविक और अनुमानित मानों के जोड़े)। MSE, n से भाग देता है।
- अवशेष (Residual): एक बिंदु के लिए वास्तविक मान और उसके अनुमान के बीच का अंतर, \(e_i = y_i - \hat{y}_i\) (MSE के लिए चिह्न परंपरा मायने नहीं रखती, क्योंकि त्रुटियों का वर्ग किया जाता है)।
- SSE (त्रुटियों के वर्गों का योग): \(\sum e_i^2\)। यह MSE से \(\text{SSE} = n \times \text{MSE}\) द्वारा संबंधित है।
- MSE (माध्य वर्ग त्रुटि): \(\text{SSE}/n\), औसत वर्ग अवशेष, लक्ष्य की वर्ग इकाइयों में।
- RMSE (मूल माध्य वर्ग त्रुटि): \(\sqrt{\text{MSE}}\), लक्ष्य की उसी इकाई में।
- MAE (माध्य निरपेक्ष त्रुटि): \(\frac{1}{n}\sum |e_i|\)। यह सभी त्रुटियों को रैखिक रूप से भारित करता है, इसलिए यह MSE की तुलना में बाहरी मानों के प्रति कम संवेदनशील है। RMSE सदैव MAE से अधिक या उसके बराबर होता है।
- R² (निर्धारण गुणांक): \(R^2 = 1 - \text{SSE}/\text{SST}\), जहाँ SST वास्तविक मानों के माध्य के चारों ओर कुल वर्ग योग है। समतुल्य रूप से, \(R^2 = 1 - \text{MSE}/\text{Var}(y)\), इसलिए यह आपके MSE की माध्य-अनुमान आधार रेखा से तुलना करता है। R² का मान 1 हो तो MSE = 0 होता है।
- बाहरी मान (Outlier): एक डेटा बिंदु या त्रुटि जो सामान्य पैटर्न से बहुत दूर हो। वर्ग करने से बाहरी मान MSE और RMSE में अधिक भार रखते हैं।
- ओवरफिटिंग: जब कोई मॉडल प्रशिक्षण डेटा से बहुत निकटता से फिट होता है (कम प्रशिक्षण MSE), लेकिन नए डेटा पर खराब प्रदर्शन करता है (अधिक परीक्षण MSE)।
अक्सर पूछे जाने वाले सवाल (FAQ)
अच्छा MSE मान कितना होता है? इसकी कोई सार्वभौमिक सीमा नहीं है — MSE आपके डेटा के स्केल पर निर्भर करता है। जितना कम हो उतना बेहतर, और 0 का मतलब है बिल्कुल सटीक फ़िट। इसकी तुलना अन्य मॉडलों से या लक्ष्य (target) के वैरियंस से करें।
MSE और RMSE में क्या अंतर है? RMSE सिर्फ़ MSE का वर्गमूल है। रिपोर्टिंग के लिए अक्सर RMSE को प्राथमिकता दी जाती है क्योंकि यह डेटा की ही इकाई में होता है और समझने में आसान रहता है।
त्रुटियों का वर्ग क्यों करते हैं, निरपेक्ष (absolute) मान क्यों नहीं? वर्ग करने से फ़ंक्शन स्मूद और डिफ़रेंशिएबल बनता है (जो ऑप्टिमाइज़ेशन के लिए उपयोगी है) और बड़ी त्रुटियों पर ज़्यादा सख्ती से जुर्माना लगता है। इसका विकल्प, मीन एब्सोल्यूट एरर (MAE), सभी त्रुटियों को रैखिक (linear) रूप से मानता है।