मीन एब्सोल्यूट एरर (MAE) क्या है?
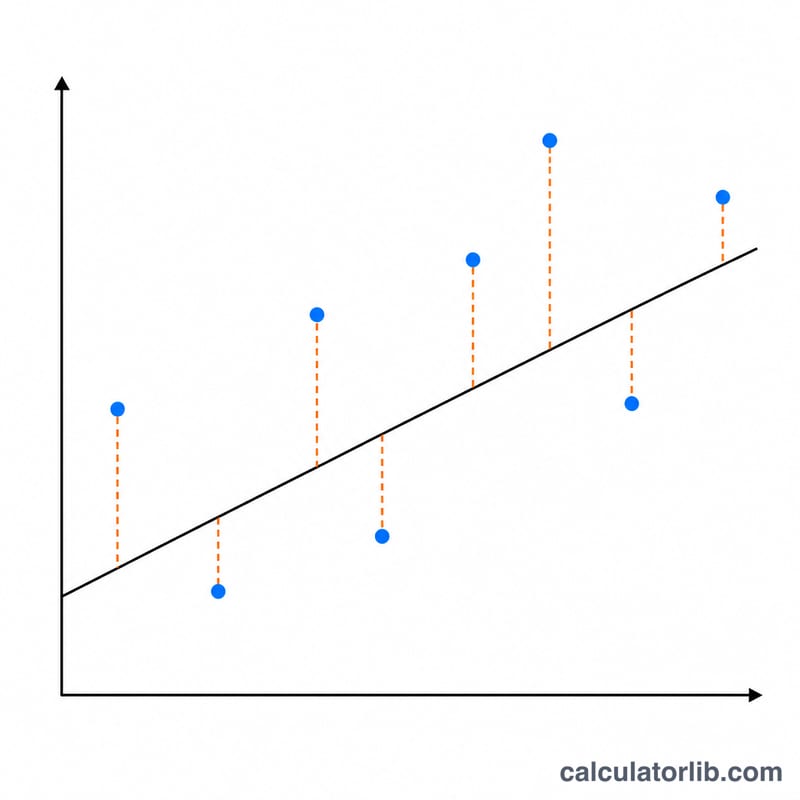
मीन एब्सोल्यूट एरर (MAE) किसी रिग्रेशन मॉडल या पूर्वानुमान की सटीकता आँकने के लिए सबसे ज़्यादा इस्तेमाल होने वाले मापदंडों में से एक है। यह अनुमानित मानों और वास्तविक प्रेक्षित मानों के बीच की त्रुटियों के औसत परिमाण को मापता है, बिना यह देखे कि त्रुटि किस दिशा में है (कम या ज़्यादा)। चूँकि इसमें निरपेक्ष मान (absolute value) लिया जाता है, इसलिए हर त्रुटि कुल योग में धनात्मक रूप से जुड़ती है। यही वजह है कि MAE को समझना आसान है — यह बताता है कि आपके अनुमान औसतन कितने गलत हैं, और वह भी डेटा की उन्हीं इकाइयों में।
इस कैलकुलेटर का उपयोग कैसे करें
दोनों बॉक्स में अपने वास्तविक (प्रेक्षित) मानों की सूची और अपने अनुमानित (पूर्वानुमान या मॉडल वाले) मानों की सूची दर्ज करें। हर संख्या को कॉमा या स्पेस से अलग करें। ध्यान रखें कि दोनों सूचियों में संख्याओं की गिनती एक समान हो और वे इस तरह क्रम में हों कि पहला वास्तविक मान पहले अनुमान से मेल खाए, और इसी तरह आगे भी। गणना करें पर क्लिक करते ही आपको MAE के साथ-साथ निरपेक्ष त्रुटियों का योग और उपयोग किए गए युग्मों (pairs) की संख्या भी मिल जाएगी।
फ़ॉर्मूला समझें
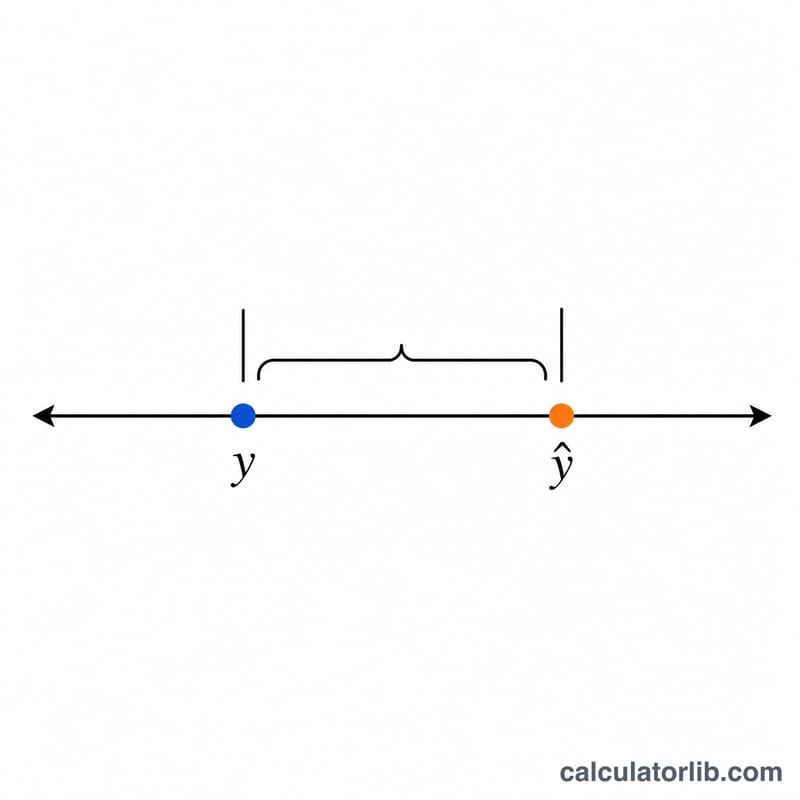
फ़ॉर्मूला है $$\text{MAE} = \frac{1}{n}\sum_{i=1}^{n}\left| y_i - \hat{y}_i \right|$$। हर प्रेक्षण के लिए आप वास्तविक मान (\(y_i\)) में से अनुमानित मान (\(\hat{y}_i\)) घटाते हैं, उस अंतर का निरपेक्ष मान लेते हैं (यानी ऋण चिह्न को नज़रअंदाज़ कर देते हैं), फिर इन सभी निरपेक्ष अंतरों को जोड़ते हैं, और अंत में प्रेक्षणों की संख्या \(n\) से भाग देते हैं। जो परिणाम मिलता है, वह एक सामान्य अनुमान-त्रुटि का औसत आकार होता है।
हल किया हुआ उदाहरण
मान लीजिए वास्तविक मान 3, 5, 2, 7 हैं और अनुमानित मान 2.5, 5, 4, 8 हैं। तो निरपेक्ष त्रुटियाँ होंगी: \(|3-2.5| = 0.5\), \(|5-5| = 0\), \(|2-4| = 2\), और \(|7-8| = 1\)। इनका योग 3.5 है। इसे \(n = 4\) से भाग देने पर $$\text{MAE} = 3.5 / 4 = 0.875$$ मिलता है।
आपके MAE परिणाम की व्याख्या
MAE पूर्वानुमान त्रुटियों का औसत आकार है, दिशा को अनदेखा करते हुए। यह आपके डेटा की उसी इकाई में व्यक्त किया जाता है। किलोग्राम में मापी गई श्रृंखला पर 5 का MAE का अर्थ है कि पूर्वानुमान औसतन लगभग 5 kg से चूकते हैं। टन में मापी गई श्रृंखला पर वही 5 बिल्कुल अलग अर्थ रखता है।
संख्या को संदर्भ दें। अकेले कच्चे MAE का आकलन करना कठिन है, इसलिए इसकी तुलना इनमें से किसी एक से करें:
- वास्तविक मानों का माध्य या सीमा। जब वास्तविक मान औसतन 1,000 हों तो 2 का MAE छोटा है, लेकिन जब वे औसतन 5 हों तो बड़ा है।
- एक सरल आधार-रेखा (naive baseline) पूर्वानुमान। उदाहरण हैं \(\hat{y}_t = y_{t-1}\) (अंतिम मान) या वास्तविक मानों का माध्य। यदि आपके मॉडल का MAE आधार-रेखा के MAE से स्पष्ट रूप से कम नहीं है, तो उससे बहुत कम मूल्य जुड़ता है।
- पैमाने-सापेक्ष संस्करण। एक सामान्य संस्करण है \(\text{MAE} / \bar{y}\), यानी MAE को वास्तविक मानों के माध्य से विभाजित करना, जिसे अक्सर प्रतिशत के रूप में दिखाया जाता है। यह तभी सार्थक है जब माध्य शून्य से काफी दूर हो।
MAE पैमाना-मुक्त नहीं है। आप डॉलर में मापे गए MAE की तुलना डिग्री में मापे गए MAE से नहीं कर सकते। आप अलग-अलग इकाइयों या परिमाण वाले डेटासेट के MAE की तुलना भी नहीं कर सकते, जब तक कि पहले उसे सामान्यीकृत (normalise) न किया जाए (उदाहरण के लिए माध्य से, या किसी naive baseline के MAE से)।
MAE बनाम RMSE। त्रुटियों के एक ही समूह के लिए, MAE कभी भी RMSE से बड़ा नहीं होता:
$$\text{MAE} \le \text{RMSE}$$
वे तभी बराबर होते हैं जब हर त्रुटि का निरपेक्ष आकार समान हो। RMSE और MAE के बीच बड़ा अंतर संकेत देता है कि कुछ बड़ी त्रुटियाँ हावी हैं। छोटा अंतर बताता है कि त्रुटियाँ काफी समान हैं।
मज़बूती (Robustness)। MAE हर त्रुटि को रैखिक रूप से भारित करता है: 10 की त्रुटि 5 की त्रुटि से ठीक दोगुनी गिनी जाती है। इसलिए यह वर्ग-त्रुटि वाले मापदंडों की तुलना में बाहरी मानों (outliers) के प्रति कम संवेदनशील है, जो तब उपयोगी है जब कभी-कभार आने वाले अत्यधिक मान स्कोर पर हावी नहीं होने चाहिए। यदि बड़ी चूकें विशेष रूप से महँगी हैं, तो MAE के साथ RMSE पर नज़र रखना बेहतर हो सकता है।
MAE बनाम RMSE बनाम MSE: नमूना डेटा पर तुलना
तीनों परिदृश्य एक ही वास्तविक मानों का उपयोग करते हैं: 10, 20, 30, 40 (n = 4)। केवल पूर्वानुमान बदलते हैं। परिदृश्य 1 और 2 की कुल निरपेक्ष त्रुटि समान है, 8, इसलिए उनका MAE एक समान है।
| परिदृश्य | पूर्वानुमानित | त्रुटियाँ (y − ŷ) | MAE | MSE | RMSE |
|---|---|---|---|---|---|
| 1. छोटी समान त्रुटियाँ | 12, 18, 32, 38 | −2, 2, −2, 2 | (2+2+2+2)/4 = 2 | (4+4+4+4)/4 = 4 | √4 = 2 |
| 2. एक बड़ी त्रुटि | 10, 20, 30, 32 | 0, 0, 0, 8 | (0+0+0+8)/4 = 2 | (0+0+0+64)/4 = 16 | √16 = 4 |
| 3. सटीक पूर्वानुमान | 10, 20, 30, 40 | 0, 0, 0, 0 | 0/4 = 0 | 0/4 = 0 | √0 = 0 |
तालिका क्या दिखाती है:
- परिदृश्य 1 और 2 दोनों का MAE = 2 है, क्योंकि MAE केवल कुल निरपेक्ष त्रुटि (8) को n (4) से विभाजित करने पर निर्भर करता है।
- उसी त्रुटि को एक बिंदु में केंद्रित करने से MSE 4 से बढ़कर 16 और RMSE 2 से बढ़कर 4 हो जाता है, क्योंकि वर्ग करने से 8 की एकल त्रुटि पर भारी दंड लगता है: \(8^2 = 64\) बनाम \(4 \times 2^2 = 16\)।
- परिदृश्य 1 में RMSE, MAE के बराबर है क्योंकि सभी त्रुटियों का आकार समान है। परिदृश्य 2 में RMSE, MAE का दोगुना है, जो कुछ बड़ी त्रुटियों का संकेत देता है।
- परिदृश्य 3 में तीनों मापदंड 0 हैं, जो सर्वोत्तम संभव मान है।
अक्सर पूछे जाने वाले सवाल
MAE और MSE में क्या अंतर है? MAE निरपेक्ष त्रुटियों का औसत निकालता है, जबकि मीन स्क्वेयर्ड एरर (MSE) त्रुटियों के वर्ग का औसत लेता है। MSE बड़ी त्रुटियों पर ज़्यादा भारी दंड लगाता है, जबकि MAE सभी त्रुटियों को समान अनुपात में मानता है।
अच्छा MAE मान कितना होता है? जितना कम, उतना अच्छा — और MAE = 0 का मतलब है बिल्कुल सटीक अनुमान। इसके लिए कोई एक सार्वभौमिक सीमा नहीं है; इसे हमेशा अपने डेटा के पैमाने और सामान्य रेंज के संदर्भ में ही समझें।
क्या MAE ऋणात्मक हो सकता है? नहीं। चूँकि यह निरपेक्ष अंतरों (जो हमेशा शून्य या धनात्मक होते हैं) का औसत निकालता है, इसलिए MAE हमेशा शून्य या उससे अधिक ही होता है।