केंद्रीय सीमा प्रमेय क्या है?
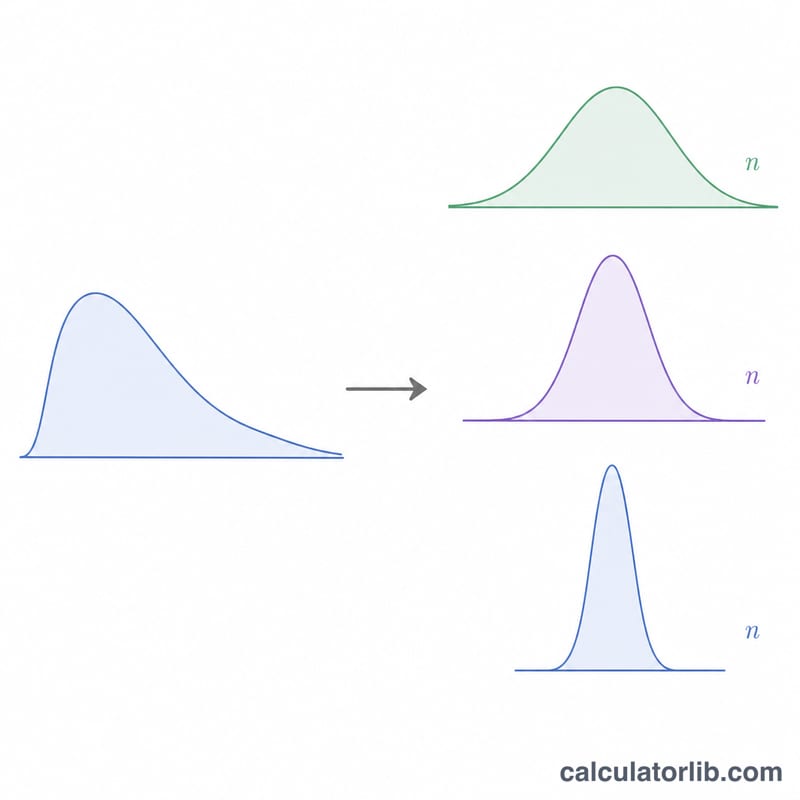
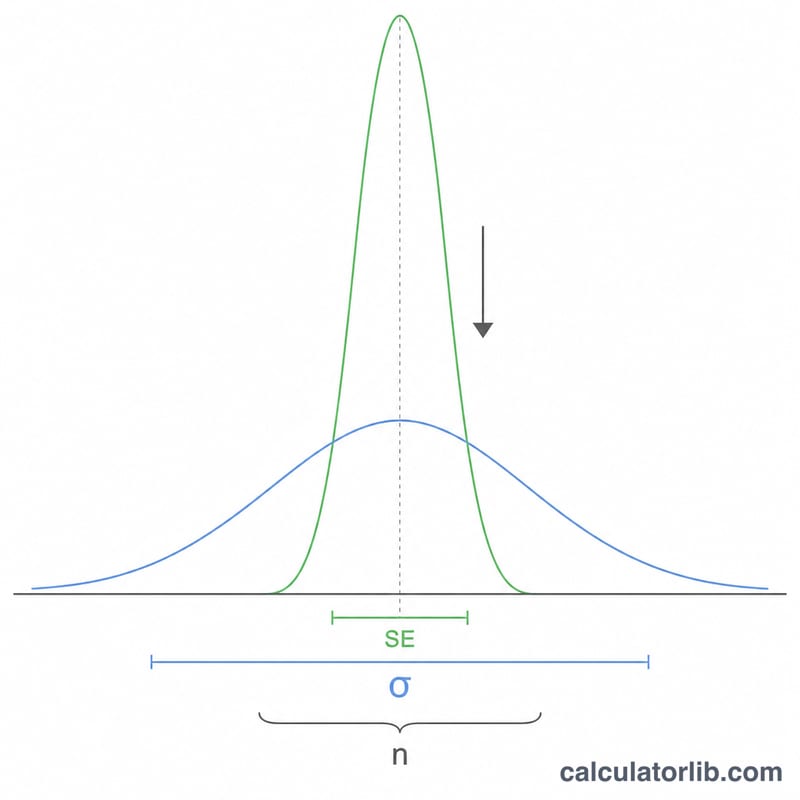
केंद्रीय सीमा प्रमेय (Central Limit Theorem, CLT) सांख्यिकी का एक बुनियादी स्तंभ है। यह बताता है कि जब आप किसी भी जनसंख्या — जिसका माध्य μ और मानक विचलन σ हो — से बार-बार आकार n के यादृच्छिक नमूने लेते हैं, तो नमूना माध्यों का वितरण n बढ़ने के साथ लगभग सामान्य (normal) हो जाता है, चाहे मूल जनसंख्या का आकार कैसा भी हो। यह कैलकुलेटर आपको उसी प्रतिचयन वितरण के दो मुख्य मान देता है: उसका माध्य और उसकी मानक त्रुटि।
इस कैलकुलेटर का उपयोग कैसे करें
जनसंख्या माध्य (μ), जनसंख्या मानक विचलन (σ) और अपना नमूना आकार (n) दर्ज करें। यह टूल प्रतिचयन वितरण का माध्य (जो μ के बराबर होता है), माध्य की मानक त्रुटि (SE) और नमूना माध्य का प्रसरण (\(\sigma^{2}/n\)) लौटाता है। एक आम अंगूठा-नियम यह है कि \(n \ge 30\) होने पर सामान्य सन्निकटन भरोसेमंद हो जाता है।
सूत्र की व्याख्या
CLT हमें माध्य के प्रतिचयन वितरण के बारे में दो बातें बताता है। पहली, इसका केंद्र जनसंख्या के माध्य के समान ही होता है: \(\mu_{\bar{x}} = \mu\)। दूसरी, नमूना जितना बड़ा होता है, इसका फैलाव उतना ही कम होता जाता है:
$$\mu_{\bar{x}} = \text{Mean }(\mu) \qquad SE = \frac{\text{SD }(\sigma)}{\sqrt{\text{Sample size }(n)}}$$चूँकि \(\sqrt{n}\) से भाग देने पर विचरण घटता है, इसलिए बड़े नमूने सही माध्य का अधिक सटीक अनुमान देते हैं। नमूना माध्य का प्रसरण बस मानक त्रुटि का वर्ग है, यानी \(\sigma^{2}/n\)।
हल किया हुआ उदाहरण
मान लीजिए किसी जनसंख्या का \(\mu = 100\) और \(\sigma = 15\) है, और आप \(n = 36\) आकार के नमूने लेते हैं। तब \(\mu_{\bar{x}} = 100\), और
$$SE = \frac{15}{\sqrt{36}} = \frac{15}{6} = 2.5$$नमूना माध्य का प्रसरण होगा
$$\frac{15^{2}}{36} = \frac{225}{36} = 6.25$$यानी नमूना माध्य 100 के आसपास कसकर इकट्ठा होते हैं, और मानक त्रुटि केवल 2.5 रहती है।
नमूना आकार मानक त्रुटि को कैसे बदलता है
तालिका जनसंख्या माध्य को \(\mu = 100\) और जनसंख्या मानक विचलन को \(\sigma = 15\) पर स्थिर रखती है। यह दिखाती है कि नमूना आकार \(n\) बढ़ने पर मानक त्रुटि \(SE = \sigma/\sqrt{n}\) और नमूना माध्य का प्रसरण \(\sigma^2/n\) कैसे घटते हैं। नमूना माध्यों का प्रतिदर्श बंटन का माध्य हर \(n\) के लिए \(\mu_{\bar{x}} = 100\) पर रहता है।
| नमूना आकार n | नमूना माध्यों का माध्य | SE = σ/√n | प्रसरण σ²/n |
|---|---|---|---|
| 1 | 100 | 15 | 225 |
| 4 | 100 | 7.5 | 56.25 |
| 9 | 100 | 5 | 25 |
| 25 | 100 | 3 | 9 |
| 36 | 100 | 2.5 | 6.25 |
| 100 | 100 | 1.5 | 2.25 |
| 400 | 100 | 0.75 | 0.5625 |
चूँकि \(SE\) \(\sqrt{n}\) पर निर्भर करता है, नमूना आकार को चार गुना करने से मानक त्रुटि आधी हो जाती है। उदाहरण के लिए, \(n = 9\) से \(n = 36\) पर जाने से \(SE\) 5 से घटकर 2.5 हो जाता है, और \(n = 25\) से \(n = 100\) पर जाने से यह 3 से घटकर 1.5 हो जाता है। इसलिए सटीकता का हर अगला स्तर पाने के लिए उत्तरोत्तर अधिक डेटा की आवश्यकता होती है।
मानक त्रुटि और प्रतिदर्श बंटन की व्याख्या
पर्याप्त बड़े यादृच्छिक नमूने के लिए, केंद्रीय सीमा प्रमेय (CLT) कहता है कि \(\bar{x}\) का प्रतिदर्श बंटन लगभग सामान्य होता है, जिसका माध्य \(\mu\) और मानक विचलन \(SE = \sigma/\sqrt{n}\) है। जब यह सन्निकटन लागू हो जाता है, तब नमूना माध्यों पर अनुभवजन्य नियम लागू होता है:
- लगभग 68% नमूना माध्य \(\mu\) के ±1 SE के भीतर आते हैं।
- लगभग 95% \(\mu\) के ±2 SE के भीतर आते हैं।
- लगभग 99.7% \(\mu\) के ±3 SE के भीतर आते हैं।
उदाहरण: \(\mu = 100\), \(\sigma = 15\) और \(n = 36\) के साथ, \(SE = 15/\sqrt{36} = 15/6 = 2.5\)। तब:
- ±1 SE: लगभग 97.5 से 102.5 (नमूना माध्यों का ≈68%)
- ±2 SE: लगभग 95 से 105 (≈95%)
- ±3 SE: लगभग 92.5 से 107.5 (≈99.7%)
मानक त्रुटि बनाम मानक विचलन। मानक विचलन \(\sigma\) मापता है कि जनसंख्या में अलग-अलग मान कितने फैले हैं। मानक त्रुटि मापती है कि नमूने-दर-नमूने नमूना माध्य कितने फैले हैं। जब \(n > 1\) होता है तो \(SE\) हमेशा \(\sigma\) से छोटा होता है, और \(n\) बढ़ने पर यह घटता है, जबकि \(\sigma\) \(n\) के साथ नहीं बदलता।
CLT क्या नहीं कहता। यह नमूना माध्यों के बंटन का वर्णन करता है, न कि अलग-अलग प्रेक्षणों का। अलग-अलग मान उतने ही फैले और उतने ही तिरछे (skewed) रहते हैं जितनी जनसंख्या है। 36 प्रेक्षणों के साथ, अलग-अलग अंक अब भी \(\sigma = 15\) के साथ बदलते हैं, लेकिन उनका औसत केवल \(SE = 2.5\) के साथ बदलता है। सन्निकटन कितनी जल्दी अच्छा होता है, यह जनसंख्या के आकार पर निर्भर करता है: अत्यधिक तिरछी जनसंख्याओं को बड़े \(n\) की आवश्यकता होती है। एक सामान्य अनुभवजन्य नियम \(n \ge 30\) है, लेकिन यह केवल एक मार्गदर्शक सिद्धांत है।
मुख्य शब्द और प्रतीक
- जनसंख्या माध्य (μ)
- जनसंख्या के सभी मानों का औसत। यह \(\bar{x}\) के प्रतिदर्श बंटन का भी माध्य है।
- जनसंख्या मानक विचलन (σ)
- एक माप कि जनसंख्या में अलग-अलग मान \(\mu\) के चारों ओर कितने फैले हैं।
- नमूना आकार (n)
- प्रत्येक नमूने में स्वतंत्र प्रेक्षणों की संख्या।
- नमूना माध्य (x̄)
- एक नमूने में \(n\) प्रेक्षणों का औसत, \(\bar{x} = \frac{1}{n}\sum x_i\)। यह नमूने-दर-नमूने बदलता है।
- प्रतिदर्श बंटन
- जनसंख्या से आकार \(n\) के सभी संभावित नमूनों पर एक सांख्यिकी, यहाँ \(\bar{x}\), का बंटन।
- मानक त्रुटि (SE)
- माध्य के प्रतिदर्श बंटन का मानक विचलन: \(SE = \sigma/\sqrt{n}\)।
- नमूना माध्य का प्रसरण
- मानक त्रुटि का वर्ग: \(\sigma^2/n\)।
- स्वतंत्रता / यादृच्छिक-नमूनाकरण की धारणा
- सूत्र मानते हैं कि प्रेक्षण यादृच्छिक और स्वतंत्र रूप से लिए गए हैं (या नमूना एक बड़ी जनसंख्या का छोटा अंश है)। पक्षपातपूर्ण या आश्रित नमूनाकरण से SE का सूत्र गलत हो सकता है, और CLT लागू नहीं हो सकता। जनसंख्या का परिमित प्रसरण भी होना चाहिए।
अक्सर पूछे जाने वाले सवाल
क्या जनसंख्या का सामान्य (normal) होना ज़रूरी है? नहीं। यही तो CLT की ताकत है — पर्याप्त बड़े n के लिए माध्य का प्रतिचयन वितरण लगभग सामान्य हो जाता है, भले ही जनसंख्या विषम (skewed) क्यों न हो।
कितना नमूना आकार "पर्याप्त बड़ा" माना जाता है? आम दिशानिर्देश \(n \ge 30\) है, हालांकि बहुत अधिक विषम जनसंख्या के लिए इससे ज़्यादा की ज़रूरत पड़ सकती है।
बड़े नमूनों के साथ मानक त्रुटि कम क्यों हो जाती है? अधिक प्रेक्षणों का औसत लेने पर यादृच्छिक उतार-चढ़ाव आपस में कट जाते हैं, इसलिए n बढ़ने के साथ माध्य का अनुमान अधिक स्थिर हो जाता है।