중심극한정리란?
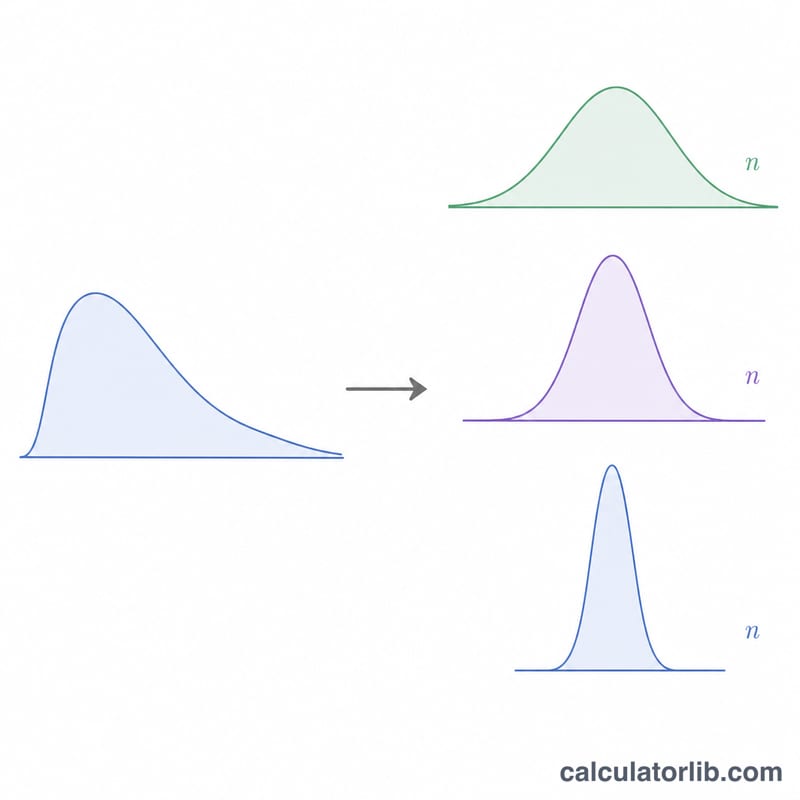
중심극한정리(CLT)는 통계학의 핵심 원리입니다. 평균이 μ, 표준편차가 σ인 어떤 모집단에서 크기 n의 무작위 표본을 반복해서 뽑으면, 원래 모집단의 분포 모양과 상관없이 n이 커질수록 표본평균의 분포가 점점 정규분포에 가까워진다는 것이 핵심입니다. 이 계산기는 그 표본분포의 두 가지 핵심 값, 즉 평균과 표준오차를 구해 줍니다.
계산기 사용 방법
모집단 평균(μ), 모집단 표준편차(σ), 그리고 표본 크기(n)를 입력하세요. 계산기는 표본분포의 평균(μ와 같습니다), 표본평균의 표준오차(SE), 그리고 표본평균의 분산(\(\sigma^{2}/n\))을 알려 줍니다. 보통 \(n \ge 30\)이면 정규근사가 충분히 안정적이라는 경험 법칙이 널리 쓰입니다.
공식 설명
중심극한정리는 표본평균의 분포에 대해 두 가지를 말해 줍니다. 첫째, 분포의 중심은 모집단과 같습니다:
$$\mu_{\bar{x}} = \mu$$둘째, 표본이 커질수록 분포가 좁아집니다:
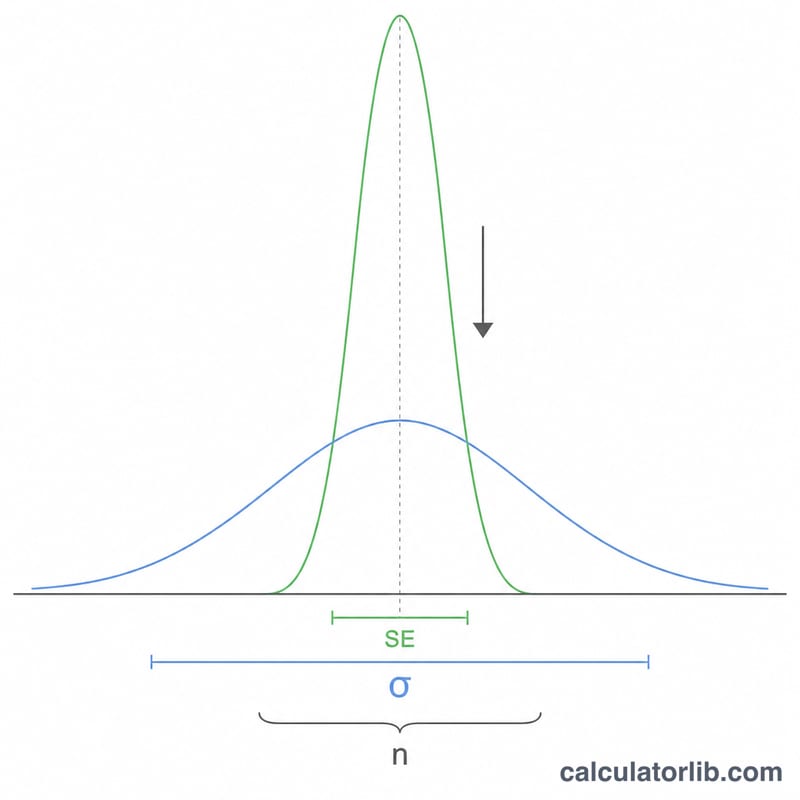
$$SE = \frac{\sigma}{\sqrt{n}}$$\(\sqrt{n}\)으로 나누면 변동성이 줄어들기 때문에, 표본이 클수록 참평균에 대한 추정이 더 정밀해집니다. 표본평균의 분산은 표준오차를 제곱한 값, 즉 \(\sigma^{2}/n\)입니다.
예제로 살펴보기
모집단의 μ = 100, σ = 15이고 크기 n = 36인 표본을 뽑는다고 가정해 봅시다. 그러면 \(\mu_{\bar{x}} = 100\)이고,
$$SE = \frac{15}{\sqrt{36}} = \frac{15}{6} = 2.5$$가 됩니다. 표본평균의 분산은
$$\frac{15^{2}}{36} = \frac{225}{36} = 6.25$$입니다. 따라서 표본평균들은 표준오차 2.5로 100 주변에 촘촘히 모이게 됩니다.
표본 크기가 표준오차에 미치는 영향
이 표는 모평균을 \(\mu = 100\), 모표준편차를 \(\sigma = 15\)로 고정합니다. 표본 크기 \(n\)이 커질수록 표준오차 \(SE = \sigma/\sqrt{n}\)와 표본평균의 분산 \(\sigma^2/n\)이 어떻게 줄어드는지 보여 줍니다. 표본분포의 평균은 모든 \(n\)에서 \(\mu_{\bar{x}} = 100\)으로 유지됩니다.
| 표본 크기 n | 표본평균들의 평균 | SE = σ/√n | 분산 σ²/n |
|---|---|---|---|
| 1 | 100 | 15 | 225 |
| 4 | 100 | 7.5 | 56.25 |
| 9 | 100 | 5 | 25 |
| 25 | 100 | 3 | 9 |
| 36 | 100 | 2.5 | 6.25 |
| 100 | 100 | 1.5 | 2.25 |
| 400 | 100 | 0.75 | 0.5625 |
\(SE\)는 \(\sqrt{n}\)에 의존하므로, 표본 크기를 네 배로 늘리면 표준오차는 절반이 됩니다. 예를 들어 \(n = 9\)에서 \(n = 36\)으로 늘리면 \(SE\)는 5에서 2.5로 줄고, \(n = 25\)에서 \(n = 100\)으로 늘리면 3에서 1.5로 줄어듭니다. 따라서 정밀도를 한 단계씩 더 높이려면 점점 더 많은 데이터가 필요합니다.
표준오차와 표본분포 해석하기
표본이 충분히 크면, 중심극한정리에 따라 \(\bar{x}\)의 표본분포는 평균 \(\mu\), 표준편차 \(SE = \sigma/\sqrt{n}\)인 정규분포에 근사합니다. 이 근사가 성립하면 경험적 법칙(68-95-99.7 법칙)을 표본평균에 적용할 수 있습니다:
- 표본평균의 약 68%는 \(\mu\)를 중심으로 ±1 SE 안에 듭니다.
- 약 95%는 \(\mu\)를 중심으로 ±2 SE 안에 듭니다.
- 약 99.7%는 \(\mu\)를 중심으로 ±3 SE 안에 듭니다.
예시: \(\mu = 100\), \(\sigma = 15\), \(n = 36\)이면 \(SE = 15/\sqrt{36} = 15/6 = 2.5\)입니다. 그러면:
- ±1 SE: 약 97.5에서 102.5 (표본평균의 약 68%)
- ±2 SE: 약 95에서 105 (약 95%)
- ±3 SE: 약 92.5에서 107.5 (약 99.7%)
표준오차와 표준편차. 표준편차 \(\sigma\)는 모집단의 개별 값들이 얼마나 퍼져 있는지를 측정합니다. 표준오차는 표본들마다 표본평균이 얼마나 퍼져 있는지를 측정합니다. \(n > 1\)이면 \(SE\)는 항상 \(\sigma\)보다 작고, \(n\)이 커질수록 줄어듭니다. 반면 \(\sigma\)는 \(n\)에 따라 변하지 않습니다.
중심극한정리가 말하지 않는 것. 중심극한정리는 개별 관측값의 분포가 아니라 표본평균의 분포를 설명합니다. 개별 값들은 모집단이 그러한 것만큼 여전히 넓게 퍼져 있고 치우쳐 있습니다. 관측값이 36개여도 개별 점수는 \(\sigma = 15\)만큼 여전히 변동하지만, 그 평균은 \(SE = 2.5\)만큼만 변동합니다. 근사가 얼마나 빨리 좋아지는지는 모집단의 모양에 따라 다르며, 심하게 치우친 모집단일수록 더 큰 \(n\)이 필요합니다. 흔히 쓰는 경험 법칙은 \(n \ge 30\)이지만, 이는 어디까지나 지침일 뿐입니다.
핵심 용어와 기호
- 모평균 (μ)
- 모집단에 있는 모든 값의 평균입니다. 또한 \(\bar{x}\) 표본분포의 평균이기도 합니다.
- 모표준편차 (σ)
- 모집단의 개별 값들이 \(\mu\) 주변에서 얼마나 변동하는지를 나타내는 척도입니다.
- 표본 크기 (n)
- 각 표본에 포함된 독립된 관측값의 개수입니다.
- 표본평균 (x̄)
- 한 표본에 속한 \(n\)개 관측값의 평균, \(\bar{x} = \frac{1}{n}\sum x_i\)입니다. 표본마다 값이 달라집니다.
- 표본분포
- 모집단에서 크기 \(n\)인 모든 가능한 표본에 걸친, 어떤 통계량(여기서는 \(\bar{x}\))의 분포입니다.
- 표준오차 (SE)
- 평균의 표본분포의 표준편차로, \(SE = \sigma/\sqrt{n}\)입니다.
- 표본평균의 분산
- 표준오차의 제곱, \(\sigma^2/n\)입니다.
- 독립성 / 무작위 표본추출 가정
- 이 공식들은 관측값이 무작위로, 그리고 독립적으로 추출되었다고 가정합니다(또는 표본이 큰 모집단의 작은 일부라고 가정합니다). 편향되었거나 서로 종속된 표본추출에서는 SE 공식이 틀릴 수 있고, 중심극한정리가 적용되지 않을 수도 있습니다. 또한 모집단의 분산은 유한해야 합니다.
자주 묻는 질문
모집단이 반드시 정규분포여야 하나요? 아닙니다. 바로 이 점이 중심극한정리의 강력함입니다. n이 충분히 크면 모집단이 한쪽으로 치우쳐 있어도 표본평균의 분포는 거의 정규분포에 가까워집니다.
"충분히 큰" 표본 크기는 어느 정도인가요? 흔히 \(n \ge 30\)을 기준으로 삼지만, 치우침이 심한 모집단에서는 더 많은 표본이 필요할 수 있습니다.
표본이 클수록 표준오차가 작아지는 이유는? 더 많은 관측값을 평균 내면 무작위 잡음이 서로 상쇄되어, n이 커질수록 평균 추정값이 더 안정적으로 변하기 때문입니다.