Merkezi Limit Teoremi nedir?
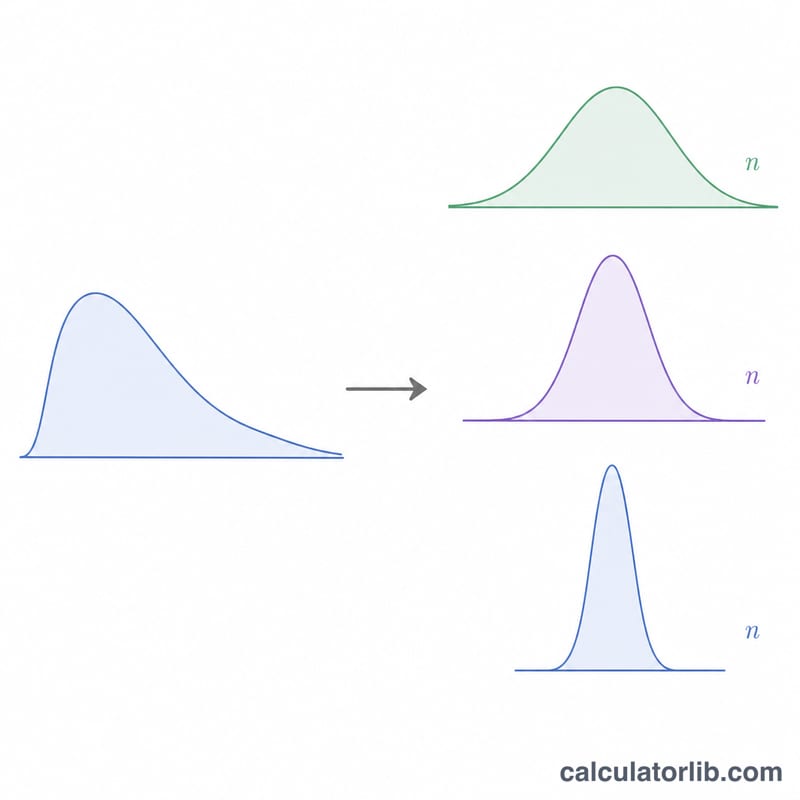
Merkezi Limit Teoremi (MLT), istatistiğin temel taşlarından biridir. Bu teorem; ortalaması \(\mu\) ve standart sapması \(\sigma\) olan herhangi bir ana kütleden tekrar tekrar n büyüklüğünde rastgele örneklemler aldığınızda, örneklem ortalamalarının dağılımının — ana kütlenin biçimi ne olursa olsun — n büyüdükçe yaklaşık olarak normal dağılıma yaklaştığını söyler. Bu hesaplama aracı, söz konusu örnekleme dağılımının iki temel parametresini verir: ortalaması ve standart hatası.
Hesaplama aracı nasıl kullanılır?
Ana kütle ortalamasını (\(\mu\)), ana kütle standart sapmasını (\(\sigma\)) ve örneklem büyüklüğünüzü (n) girin. Araç; örnekleme dağılımının ortalamasını (\(\mu\)'ye eşittir), ortalamanın standart hatasını (SE) ve örneklem ortalamasının varyansını (\(\sigma^2/n\)) döndürür. Yaygın bir pratik kural, n ≥ 30 olduğunda normal yaklaşımın güvenilir hâle geldiğidir.
Formülün açıklaması
MLT, ortalamanın örnekleme dağılımı hakkında bize iki şey söyler. Birincisi, dağılımın merkezi ana kütleyle aynıdır:
$$\mu_{\bar{x}} = \mu$$İkincisi, örneklemler büyüdükçe yayılım daralır:
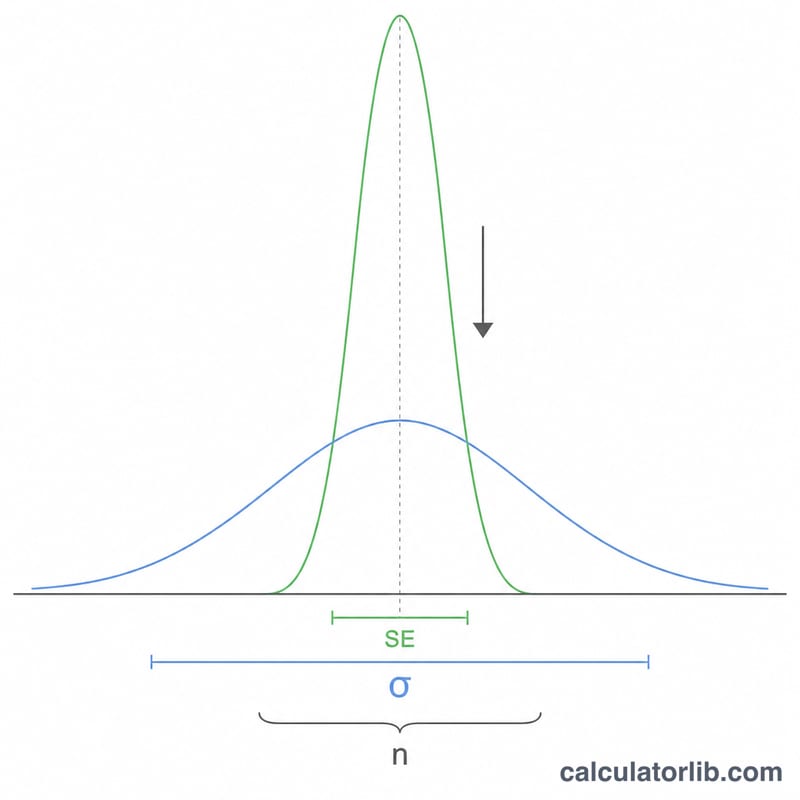
$$SE = \frac{\sigma}{\sqrt{n}}$$\(\sqrt{n}\)'ye bölmek değişkenliği azalttığından, daha büyük örneklemler gerçek ortalamaya dair daha hassas tahminler verir. Örneklem ortalamasının varyansı ise basitçe standart hatanın karesidir, yani \(\sigma^2/n\).
Çözümlü örnek
Diyelim ki bir ana kütlenin \(\mu = 100\) ve \(\sigma = 15\) değerleri var ve n = 36 büyüklüğünde örneklemler alıyorsunuz. Bu durumda \(\mu_{\bar{x}} = 100\) olur ve $$SE = \frac{15}{\sqrt{36}} = \frac{15}{6} = 2{,}5$$ hesaplanır. Örneklem ortalamasının varyansı ise $$\frac{15^2}{36} = \frac{225}{36} = 6{,}25$$ tir. Yani örneklem ortalamaları, yalnızca 2,5'lik bir standart hatayla 100 etrafında sıkıca kümelenir.
Sık sorulan sorular
Ana kütlenin normal dağılması gerekir mi? Hayır. MLT'nin gücü tam da buradadır — yeterince büyük n için, ana kütle çarpık olsa bile ortalamanın örnekleme dağılımı yaklaşık olarak normaldir.
"Yeterince büyük" örneklem büyüklüğü nedir? Yaygın bir kılavuz ilke n ≥ 30'dur; ancak ileri derecede çarpık ana kütleler için daha büyük örneklemler gerekebilir.
Örneklem büyüdükçe standart hata neden küçülür? Daha fazla gözlemin ortalamasını almak rastgele gürültüyü dengeler; böylece n arttıkça ortalama tahmini daha kararlı hâle gelir.
Örneklem Büyüklüğünün Standart Hataya Etkisi
Tablo, anakütle ortalamasını \(\mu = 100\) ve anakütle standart sapmasını \(\sigma = 15\) olarak sabitler. Örneklem büyüklüğü \(n\) arttıkça standart hatanın \(SE = \sigma/\sqrt{n}\) ve örneklem ortalamasının varyansının \(\sigma^2/n\) nasıl küçüldüğünü gösterir. Örnekleme dağılımının ortalaması her \(n\) için \(\mu_{\bar{x}} = 100\) değerinde kalır.
| Örneklem büyüklüğü n | Örneklem ortalamalarının ortalaması | SE = σ/√n | Varyans σ²/n |
|---|---|---|---|
| 1 | 100 | 15 | 225 |
| 4 | 100 | 7.5 | 56.25 |
| 9 | 100 | 5 | 25 |
| 25 | 100 | 3 | 9 |
| 36 | 100 | 2.5 | 6.25 |
| 100 | 100 | 1.5 | 2.25 |
| 400 | 100 | 0.75 | 0.5625 |
\(SE\) değeri \(\sqrt{n}\) değerine bağlı olduğundan, örneklem büyüklüğünü dört katına çıkarmak standart hatayı yarıya indirir. Örneğin \(n = 9\) değerinden \(n = 36\) değerine geçmek \(SE\) değerini 5'ten 2.5'e, \(n = 25\) değerinden \(n = 100\) değerine geçmek ise 3'ten 1.5'e düşürür. Bu nedenle hassasiyette her ek kazanım, giderek daha fazla veri gerektirir.
Standart Hatanın ve Örnekleme Dağılımının Yorumlanması
Yeterince büyük bir rastgele örneklem için Merkezi Limit Teoremi, \(\bar{x}\) değerinin örnekleme dağılımının ortalaması \(\mu\) ve standart sapması \(SE = \sigma/\sqrt{n}\) olan yaklaşık olarak normal olduğunu söyler. Bu yaklaşım geçerli olduğunda, ampirik kural örneklem ortalamalarına uygulanır:
- Örneklem ortalamalarının yaklaşık %68'i \(\mu\) etrafında ±1 SE aralığına düşer.
- Yaklaşık %95'i \(\mu\) etrafında ±2 SE aralığına düşer.
- Yaklaşık %99.7'si \(\mu\) etrafında ±3 SE aralığına düşer.
Örnek: \(\mu = 100\), \(\sigma = 15\) ve \(n = 36\) için \(SE = 15/\sqrt{36} = 15/6 = 2.5\) olur. Buna göre:
- ±1 SE: yaklaşık 97.5 ile 102.5 arası (örneklem ortalamalarının ≈%68'i)
- ±2 SE: yaklaşık 95 ile 105 arası (≈%95)
- ±3 SE: yaklaşık 92.5 ile 107.5 arası (≈%99.7)
Standart hata ile standart sapma. Standart sapma \(\sigma\), anakütledeki bireysel değerlerin ne kadar yayıldığını ölçer. Standart hata ise örneklemden örnekleme örneklem ortalamalarının ne kadar yayıldığını ölçer. \(n > 1\) olduğunda SE her zaman \(\sigma\) değerinden küçüktür ve \(n\) arttıkça küçülür; \(\sigma\) ise \(n\) ile değişmez.
Merkezi Limit Teoremi'nin söylemediği. Teorem, bireysel gözlemlerin değil, örneklem ortalamalarının dağılımını tanımlar. Bireysel değerler, anakütle ne kadar yayılmış ve çarpıksa o kadar yayılmış ve çarpık kalır. 36 gözlemle bireysel puanlar hâlâ \(\sigma = 15\) ile değişir, ancak ortalamaları yalnızca \(SE = 2.5\) ile değişir. Yaklaşımın ne kadar hızlı iyileştiği anakütlenin şekline bağlıdır: çok çarpık anakütleler daha büyük \(n\) gerektirir. Yaygın bir pratik kural \(n \ge 30\) değeridir, ancak bu yalnızca bir yönlendirmedir.
Temel Terimler ve Semboller
- Anakütle ortalaması (μ)
- Anakütledeki tüm değerlerin ortalaması. Aynı zamanda \(\bar{x}\) değerinin örnekleme dağılımının ortalamasıdır.
- Anakütle standart sapması (σ)
- Anakütledeki bireysel değerlerin \(\mu\) etrafında ne kadar değiştiğinin ölçüsü.
- Örneklem büyüklüğü (n)
- Her örneklemdeki bağımsız gözlemlerin sayısı.
- Örneklem ortalaması (x̄)
- Bir örneklemdeki \(n\) gözlemin ortalaması, \(\bar{x} = \frac{1}{n}\sum x_i\). Örneklemden örnekleme değişir.
- Örnekleme dağılımı
- Bir istatistiğin, burada \(\bar{x}\) değerinin, anakütleden alınabilecek büyüklüğü \(n\) olan tüm örneklemler üzerindeki dağılımı.
- Standart hata (SE)
- Ortalamanın örnekleme dağılımının standart sapması: \(SE = \sigma/\sqrt{n}\).
- Örneklem ortalamasının varyansı
- Standart hatanın karesi: \(\sigma^2/n\).
- Bağımsızlık / rastgele örnekleme varsayımı
- Formüller, gözlemlerin rastgele ve bağımsız olarak çekildiğini (veya örneklemin büyük bir anakütlenin küçük bir kesri olduğunu) varsayar. Yanlı veya bağımlı örnekleme, SE formülünü yanlış hale getirebilir ve Merkezi Limit Teoremi geçerli olmayabilir. Anakütlenin ayrıca sonlu bir varyansa sahip olması gerekir.