¿Qué es el Teorema Central del Límite?
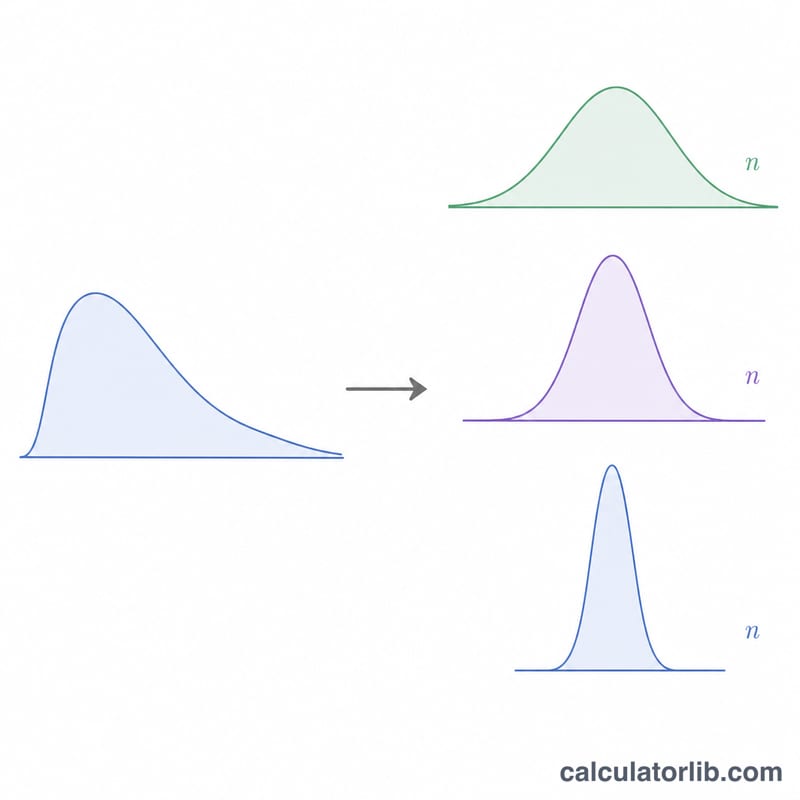
El Teorema Central del Límite (TCL) es uno de los pilares de la estadística. Afirma que, al extraer muestras aleatorias repetidas de tamaño n de cualquier población con media μ y desviación típica σ, la distribución de las medias muestrales se aproxima cada vez más a una normal a medida que crece n, sin importar la forma de la población original. Esta calculadora te ofrece los dos parámetros clave de esa distribución muestral: su media y su error estándar.
Cómo usar esta calculadora
Introduce la media de la población (μ), la desviación típica de la población (σ) y el tamaño de tu muestra (n). La herramienta devuelve la media de la distribución muestral (que coincide con μ), el error estándar de la media (EE) y la varianza de la media muestral (\(\sigma^2/n\)). Una regla práctica habitual indica que con n ≥ 30 la aproximación normal resulta fiable.
La fórmula explicada
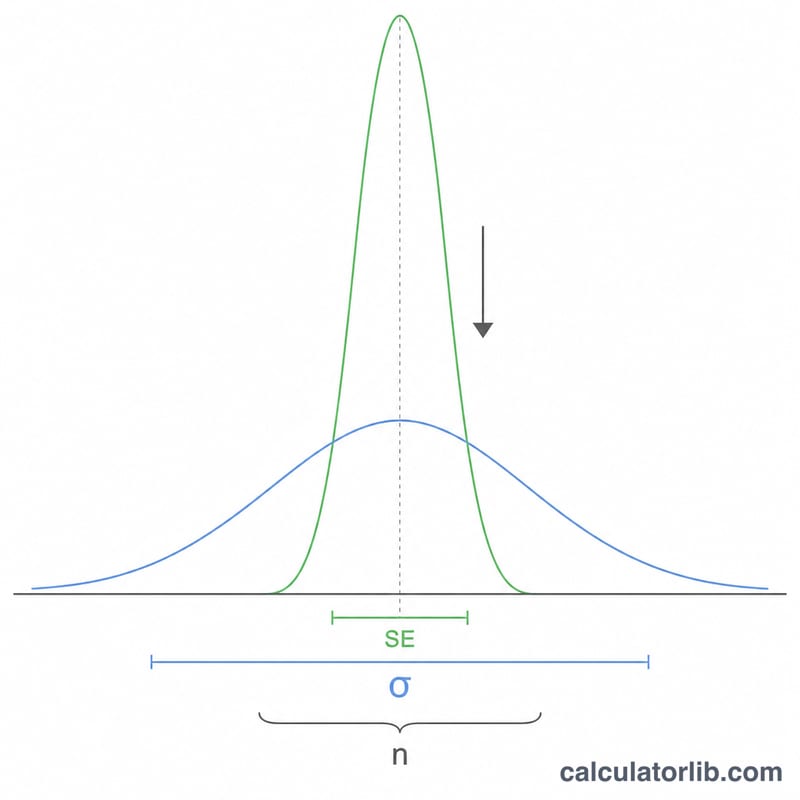
El TCL nos dice dos cosas sobre la distribución muestral de la media. Primero, su centro es el mismo que el de la población: $$\mu_{\bar{x}} = \mu$$ Segundo, su dispersión disminuye a medida que las muestras se hacen mayores: $$EE = \frac{\sigma}{\sqrt{n}}$$ Como dividir entre \(\sqrt{n}\) reduce la variabilidad, las muestras más grandes ofrecen estimaciones más precisas de la verdadera media. La varianza de la media muestral es simplemente el cuadrado del error estándar, \(\sigma^2/n\).
Ejemplo resuelto
Supongamos que una población tiene \(\mu = 100\) y \(\sigma = 15\), y que extraes muestras de tamaño \(n = 36\). Entonces \(\mu_{\bar{x}} = 100\) y $$EE = \frac{15}{\sqrt{36}} = \frac{15}{6} = 2{,}5$$ La varianza de la media muestral es $$\frac{15^2}{36} = \frac{225}{36} = 6{,}25$$ Así pues, las medias muestrales se agrupan estrechamente en torno a 100, con un error estándar de tan solo 2,5.
Cómo el tamaño de la muestra cambia el error estándar
La tabla fija la media poblacional en \(\mu = 100\) y la desviación estándar poblacional en \(\sigma = 15\). Muestra cómo el error estándar \(SE = \sigma/\sqrt{n}\) y la varianza de la media muestral \(\sigma^2/n\) disminuyen a medida que crece el tamaño de la muestra \(n\). La media de la distribución muestral se mantiene en \(\mu_{\bar{x}} = 100\) para cada \(n\).
| Tamaño de muestra n | Media de las medias muestrales | SE = σ/√n | Varianza σ²/n |
|---|---|---|---|
| 1 | 100 | 15 | 225 |
| 4 | 100 | 7.5 | 56.25 |
| 9 | 100 | 5 | 25 |
| 25 | 100 | 3 | 9 |
| 36 | 100 | 2.5 | 6.25 |
| 100 | 100 | 1.5 | 2.25 |
| 400 | 100 | 0.75 | 0.5625 |
Como \(SE\) depende de \(\sqrt{n}\), cuadruplicar el tamaño de la muestra reduce a la mitad el error estándar. Por ejemplo, pasar de \(n = 9\) a \(n = 36\) reduce \(SE\) de 5 a 2.5, y pasar de \(n = 25\) a \(n = 100\) lo reduce de 3 a 1.5. Por eso, obtener cada mejora adicional de precisión requiere progresivamente más datos.
Interpretación del error estándar y de la distribución muestral
Para una muestra aleatoria suficientemente grande, el teorema del límite central establece que la distribución muestral de \(\bar{x}\) es aproximadamente normal, con media \(\mu\) y desviación estándar \(SE = \sigma/\sqrt{n}\). Una vez que esta aproximación se cumple, la regla empírica se aplica a las medias muestrales:
- Aproximadamente el 68% de las medias muestrales caen dentro de ±1 SE de \(\mu\).
- Aproximadamente el 95% caen dentro de ±2 SE de \(\mu\).
- Aproximadamente el 99.7% caen dentro de ±3 SE de \(\mu\).
Ejemplo: con \(\mu = 100\), \(\sigma = 15\) y \(n = 36\), \(SE = 15/\sqrt{36} = 15/6 = 2.5\). Entonces:
- ±1 SE: aproximadamente de 97.5 a 102.5 (≈68% de las medias muestrales)
- ±2 SE: aproximadamente de 95 a 105 (≈95%)
- ±3 SE: aproximadamente de 92.5 a 107.5 (≈99.7%)
Error estándar frente a desviación estándar. La desviación estándar \(\sigma\) mide cuánto se dispersan los valores individuales en la población. El error estándar mide cuánto se dispersan las medias muestrales de una muestra a otra. El SE siempre es menor que \(\sigma\) cuando \(n > 1\), y disminuye a medida que \(n\) crece, mientras que \(\sigma\) no cambia con \(n\).
Lo que el TLC no dice. Describe la distribución de las medias muestrales, no la de las observaciones individuales. Los valores individuales siguen estando tan dispersos y tan sesgados como lo está la población. Con 36 observaciones, las puntuaciones individuales siguen variando con \(\sigma = 15\), pero su promedio varía solo con \(SE = 2.5\). La rapidez con la que la aproximación resulta buena depende de la forma de la población: las poblaciones muy asimétricas necesitan un \(n\) mayor. Una regla práctica habitual es \(n \ge 30\), pero es solo una orientación.
Términos y símbolos clave
- Media poblacional (μ)
- El promedio de todos los valores de la población. También es la media de la distribución muestral de \(\bar{x}\).
- Desviación estándar poblacional (σ)
- Medida de cuánto varían los valores individuales de la población alrededor de \(\mu\).
- Tamaño de muestra (n)
- Número de observaciones independientes en cada muestra.
- Media muestral (x̄)
- El promedio de las \(n\) observaciones de una muestra, \(\bar{x} = \frac{1}{n}\sum x_i\). Varía de una muestra a otra.
- Distribución muestral
- La distribución de un estadístico, aquí \(\bar{x}\), sobre todas las muestras posibles de tamaño \(n\) de la población.
- Error estándar (SE)
- La desviación estándar de la distribución muestral de la media: \(SE = \sigma/\sqrt{n}\).
- Varianza de la media muestral
- El cuadrado del error estándar: \(\sigma^2/n\).
- Supuesto de independencia / muestreo aleatorio
- Las fórmulas suponen que las observaciones se extraen de forma aleatoria e independiente (o que la muestra es una pequeña fracción de una población grande). Un muestreo sesgado o dependiente puede hacer incorrecta la fórmula del SE, y es posible que el TLC no se aplique. La población también debe tener varianza finita.
Preguntas frecuentes
¿La población tiene que ser normal? No. Ahí reside la potencia del TCL: con un n lo bastante grande, la distribución muestral de la media es aproximadamente normal aunque la población esté sesgada.
¿Qué tamaño de muestra es "lo bastante grande"? Una pauta común es n ≥ 30, aunque las poblaciones muy asimétricas pueden requerir más.
¿Por qué el error estándar disminuye con muestras más grandes? Al promediar más observaciones, el ruido aleatorio se compensa, por lo que la estimación de la media se vuelve más estable a medida que aumenta n.