什么是中心极限定理?
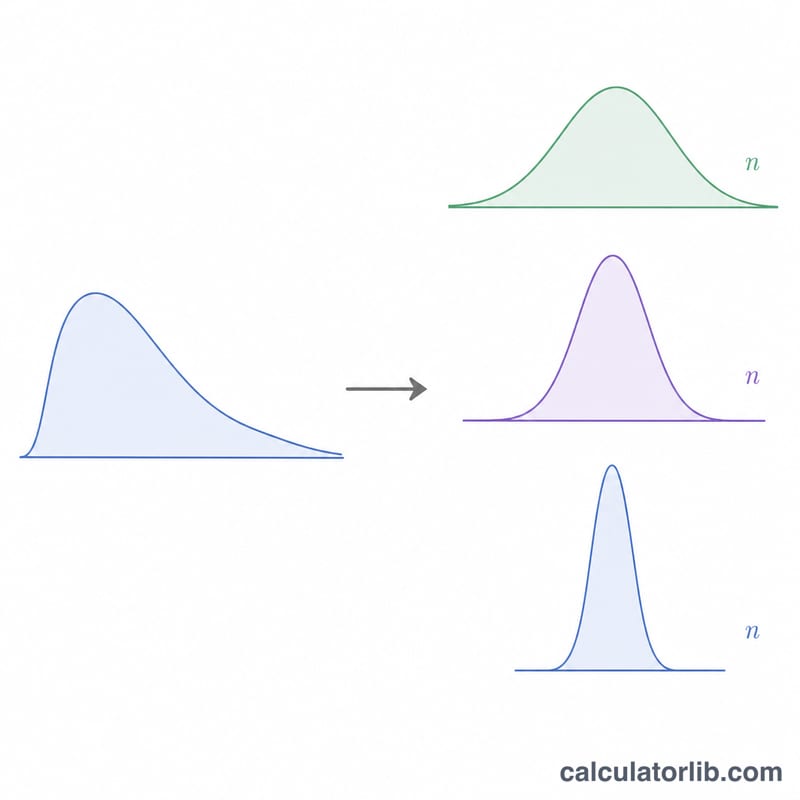
中心极限定理(Central Limit Theorem,简称 CLT)是统计学的基石之一。它指出:无论原始总体服从什么分布,只要从一个均值为 \(\mu\)、标准差为 \(\sigma\) 的总体中反复抽取容量为 \(n\) 的随机样本,随着 \(n\) 不断增大,这些样本均值的分布都会逐渐趋近于正态分布。本计算器可以帮你算出该抽样分布的两个核心参数:均值和标准误。
如何使用本计算器
输入总体均值(\(\mu\))、总体标准差(\(\sigma\))以及你的样本量(\(n\)),工具就会给出抽样分布的均值(等于 \(\mu\))、均值的标准误(SE)以及样本均值的方差(\(\sigma^2/n\))。一个常用的经验法则是:当 \(n \geq 30\) 时,正态近似就比较可靠了。
公式详解
中心极限定理告诉了我们关于样本均值抽样分布的两件事。第一,它的中心与总体均值一致:\(\mu_{\bar{x}} = \mu\)。第二,样本越大,分布越集中:\(SE = \sigma / \sqrt{n}\)。由于除以 \(\sqrt{n}\) 会缩小波动,因此样本量越大,对真实均值的估计就越精确。样本均值的方差则等于标准误的平方,即 \(\sigma^2/n\)。
$$\mu_{\bar{x}} = \text{Mean }(\mu) \qquad SE = \frac{\text{SD }(\sigma)}{\sqrt{\text{Sample size }(n)}}$$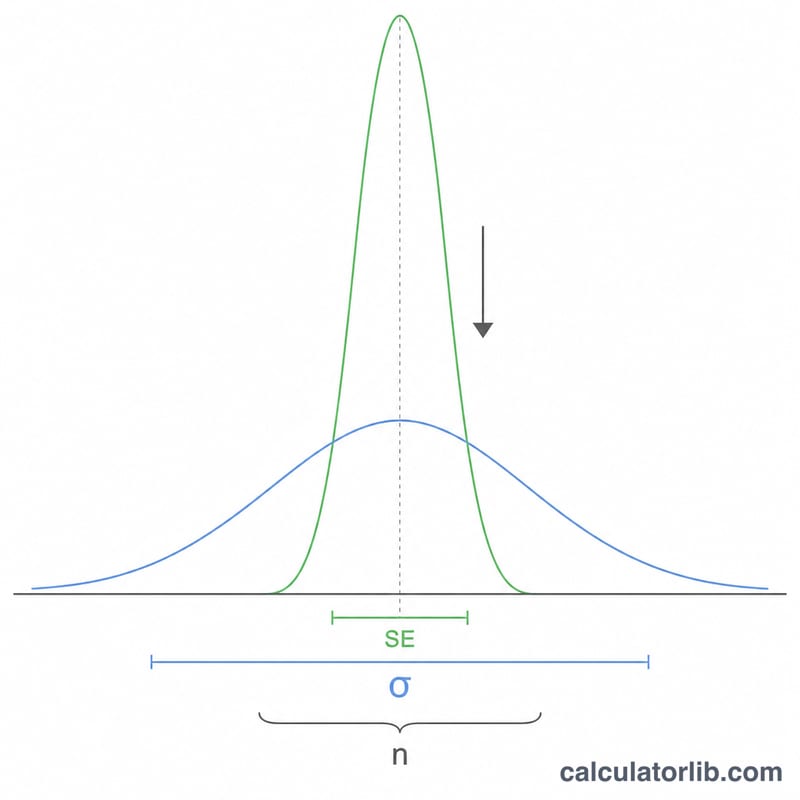
实例演示
假设某总体的 \(\mu = 100\)、\(\sigma = 15\),你抽取容量为 \(n = 36\) 的样本。那么 \(\mu_{\bar{x}} = 100\),
$$SE = \frac{15}{\sqrt{36}} = \frac{15}{6} = 2.5$$样本均值的方差为
$$\frac{15^2}{36} = \frac{225}{36} = 6.25$$也就是说,样本均值会紧密地集中在 100 附近,标准误仅为 2.5。
样本量如何影响标准误
该表将总体均值固定为 \(\mu = 100\),总体标准差固定为 \(\sigma = 15\)。它展示了随着样本量 \(n\) 增大,标准误 \(SE = \sigma/\sqrt{n}\) 与样本均值的方差 \(\sigma^2/n\) 如何缩小。对于每个 \(n\),抽样分布的均值都保持为 \(\mu_{\bar{x}} = 100\)。
| 样本量 n | 样本均值的均值 | SE = σ/√n | 方差 σ²/n |
|---|---|---|---|
| 1 | 100 | 15 | 225 |
| 4 | 100 | 7.5 | 56.25 |
| 9 | 100 | 5 | 25 |
| 25 | 100 | 3 | 9 |
| 36 | 100 | 2.5 | 6.25 |
| 100 | 100 | 1.5 | 2.25 |
| 400 | 100 | 0.75 | 0.5625 |
由于 \(SE\) 与 \(\sqrt{n}\) 相关,样本量增加为原来的 4 倍,标准误就减半。例如,从 \(n = 9\) 增加到 \(n = 36\),\(SE\) 从 5 降至 2.5;从 \(n = 25\) 增加到 \(n = 100\),它从 3 降至 1.5。因此,每多获得一分精度,所需的数据都会越来越多。
标准误与抽样分布的解读
当随机样本足够大时,中心极限定理指出,\(\bar{x}\) 的抽样分布近似服从正态分布,其均值为 \(\mu\),标准差为 \(SE = \sigma/\sqrt{n}\)。一旦这一近似成立,经验法则即适用于样本均值:
- 约 68% 的样本均值落在 \(\mu\) 的 ±1 个 SE 范围内。
- 约 95% 的样本均值落在 \(\mu\) 的 ±2 个 SE 范围内。
- 约 99.7% 的样本均值落在 \(\mu\) 的 ±3 个 SE 范围内。
示例:当 \(\mu = 100\)、\(\sigma = 15\)、\(n = 36\) 时,\(SE = 15/\sqrt{36} = 15/6 = 2.5\)。于是:
- ±1 个 SE:约 97.5 至 102.5(约 68% 的样本均值)
- ±2 个 SE:约 95 至 105(约 95%)
- ±3 个 SE:约 92.5 至 107.5(约 99.7%)
标准误与标准差。标准差 \(\sigma\) 衡量总体中各个数值的分散程度。标准误衡量不同样本之间样本均值的分散程度。当 \(n > 1\) 时,SE 总是小于 \(\sigma\),并且随着 \(n\) 增大而缩小,而 \(\sigma\) 不随 \(n\) 变化。
中心极限定理并未说明的内容。它描述的是样本均值的分布,而不是单个观测值的分布。单个数值的分散程度和偏斜程度仍与总体保持一致。对于 36 个观测值,单个分数的变化仍由 \(\sigma = 15\) 决定,但它们的平均值只按 \(SE = 2.5\) 变化。近似达到良好程度的速度取决于总体形状:高度偏斜的总体需要更大的 \(n\)。一个常见的经验法则是 \(n \ge 30\),但它只是一个指导原则。
关键术语与符号
- 总体均值 (μ)
- 总体中所有数值的平均值。它也是 \(\bar{x}\) 抽样分布的均值。
- 总体标准差 (σ)
- 衡量总体中各个数值围绕 \(\mu\) 变化程度的指标。
- 样本量 (n)
- 每个样本中独立观测值的数量。
- 样本均值 (x̄)
- 一个样本中 \(n\) 个观测值的平均值,\(\bar{x} = \frac{1}{n}\sum x_i\)。它随样本不同而变化。
- 抽样分布
- 统计量(此处为 \(\bar{x}\))在总体中所有可能的、样本量为 \(n\) 的样本上的分布。
- 标准误 (SE)
- 均值抽样分布的标准差:\(SE = \sigma/\sqrt{n}\)。
- 样本均值的方差
- 标准误的平方:\(\sigma^2/n\)。
- 独立性 / 随机抽样假设
- 这些公式假设观测值是随机且独立抽取的(或样本只占大总体的很小一部分)。有偏或相依的抽样可能使标准误公式失效,中心极限定理也可能不适用。总体还必须具有有限方差。
常见问题
总体一定要服从正态分布吗?不需要。这正是中心极限定理的强大之处——只要 \(n\) 足够大,即便总体是偏态分布,样本均值的抽样分布也近似服从正态分布。
样本量多大才算"足够大"?常用的标准是 \(n \geq 30\),不过对于严重偏态的总体,可能需要更大的样本量。
为什么样本越大,标准误越小?对更多观测值取平均,可以抵消随机噪声,因此 \(n\) 越大,对均值的估计就越稳定。