सांख्यिकी में रेंज क्या होती है?
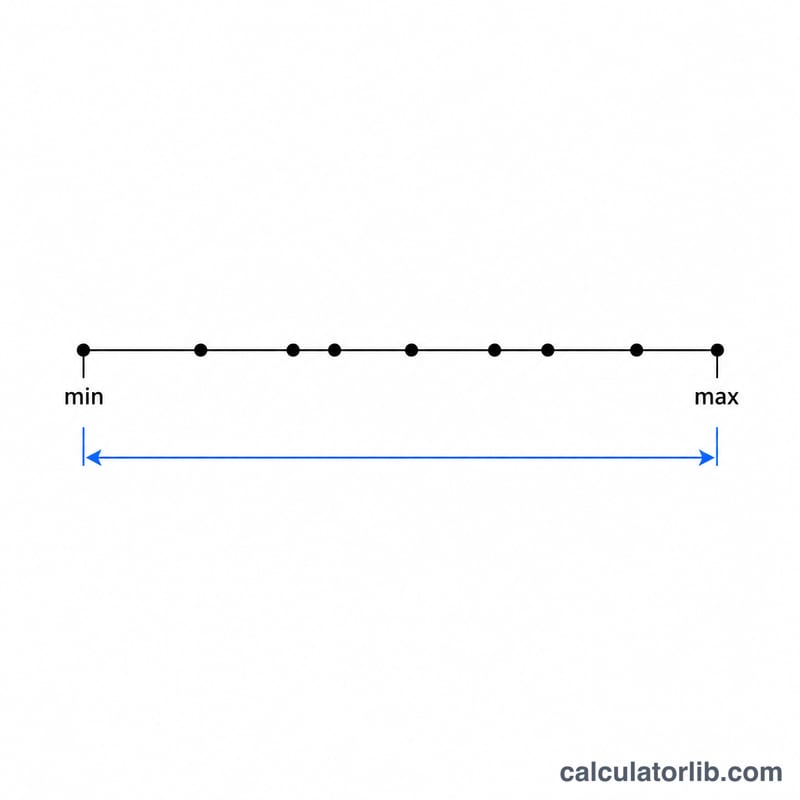
किसी डेटा सेट में फैलाव मापने का सबसे आसान तरीका रेंज है। यह बताती है कि सबसे बड़ी और सबसे छोटी संख्या के बीच कितना अंतर है — इसके लिए अधिकतम मान में से न्यूनतम मान को घटाया जाता है। रेंज जितनी बड़ी होगी, मान उतने ही ज़्यादा फैले हुए होंगे; और रेंज जितनी छोटी होगी, मान उतने ही पास-पास सिमटे रहेंगे।
इस कैलकुलेटर का उपयोग कैसे करें
अपनी संख्याओं को बॉक्स में टाइप करें, और उन्हें कॉमा या स्पेस से अलग करें (उदाहरण के लिए, 4, 8, 15, 16, 23, 42)। कैलकुलेटर पूरी सूची को पढ़ता है, अधिकतम और न्यूनतम मान ढूँढता है, उन्हें घटाता है, और रेंज के साथ-साथ आपकी डाली गई संख्याओं की कुल गिनती भी दिखा देता है। पूर्णांक और दशमलव दोनों चलते हैं, यहाँ तक कि ऋणात्मक संख्याएँ भी।
फ़ॉर्मूला समझें
रेंज इस तरह परिभाषित की जाती है:
$$\text{रेंज} = \max\!\left(\text{अधिकतम मान}\right) - \min\!\left(\text{न्यूनतम मान}\right)$$
चूँकि यह केवल दो चरम (extreme) मानों पर निर्भर करती है, इसलिए रेंज निकालना बेहद आसान है — लेकिन यह आउटलायर (असामान्य मानों) के प्रति बहुत संवेदनशील भी होती है। एक अकेली असामान्य रूप से ऊँची या नीची संख्या ही इसे काफ़ी बढ़ा सकती है। यही वजह है कि रेंज को अक्सर स्टैंडर्ड डेविएशन या इंटरक्वार्टाइल रेंज जैसे मापों के साथ ही प्रस्तुत किया जाता है।
हल किया हुआ उदाहरण
मान लीजिए आपका डेटा सेट है 4, 8, 15, 16, 23, 42। यहाँ अधिकतम मान 42 है और न्यूनतम मान 4। इसलिए रेंज होगी \(42 - 4 = 38\)। हालाँकि ज़्यादातर मान 4 और 23 के बीच ही आते हैं, फिर भी 42 की संख्या रेंज को 38 तक पहुँचा देती है — यही दिखाता है कि रेंज चरम मानों के प्रति कितनी संवेदनशील होती है।
आउटलायर और डेटा का आकार रेंज को कैसे बदलता है
रेंज केवल दो अत्यंत मानों पर निर्भर करती है, इसलिए उनके बीच के डेटा का आकार मायने नहीं रखता। तालिका \(\text{Range} = \max - \min\) का उपयोग करके पाँच छोटे डेटा सेटों की तुलना करती है।
| डेटा सेट | अधिकतम | न्यूनतम | रेंज | टिप्पणी |
|---|---|---|---|---|
| 5, 5, 5, 5 | 5 | 5 | 0 | सभी मान समान: कोई फैलाव नहीं। |
| 10, 11, 12, 13 | 13 | 10 | 3 | कसा हुआ समूह: छोटी रेंज। |
| 10, 11, 12, 13, 50 | 50 | 10 | 40 | वही समूह प्लस एक आउटलायर (50): पाँच में से चार मान अपरिवर्तित होने के बावजूद रेंज 3 से बढ़कर 40 हो जाती है। |
| -8, -2, 0, 5 | 5 | -8 | 13 | ऋणात्मक संख्याएँ: \(5 - (-8) = 13\)। |
| 1.5, 2.25, 3.75 | 3.75 | 1.5 | 2.25 | दशमलव: \(3.75 - 1.5 = 2.25\)। |
तीसरी पंक्ति रेंज की मुख्य कमजोरी दिखाती है: एक अकेला अत्यधिक मान इसे नाटकीय रूप से बदल सकता है, जबकि मानों का क्रम इसे कभी प्रभावित नहीं करता।
रेंज की व्याख्या
रेंज 0 का अर्थ है कि अधिकतम और न्यूनतम बराबर हैं, इसलिए डेटा सेट का हर मान समान है। 0 से अधिक कोई भी रेंज दर्शाती है कि मान भिन्न हैं, और बड़ी रेंज सबसे छोटे और सबसे बड़े अवलोकनों के बीच अधिक विस्तृत फैलाव का संकेत देती है।
रेंज डेटा की अपनी इकाइयों में व्यक्त होती है। वर्षों में आयु की रेंज 40 का अर्थ है 40 वर्ष का अंतर; डॉलर में कीमतों की रेंज 40 का अर्थ है $40 का अंतर। इसी कारण, अलग-अलग इकाइयों में मापे गए डेटा सेटों (जैसे किलोग्राम और सेंटीमीटर) या बहुत अलग पैमानों (जैसे घरों की कीमतें और कॉफी की कीमतें) के बीच रेंज की सार्थक तुलना नहीं की जा सकती। बड़ी संख्या का अर्थ आवश्यक रूप से अधिक सापेक्ष परिवर्तनशीलता नहीं होता।
नमूना आकार भी मायने रखता है। जब किसी डेटा सेट में अधिक अवलोकन जोड़े जाते हैं, तो रेंज वही रह सकती है या बढ़ सकती है, लेकिन कभी घट नहीं सकती, क्योंकि मौजूदा अधिकतम और न्यूनतम डेटा में बने रहते हैं। इसलिए बड़े नमूने प्रायः बड़ी रेंज दिखाते हैं, क्योंकि उनमें अत्यधिक मान शामिल होने के अधिक अवसर होते हैं। इससे रेंज बहुत अलग आकार के डेटा सेटों की तुलना के लिए एक कमजोर आधार बन जाती है।
केवल दो मानों का उपयोग करने के कारण, रेंज आउटलायर के प्रति अत्यधिक संवेदनशील होती है और यह नहीं बताती कि शेष मान कैसे वितरित हैं। इसके बजाय दो माप आमतौर पर उपयोग किए जाते हैं:
- अंतरचतुर्थक रेंज (IQR): \(\text{IQR} = Q_3 - Q_1\) डेटा के बीच के 50% के फैलाव का वर्णन करती है। यह सबसे निचले और सबसे ऊपरी चतुर्थांशों को नज़रअंदाज़ करती है, इसलिए आउटलायर इसे प्रभावित नहीं करते।
- मानक विचलन: हर मान का उपयोग करता है और माध्य से विशिष्ट दूरी मापता है, जिससे यह फैलाव का अधिक पूर्ण सारांश बनता है, हालांकि यह भी आउटलायर से प्रभावित होता है।
मुख्य शब्द
- रेंज
- डेटा सेट में सबसे बड़े और सबसे छोटे मानों के बीच का अंतर: \(\max - \min\)। यह कभी ऋणात्मक नहीं होती।
- अधिकतम
- डेटा सेट में सबसे बड़ा मान।
- न्यूनतम
- डेटा सेट में सबसे छोटा मान। ऋणात्मक संख्याओं के साथ, न्यूनतम सबसे अधिक ऋणात्मक मान होता है।
- आउटलायर
- एक मान जो डेटा के मुख्य भाग से असामान्य रूप से दूर स्थित होता है। आउटलायर रेंज को काफी प्रभावित कर सकते हैं।
- प्रसार (फैलाव)
- डेटा सेट के मान कितने व्यापक रूप से बिखरे हुए हैं। रेंज, IQR, प्रसरण और मानक विचलन सभी प्रसार के माप हैं।
- अंतरचतुर्थक रेंज (IQR)
- तृतीय चतुर्थांश (Q3) और प्रथम चतुर्थांश (Q1) के बीच का अंतर: \(Q_3 - Q_1\)। यह मानों के बीच के 50% को कवर करती है और आउटलायर से प्रभावित नहीं होती।
- मानक विचलन
- माध्य से मानों की विशिष्ट दूरी का माप, डेटा की उसी इकाई में। यह प्रसरण का वर्गमूल है।
- डेटा सेट / नमूना आकार (गणना)
- डेटा सेट मानों का वह संग्रह है जिसका विश्लेषण किया जा रहा है; नमूना आकार, या गणना, उसमें मानों की संख्या है, जिसे आमतौर पर \(n\) लिखा जाता है।
अक्सर पूछे जाने वाले सवाल
क्या रेंज ऋणात्मक हो सकती है? नहीं। चूँकि आप हमेशा सबसे बड़े मान में से सबसे छोटे मान को घटाते हैं, इसलिए रेंज या तो शून्य होगी या धनात्मक। यह शून्य तभी होती है जब हर मान एक जैसा हो।
क्या रेंज पूरे डेटा का इस्तेमाल करती है? नहीं — सिर्फ़ दो चरम मानों का। इसी वजह से इसे समझना तो आसान है, लेकिन जब डेटा में आउटलायर मौजूद हों तो यह कुल विविधता का अच्छा सारांश नहीं दे पाती।
रेंज की इकाई क्या होती है? वही जो आपके मूल डेटा की होती है। अगर आपने सेंटीमीटर में माप लिया है, तो रेंज भी सेंटीमीटर में ही होगी।