フィッシャーの正確確率検定とは?
フィッシャーの正確確率検定(Fisher's Exact Test)は、2×2分割表における2つのカテゴリ変数に関連があるかどうかを調べる手法です。カイ二乗検定が近似的なp値を求めるのに対し、本検定は「正確な」p値を計算します。そのため、サンプルサイズが小さい場合や、各セルの期待度数が少ない表でも信頼性の高い結果が得られます。生物学・医学・社会科学などの分野で広く用いられています。
この計算ツールの使い方
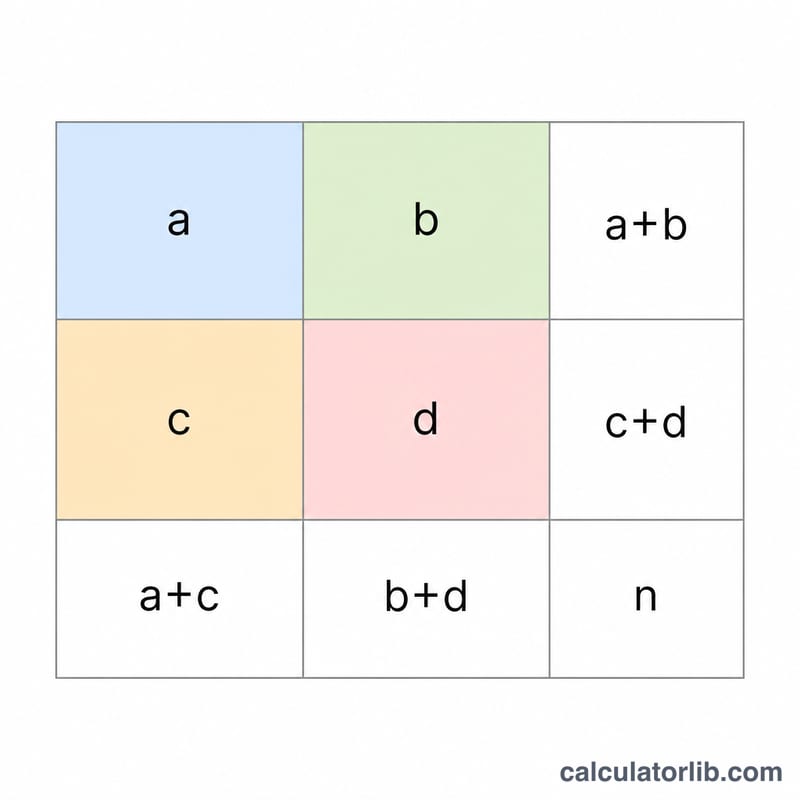
2×2表の4つのセルの度数を入力してください。aとbが1行目、cとdが2行目を構成します。本ツールは、観測された表が得られる超幾何分布に基づく正確な確率と、両側p値を計算します。両側p値は、行と列の合計(周辺度数)が同じ表のうち、観測された表と同程度かそれ以下の確率しか持たないすべての表の確率を合計したものです。
計算式の解説
周辺度数を固定したとき、ある特定の表が得られる確率は超幾何分布に従います。 $$p = \dfrac{(a+b)!\,(c+d)!\,(a+c)!\,(b+d)!}{n!\;a!\,b!\,c!\,d!}$$ ここで \(n = a + b + c + d\) です。両側p値は、周辺度数が同じ表のうち、観測された確率以下となるすべての表についてpを合計して求めます。 $$P_{\text{two-sided}} = \sum_{\,p_i \le p_{\text{obs}}} p_i$$
計算例
\(a = 8\)、\(b = 2\)、\(c = 1\)、\(d = 5\)(\(n = 16\))の表を例にとります。この表そのものが得られる確率は約0.01865です。これと同程度かそれ以下の確率を持つすべての表を合計すると、両側p値は約0.0349となります。これは有意水準0.05のもとで統計的に有意な関連があることを示唆しています。
フィッシャーの正確検定の結果の解釈
- αを下回る場合。 p値が選択した有意水準(一般的には0.05)以下であれば、2つの変数が独立であった場合にこのデータが得られる可能性は低いことになるため、独立性の帰無仮説を棄却します。例では、p ≈ 0.035 は 0.05 を下回っています。
- αを上回る場合。 p値がαを上回る場合、データは独立性とおおむね整合しており、帰無仮説を棄却できません。
- 効果量ではなくエビデンス。 p値は、独立性を仮定したときに表がどれだけ意外かを測るものです。関連の強さや実務上の重要性を測るものではありません。効果量については、オッズ比(ここでは (8 × 5)/(2 × 1) = 20)とその信頼区間を見てください。度数が少ない場合、これらの推定値は非常に不正確になります。
- 片側検定と両側検定。 片側p値は、選んだ一方向においてのみ、観測された表と同等かそれ以上に極端な表を数えます(例:a ≥ 8 の場合は約 0.0245 になります)。両側p値は、両方向の極端な表を数えます。両側p値の定義はいくつかありますが、ここで用いる一般的な定義では、観測された表の確率以下となるすべての表を合計します。方向は、データを見る前に決めておくべきです。
- 周辺度数を条件とする。 フィッシャーの検定では、行と列の合計を固定されたものとみなし、その中で度数をどのように配置できるかを考えます。これはどの標本サイズでも正確ですが、p値が離散的な値しかとれないため、保守的になる場合があります。つまり、実際の誤り率が名目上のαを下回ることがあります。
- 有意でないことは「関連なし」を意味しない。 p値が大きいことは、単に標本が小さく検出力が低いことを反映しているだけかもしれません。関連が存在しないことの証明ではありません。
- 多重検定。 多数の検定を行うと、偶然によって一部は0.05を下回ります。ボンferroni補正などで調整するか、実施した検定の数を併せて報告してください。
フィッシャーの正確検定の主要用語
- 2×2分割表
- 観測値を2つの二値変数で交差分類し、4つのセルの度数を与える表です。
- セル度数 a、b、c、d
- 4つの度数です。aとbは1行目(左、右)、cとdは2行目です。これらは非負の整数でなければならず、n = a + b + c + d となります。
- 周辺合計
- 行の合計(a + b、c + d)と列の合計(a + c、b + d)です。フィッシャーの検定ではこれらを固定します。
- 独立性の帰無仮説
- 行変数と列変数が無関係であるという仮定で、母集団のオッズ比が1であることと同等です。
- 超幾何分布
- 周辺度数を固定して非復元抽出を行ったときの、度数 a の分布です。\(P(a)=\dfrac{\binom{a+b}{a}\binom{c+d}{c}}{\binom{n}{a+c}}\)
- p値
- 帰無仮説のもとで、観測された表と同等かそれ以上に極端な表が得られる確率です。
- 片側と両側
- 片側検定は、事前に指定した単一の方向における関連を検定します。両側検定は、どちらの方向の関連も検定します。
- 期待度数
- 独立性を仮定したときの(行の合計 × 列の合計)/n です。例では、セル a の期待度数は 10 × 9/16 = 5.625 です。期待度数が小さい場合(経験則では5未満)には、フィッシャーの検定が好まれることが多いです。
- オッズ比
- (a × d)/(b × c) で、関連の強さを測る指標です。値が1の場合は関連がないことを意味します。調整をしない場合、b × c = 0 では定義されません。
- 有意水準(α)
- 帰無仮説を棄却するために事前に選ぶ閾値(多くは0.05)です。偽陽性となる確率の許容上限を表します。
よくある質問
カイ二乗検定ではなくフィッシャーの検定を使うべきなのはどんなとき? サンプルサイズが小さい場合や、いずれかのセルの期待度数が5未満の場合に使用します。こうした状況ではカイ二乗近似の信頼性が低くなるためです。
両側p値は何を意味しますか? 変数間に関連がないと仮定したとき、観測された表と同等以上に極端な表が(どちらの方向でも)得られる確率を表します。
もっと大きな表にも対応できますか? 本ツールは2×2表専用です。より大きな分割表には、一般化された正確確率検定が必要になります。