Công cụ tính VRAM cho LLM là gì?
Công cụ này giúp bạn ước tính lượng bộ nhớ đồ họa GPU (VRAM) cần có để nạp và chạy một mô hình ngôn ngữ lớn (LLM) trong giai đoạn suy luận (inference). Mức bộ nhớ phụ thuộc chủ yếu vào số lượng tham số của mô hình và độ chính xác số học dùng để lưu mỗi trọng số. Ngoài ra, một hệ số dự phòng (overhead) được thêm vào để bù cho KV cache, các activation và CUDA context — những thành phần tiêu tốn bộ nhớ ngoài phần trọng số thô.
Cách sử dụng
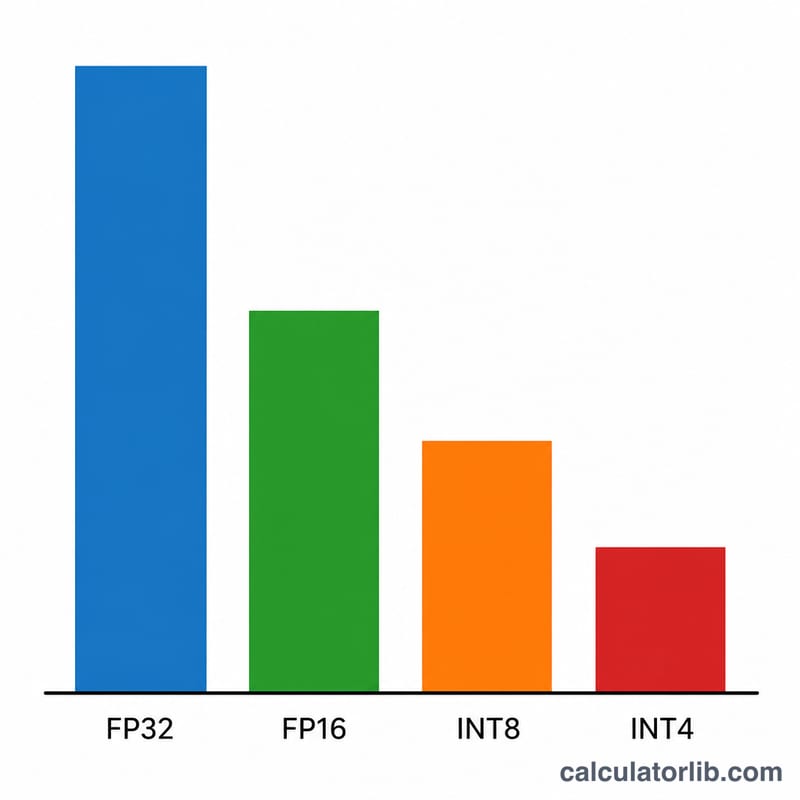
Nhập kích thước mô hình theo đơn vị tỷ tham số (ví dụ nhập 7 cho mô hình 7B, hoặc 70 cho Llama-3 70B). Chọn độ chính xác: FP32 dùng 4 byte mỗi trọng số, FP16/BF16 dùng 2 byte, INT8 dùng 1 byte, còn lượng tử hóa INT4 chỉ dùng 0,5 byte. Cuối cùng, đặt hệ số dự phòng — giá trị 1,2 (tức dư 20%) là mức mặc định hợp lý cho suy luận với ngữ cảnh ngắn; hãy tăng lên nếu bạn dùng ngữ cảnh dài hoặc xử lý theo lô (batching).
Giải thích công thức
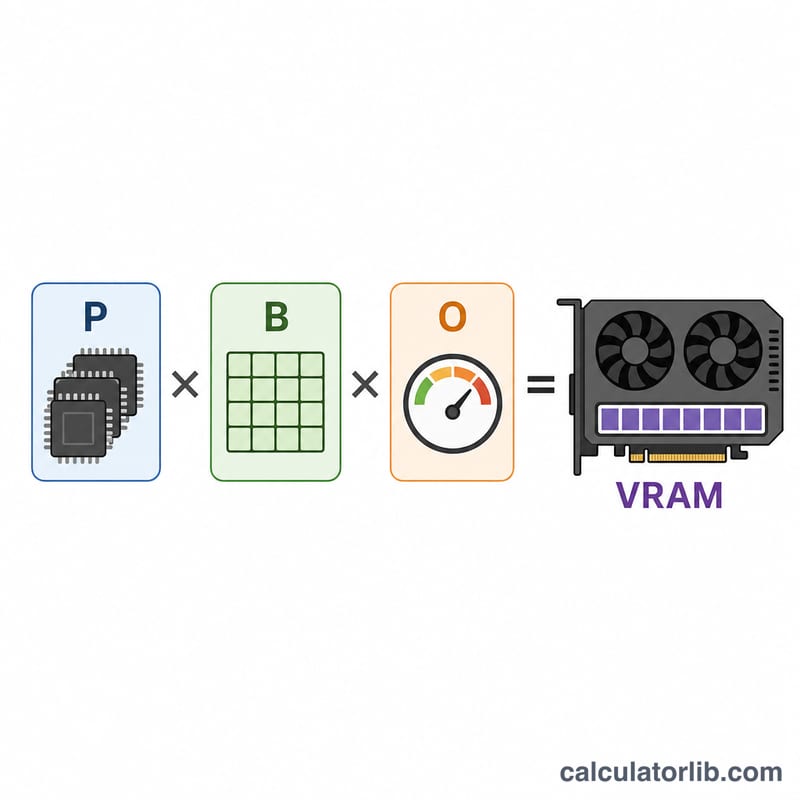
$$\text{VRAM (GB)} = \text{Số tham số (tỷ)} \times \text{Số byte mỗi tham số} \times \text{Hệ số dự phòng}$$ Vì 1 tỷ byte ≈ 1 GB, nên khi nhân số tham số (tính theo tỷ) với số byte mỗi tham số, bạn nhận được kết quả tính bằng gigabyte luôn. Hệ số dự phòng sau đó nhân thêm vào để bao trùm phần bộ nhớ phát sinh lúc chạy.
Ví dụ minh họa
Với mô hình 7B ở định dạng FP16 và hệ số dự phòng 1,2: $$7 \times 2 \times 1{,}2 = 16{,}8 \text{ GB}$$ Mức này nằm gọn trong một card 24 GB. Cũng mô hình đó nhưng ở INT4: $$7 \times 0{,}5 \times 1{,}2 = 4{,}2 \text{ GB}$$ chạy dễ dàng trên GPU 8 GB.
Ước tính VRAM cho các kích thước mô hình và độ chính xác phổ biến
Bảng sử dụng công thức của máy tính với hệ số dự phòng mặc định 1,2: \(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\). Số byte trên mỗi tham số là 2 với FP16, 1 với INT8 và 0,5 với INT4. Các ghi chú "Fits on" so sánh từng kết quả với dung lượng danh định của một GPU đơn lẻ, còn dung lượng thực tế sử dụng được thấp hơn một chút.
| Kích thước mô hình | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
Hạng GPU nào có thể chứa từng ước tính
- 7B: FP16 cần card 24 GB (16,8 GB là quá nhiều đối với 16 GB). INT8 vừa với 16 GB. INT4 vừa với 8 GB.
- 13B: FP16 cần 48 GB. INT8 (15,6 GB) chỉ vừa đủ với 16 GB, nên 24 GB sẽ thoải mái hơn. INT4 (7,8 GB) rất sát với 8 GB, vì vậy 16 GB là lựa chọn thực tế.
- 34B: FP16 (81,6 GB) vượt quá một card 80 GB đơn lẻ, nên cần nhiều GPU. INT8 vừa với 48 GB. INT4 vừa với 24 GB.
- 70B: FP16 (168 GB) cần ít nhất ba GPU 80 GB. INT8 (84 GB) vượt quá một card 80 GB, nên cần hai GPU, ví dụ 2×48 GB hoặc 2×80 GB. INT4 (42 GB) vừa với 48 GB.
- 405B: mọi độ chính xác đều cần nhiều GPU. FP16 cần ít nhất mười ba card 80 GB, INT8 ít nhất bảy, và INT4 ít nhất bốn.
Khi ước tính vượt quá bộ nhớ của một card, mô hình phải được chia nhỏ trên nhiều GPU (song song tensor hoặc song song pipeline). Khi đó, tốc độ kết nối và chi phí phát sinh trên mỗi GPU sẽ có ảnh hưởng, vì vậy cần dành thêm một khoảng dự phòng so với phép chia đơn giản.
Số byte trên mỗi tham số theo định dạng độ chính xác
| Định dạng | Số byte trên mỗi tham số | Mục đích sử dụng phổ biến |
|---|---|---|
| FP32 | 4 | Mốc huấn luyện, nghiên cứu và các tác vụ nhạy cảm về số học; hiếm khi dùng để phục vụ LLM |
| FP16 / BF16 | 2 | Suy luận tiêu chuẩn với chất lượng đầy đủ và là định dạng lưu trữ thông dụng của các checkpoint được phát hành |
| FP8 / INT8 | 1 | Phục vụ hiệu quả với mất mát chất lượng nhỏ trên phần cứng và phần mềm được hỗ trợ |
| INT4 | 0,5 | Lượng tử hóa mạnh cho suy luận cục bộ và GPU tiêu dùng, có mất mát chất lượng nhất định |
Lưu ý về định dạng 4-bit thực tế: các sơ đồ 4-bit thực tế như GGUF Q4_K_M, GPTQ và AWQ lưu trữ tỷ lệ theo nhóm và các siêu dữ liệu khác. Vì vậy, chúng dùng nhiều hơn 0,5 byte mỗi trọng số một chút, khoảng 0,55 đến 0,65. Với các định dạng này, hãy tăng nhẹ hệ số dự phòng hoặc coi kết quả INT4 là ước tính thấp hơn một chút.
Hệ số dự phòng điển hình theo trường hợp sử dụng
| Trường hợp sử dụng | Hệ số dự phòng |
|---|---|
| Ngữ cảnh ngắn, một người dùng | khoảng 1,2 |
| Ngữ cảnh dài hoặc xử lý gộp (batching) vừa phải | khoảng 1,5 đến 2,0 |
| Xử lý gộp lớn hoặc phục vụ ngữ cảnh rất dài | 2,0 trở lên |
Đây là các quy tắc kinh nghiệm, không phải tiêu chuẩn cố định. Công cụ suy luận, độ dài ngữ cảnh và số lượng yêu cầu đồng thời sẽ quyết định giá trị thực tế.
Diễn giải ước tính VRAM của bạn
Kết quả là một ước tính gần đúng, mang tính chặn dưới, dành cho suy luận. Nó tính bộ nhớ cho các trọng số và cộng thêm một tỷ lệ phần trăm cố định cho KV cache, activations, CUDA context và bộ đệm framework. Đây không phải là phép đo chính xác, và không bao gồm huấn luyện. Huấn luyện còn lưu trữ gradient và trạng thái bộ tối ưu, có thể cần gấp nhiều lần bộ nhớ.
KV cache tăng theo cách nào
KV cache tăng tuyến tính theo độ dài ngữ cảnh, kích thước batch, số lớp và kích thước ẩn của các phép chiếu key/value:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
Trong đó \(L\) là số lớp, \(d_{kv}\) là độ rộng key/value, \(T\) là độ dài ngữ cảnh tính bằng token, \(B\) là kích thước batch (số chuỗi chạy đồng thời) và \(b\) là số byte trên mỗi phần tử cache. Hệ số 2 tương ứng với key và value. Ví dụ, một mô hình dùng multi-head attention tiêu chuẩn, 32 lớp, kích thước ẩn 4096 và cache FP16 ở 4096 token cần \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) byte, khoảng 2,1 GB cho mỗi chuỗi. Các mô hình dùng grouped-query attention có \(d_{kv}\) nhỏ hơn nên cache nhỏ hơn nhiều. Với ngữ cảnh dài hoặc nhiều người dùng đồng thời, cache có thể ngang hoặc vượt quá trọng số, vì vậy hãy tăng hệ số dự phòng trong những trường hợp đó.
So sánh với bộ nhớ sử dụng được
Hãy so sánh ước tính với bộ nhớ sử dụng được của GPU, không phải con số danh định. Driver, CUDA context và màn hình (nếu GPU cũng điều khiển một màn hình) chiếm một phần bộ nhớ, và các công cụ suy luận thường dành riêng một phần phần còn lại. Một card được bán là 24 GB thường cung cấp cho mô hình ít hơn đáng kể. Nếu ước tính của bạn nằm trong vòng vài phần trăm so với dung lượng card, hãy giả định rằng nó sẽ không vừa.
Nhiều GPU
Với song song tensor, trọng số và KV cache được chia cho các GPU, vì vậy mỗi card chứa khoảng phần của nó trong tổng. Mỗi GPU vẫn có CUDA context và bộ đệm riêng, và các bộ đệm giao tiếp còn thêm vào, nên tổng trên tất cả GPU sẽ cao hơn ước tính cho một GPU đơn lẻ một chút.
Mô hình Mixture-of-Experts
Với các mô hình Mixture-of-Experts (MoE), hãy nhập tổng số tham số, không phải số tham số đang hoạt động. Chỉ một số expert chạy cho mỗi token, điều này giảm khối lượng tính toán, nhưng thông thường toàn bộ trọng số expert phải nằm thường trú trong VRAM để bộ định tuyến (router) có thể chọn bất kỳ expert nào.
Đây là thông tin chung nhằm mục đích lập kế hoạch. Hãy kiểm tra mức sử dụng thực tế bằng phần mềm và khối lượng công việc của riêng bạn.
Câu hỏi thường gặp
Vì sao mức sử dụng thực tế cao hơn phần trọng số thô? KV cache phình to theo độ dài ngữ cảnh và kích thước lô, đồng thời framework còn dành riêng bộ nhớ cho các activation và buffer — đó chính là phần mà hệ số dự phòng ước lượng.
Con số này có bao gồm việc huấn luyện không? Không. Huấn luyện cần nhiều hơn khoảng 3–4 lần bộ nhớ để lưu trạng thái optimizer và gradient; ước tính ở đây chỉ dành cho suy luận.
Nên dùng hệ số dự phòng bao nhiêu? Dùng khoảng 1,2 cho prompt ngắn, và 1,5–2,0 trở lên cho ngữ cảnh dài hoặc khi xử lý lô lớn.